
MOSS-Image 全能生图:LoRA + 提示词模板工作流实测
MOSS-Image 是 2026 年 10 月 16 日开源的文生图模型,5B 参数的单流 DiT 主干,配 Qwen3.5-9B 文本编码器,主打的不是「又一个 SD 换皮」,而是复杂中英文文字渲染 + 布局控制——海报、信息图、带字插画这些别的模型容易崩的题材,它恰恰是最稳的那一批。
但模型刚放出来那几天,社区对它的评价很平淡:人像一般,细节偏油,姿势容易崩。真正让它翻身的,是一个后加的 LoRA。
这篇把「Kohaku 的 MOSS-SFT LoRA + 百 KB 级提示词扩写模板 + ComfyUI 全能生图工作流」整套拆开讲清楚:LoRA 到底修了什么、节点该怎么连、25 步 / CFG 3.0 为什么够用、本地部署最容易在哪一步报错。
点击按钮跳转 · 链接直达 · 无需提取码
一、先说结论:它到底值不值得上
一句话:MOSS-Image 本身是「文字能力最强的一批开源底模」,配上 Kohaku 的 LoRA 之后,基本补齐了人像和姿势这两个短板,可以当作全能型模型用;唯一的硬伤是它不做局部编辑,改图得靠别的工具。
拆开看三件事:
- 底模强在文字,不在审美。 MOSS-Image-Base 是纯 Base 模型,没做过后训练、也没做 CFG 蒸馏,官方推荐 steps ≥ 50、CFG 3.0~6.0、Shift 5.0、Euler 采样,并且专门实现了 Skip Layer Guidance(跳过负向分支的第 22 层)。它的强项是长提示词(支持 4K token)和文字排版,官方评测里长文本覆盖率平均 96.3%。
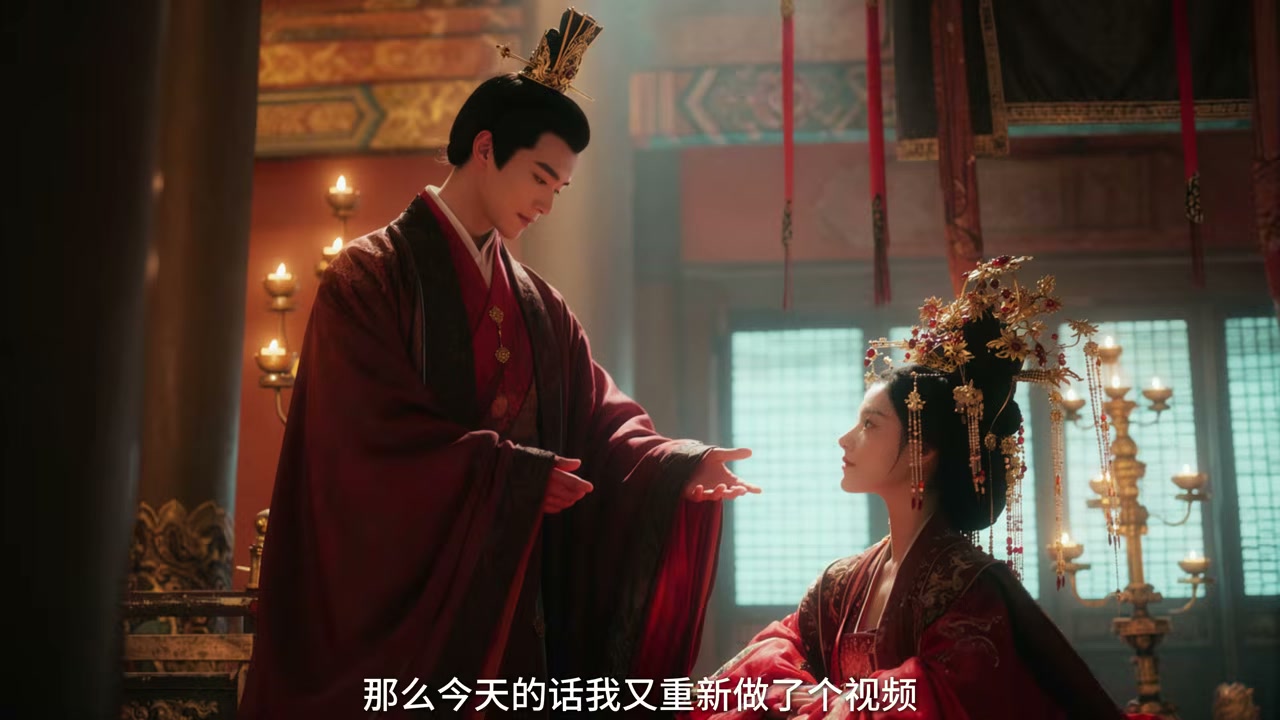
- LoRA 补的是「人味」。 社区后续发布的 MOSS-SFT LoRA 修掉了两个最刺眼的问题:一是人物姿势/肢体崩坏,二是皮肤和布料的「油腻感」。加上之后人像质感提升非常明显。
- 提示词是胜负手,不是模型。 这套工作流真正的核心其实是那份上百 KB 的提示词扩写模板——模型对提示词的要求比多数底模高,提示写得越准,出图越接近你想要的东西。
二、LoRA 到底改了什么
工作流里 LoRA 加载器的参数长这样:
| 节点 | 参数 | 值 |
|---|---|---|
| LoRA 加载器(仅模型) | LORA 名称 | MOSS-SFT-2027_5.safetensors |
| 模型 | MOSS-SFT-2027_5 |
|
| 权重强度 | 1.00 |
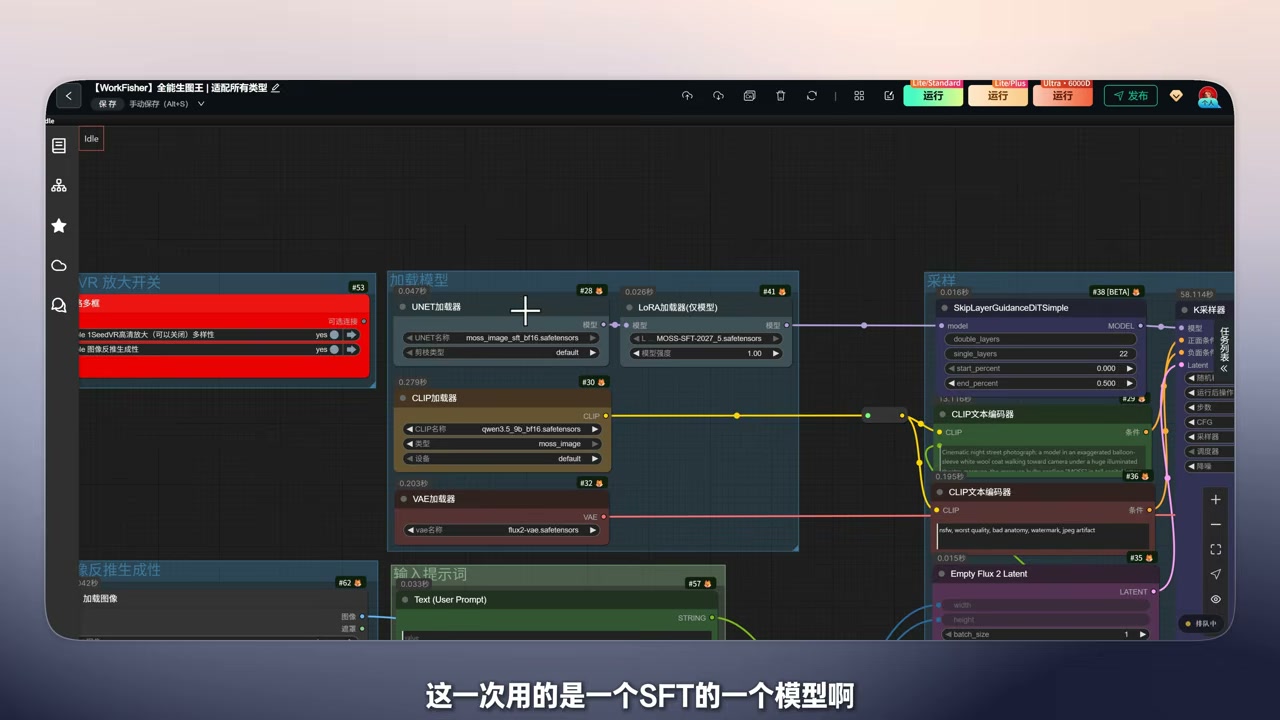
模型主体用的是 SFT 版(moss_image_sft_bf16.safetensors)。这一点值得强调:目前社区的共识是 SFT 版比 Base 版更值得日常使用,Base 版更偏「可再训练」的定位。
LoRA 的作用可以理解成两处:
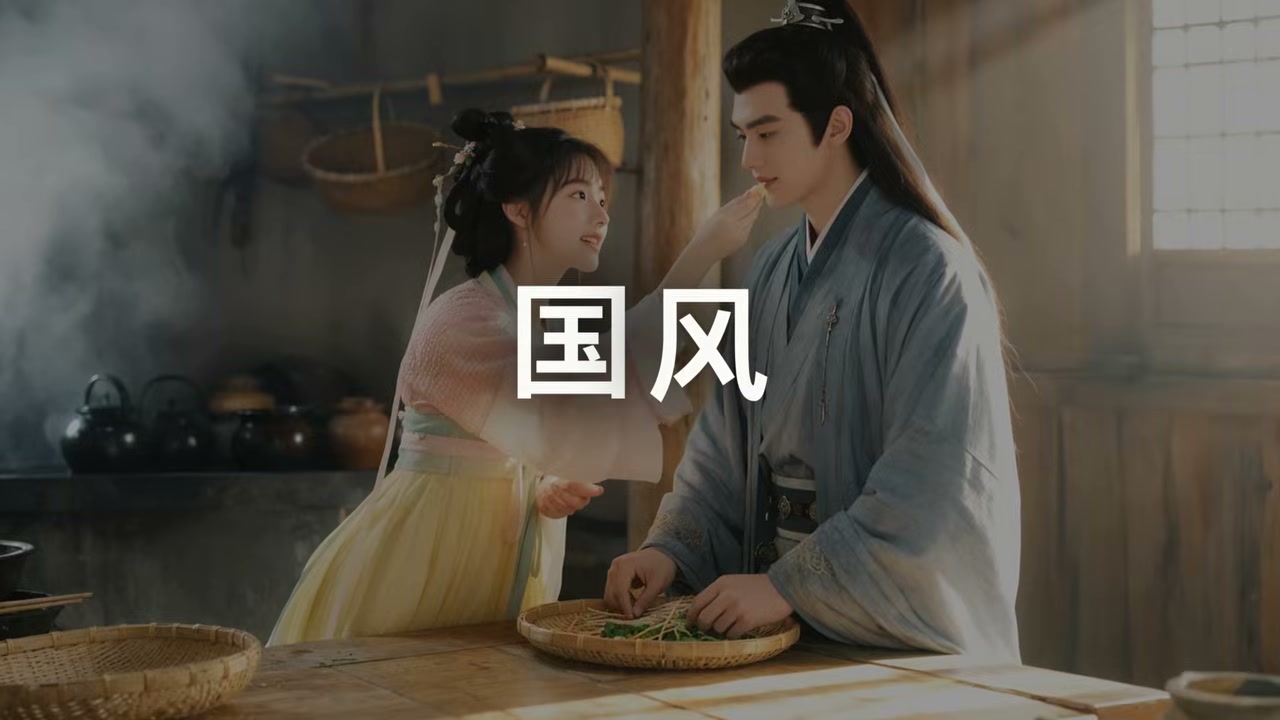
- 摆人:多人群像、双人互动这类场景,原版经常出现手部畸形、关节扭曲、人物穿模;加 LoRA 之后这些情况基本消失。
- 去油:原版皮肤和塑料感材质偏「油腻」,LoRA 把皮肤质感、衣料褶皱、发丝细节拉回到更接近真实摄影的水平。
不要随便换别的 LoRA。 现阶段针对 MOSS-Image 的通用 LoRA 效果普遍不理想,社区实测结论是:要么用 Kohaku 这一套,要么不用,别叠一堆来路不明的适配器。
三、能力盘点:哪些题材稳,哪些是雷区
跑完一轮下来,覆盖面确实很广:
| 题材 | 表现 | 说明 |
|---|---|---|
| 人像 / 单人写真 | ★★★★★ | LoRA 加持后质感提升最明显的一类 |
| 多人群像 | ★★★★☆ | 多人同框不再崩,但人数越多越不稳 |
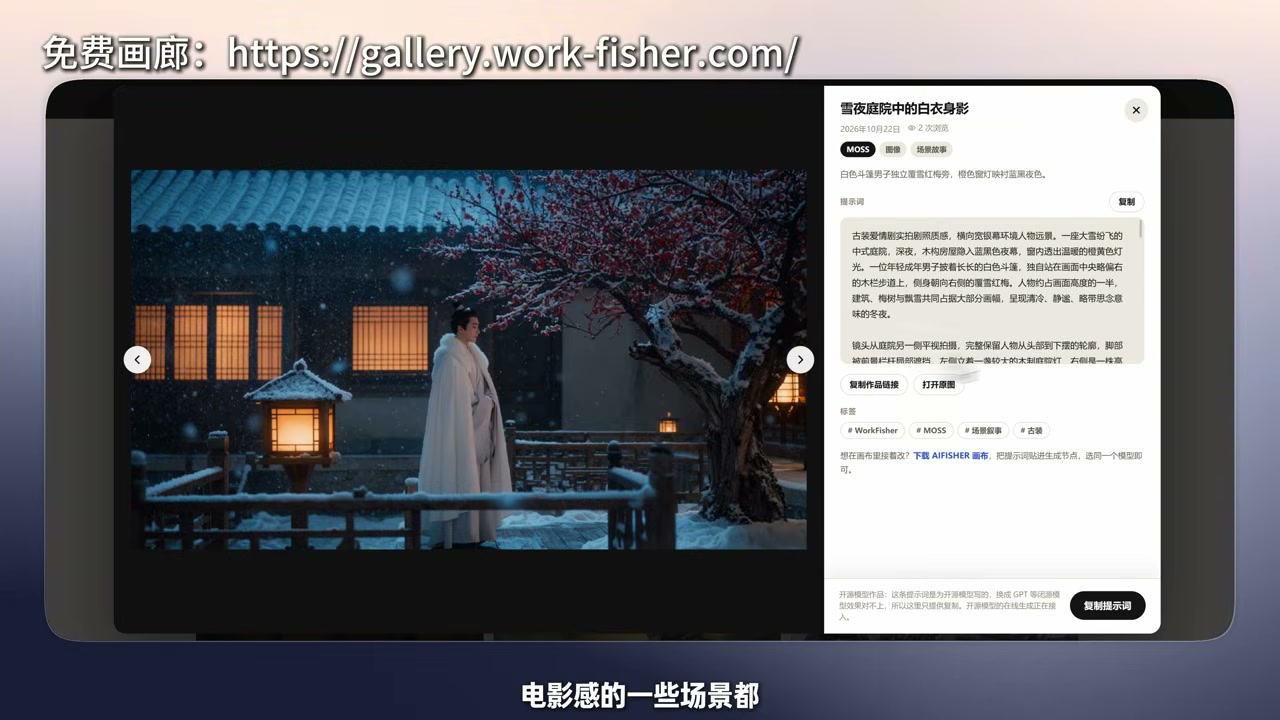
| 电影感场景 | ★★★★★ | 光影、氛围、镜头语言都能还原 |
| 巨物 / 尺度奇观 | ★★★★★ | 靠提示词描述比例与遮挡关系,表现很稳 |
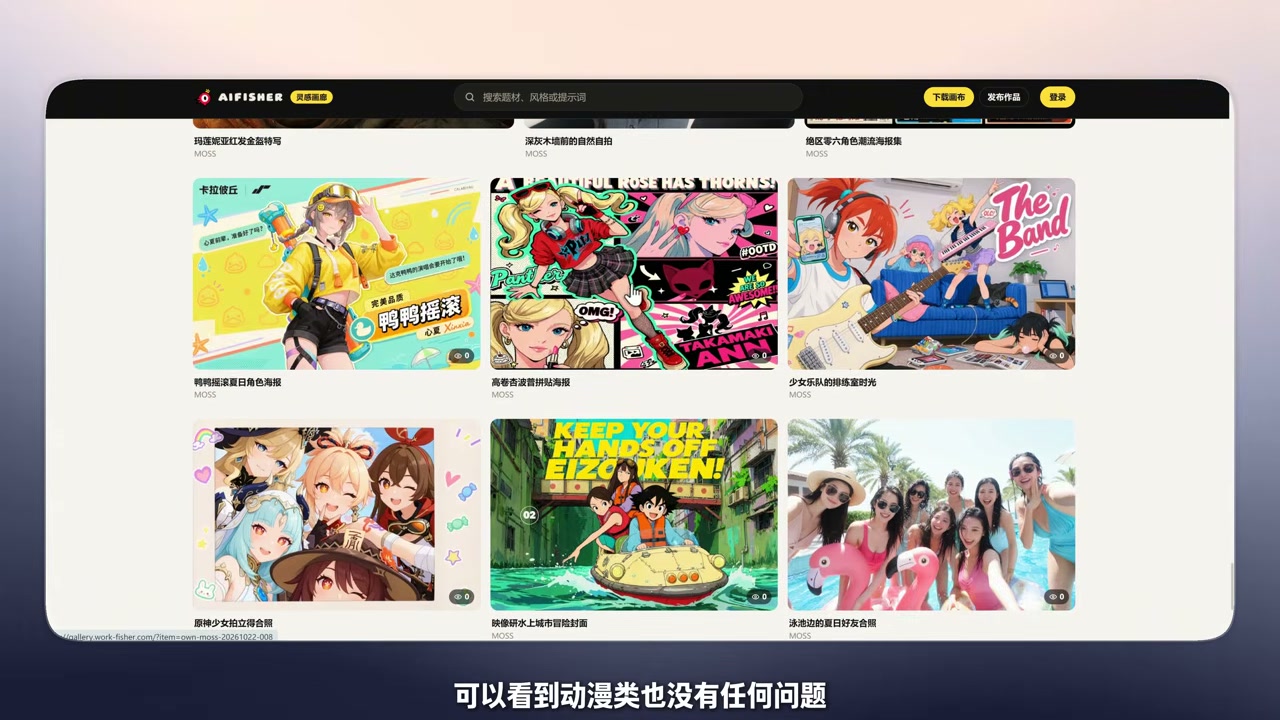
| 动漫 / 二次元 | ★★★★☆ | 知识库更新,新作角色也能认出来 |
| 海报 / 带字排版 | ★★★★★ | 这是 MOSS-Image 的主场,文字渲染是核心卖点 |
| 局部编辑 / 改图 | ★☆☆☆☆ | 唯一的硬伤,它本质是纯文生图模型 |
多人场景不崩这点尤其值得单独说。MOSS-Image 的布局控制(JSON bbox 输入)加上长提示词能力,让「两个具体的人 + 明确的动作关系 + 明确的空间关系」能同时成立,这是很多底模做不到的。
海报类能出好,靠的是模型的文字渲染能力:它能生成清晰可辨的英文和中文,并且支持自动换行。需要精确控制换行位置时,官方建议在提示词里手动写 \n。
四、提示词扩写:整套方案里最被低估的一环
这是很多人看完会忽略、但实际上决定成败的部分。
MOSS-Image 对提示词的依赖非常强。一句「两个女生在咖啡店喝咖啡」直接喂进去,出来的东西会很空;而当提示词被扩写成 1500~2500 字、逐条写清镜头取景、人物造型、服装材质、环境痕迹、主辅光关系之后,出来的画面才是「可用级别」。
4.1 提示词扩写 Skill
对应的开源项目是 fisher-moss-prompt-expander,它做的事情是把一句话 / 一张参考图 / 一条修改要求,扩写成可以直接复制使用的详细中文提示词:
- 自由创作默认交付约 1500—2500 中文字的完整长稿,分 10~15 个自然段,每段承担不同视觉信息(取景裁切 → 人物造型 → 手部与接触 → 环境层次 → 光色材质)。
- 内部按「单主体 / 双人互动 / 多人群像 / 环境主导」四种骨架路由,再叠加巨物尺度、动作法术、海报版式、角色设定板等模块。
- 参考图模式下以可见画面为依据还原,不编造被遮挡的部分。
安装方式是把 skills/fisher-moss-prompt-expander 整个目录复制到 Agent 的技能目录(Codex 一般是 ~/.codex/skills/),然后用 $fisher-moss-prompt-expander: 调用。
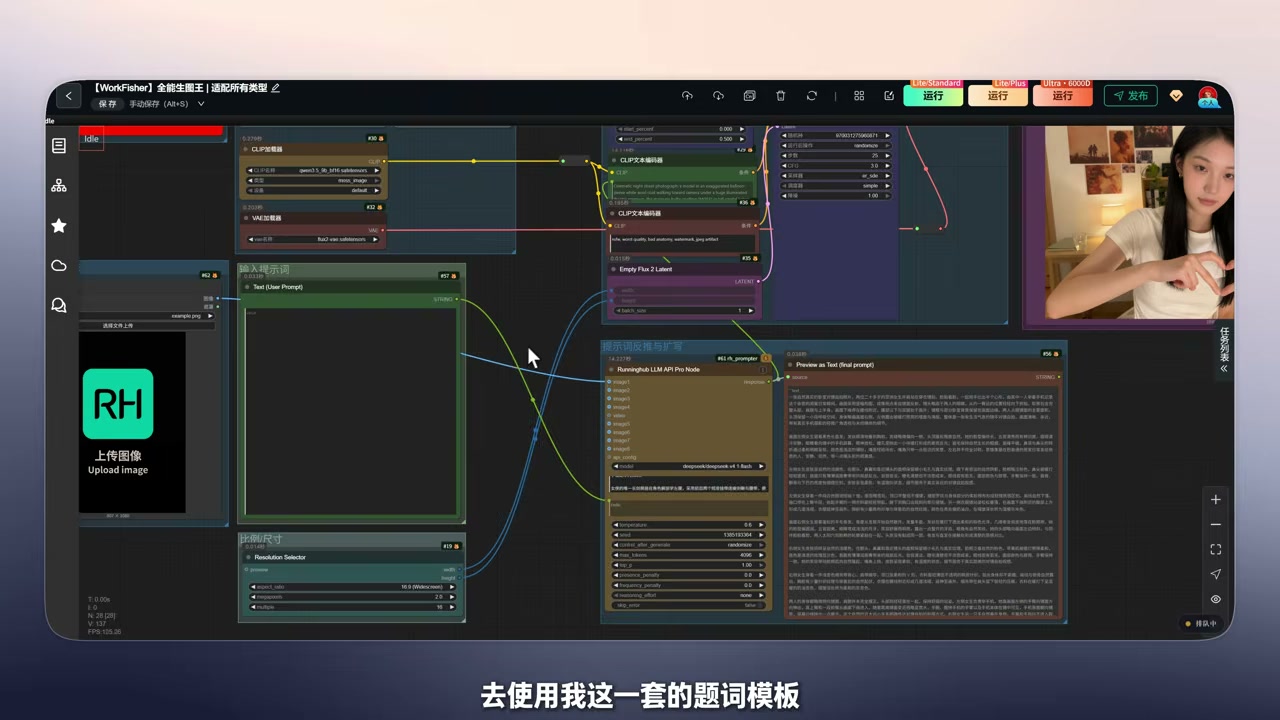
项目同时提供一份 ComfyUI 精简执行模板,把全文粘到文本扩写节点的 system_prompt 里,产出英文 Caption 直接接正向提示词——这条路给不想装 Skill、只想在 ComfyUI 里跑的人用。
4.2 为什么本地小模型撑不住
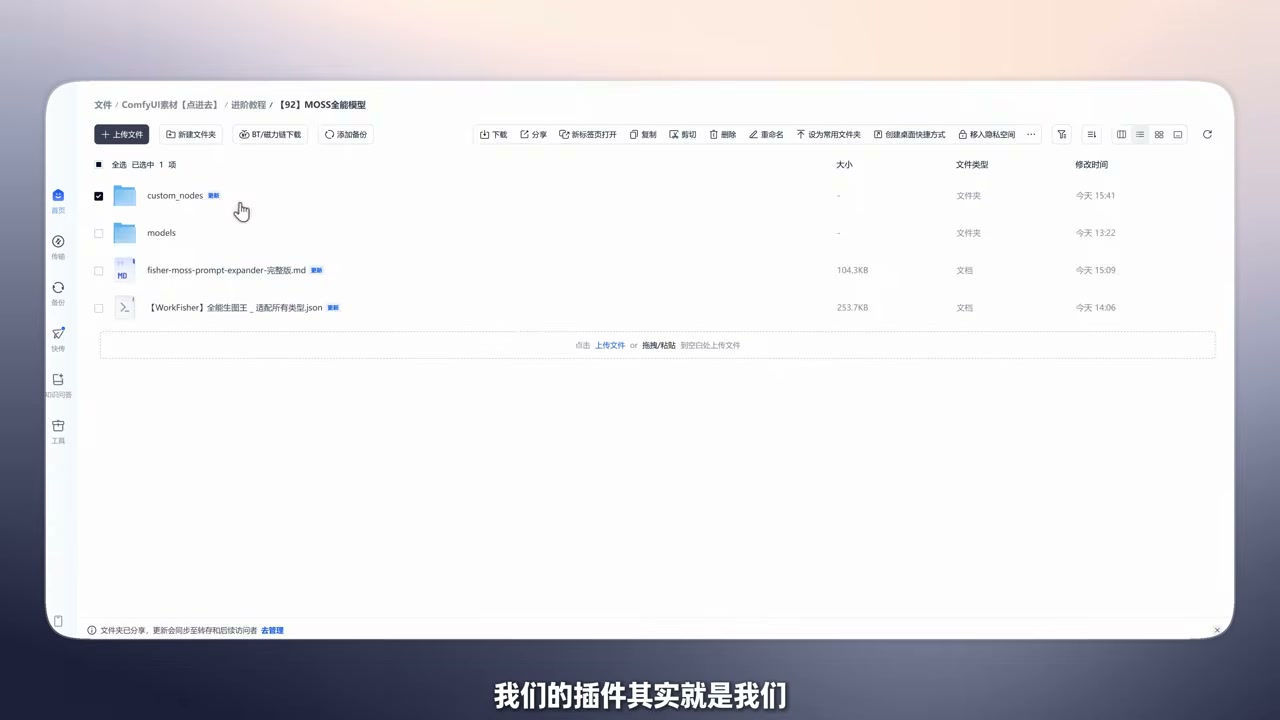
这是实测里最关键的一条:这套模板本体就有上百 KB(网盘里那份 fisher-moss-prompt-expander-完整版.md 显示 104.3 KB),要塞进小参数量的本地 LLM 里做改写,上下文压力大,生成质量明显掉链子。
所以推荐做法是:扩写这步交给云端大模型,本地只负责加载 MOSS-Image 出图。
五、完整工作流拆解
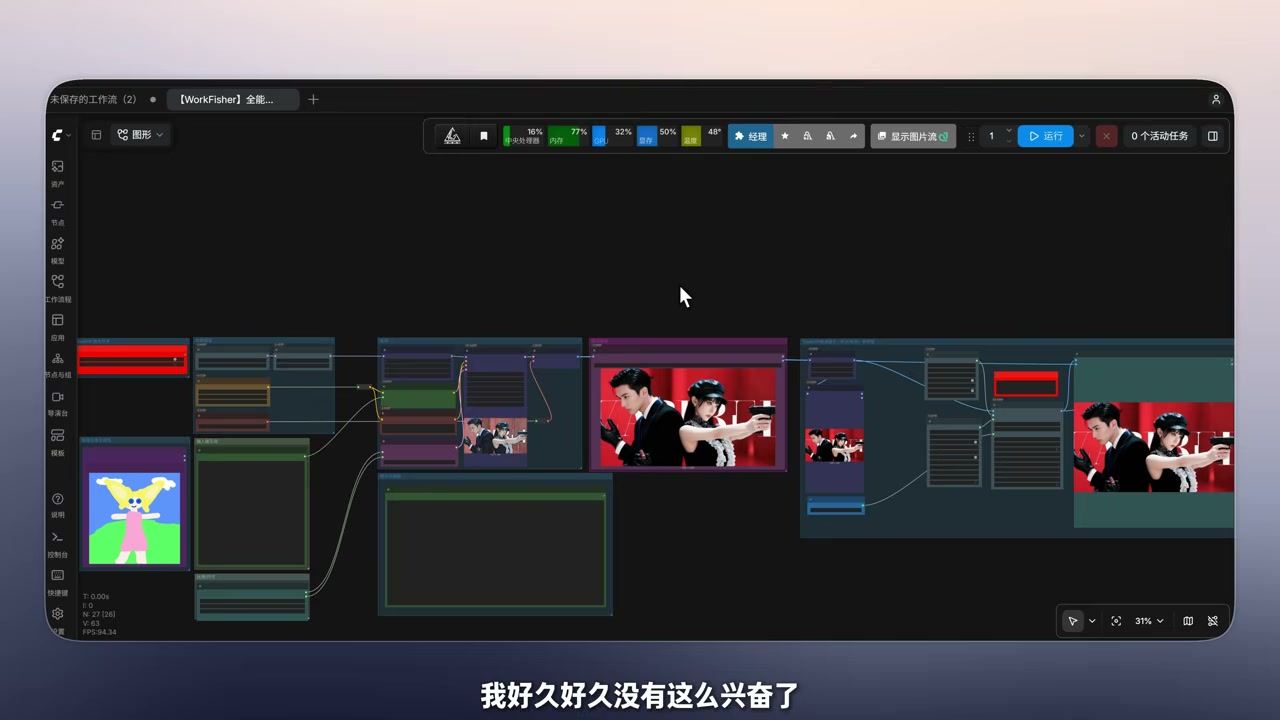
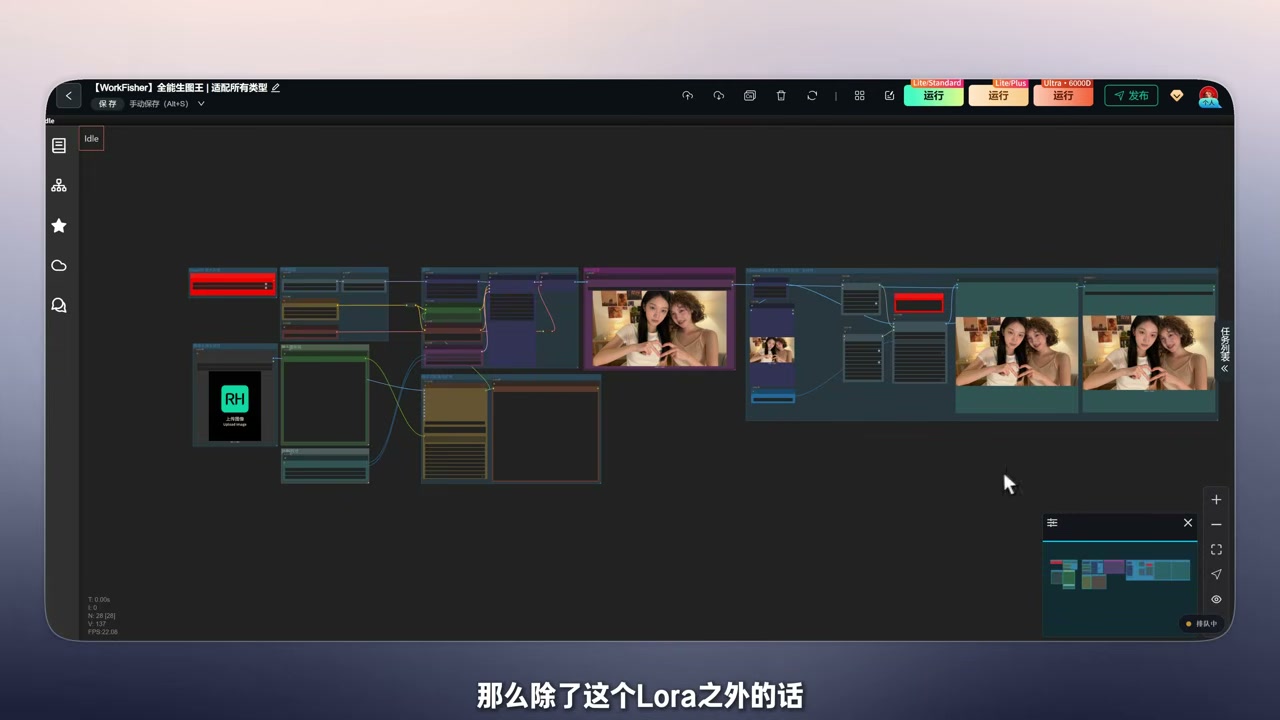
云端版(RunningHub 上的「全能生图王」)一共 25 个节点,拆开看其实很清晰。
5.1 模型加载四件套
| 节点 | 参数 | 值 |
|---|---|---|
| UNET 加载器 | UNET 名称 | moss_image_sft_bf16.safetensors |
| LoRA 加载器(仅模型) | LORA 名称 | MOSS-SFT-2027_5.safetensors(强度 1.00) |
| CLIP 加载器 | CLIP 名称 | qwen3_5_9b_sft16.safetensors |
| 类型 | moss_image |
|
| VAE 加载器 | VAE 名称 | flux2-vae.safetensors |
注意 CLIP 的类型必须选 moss_image,选错类型会直接加载失败。
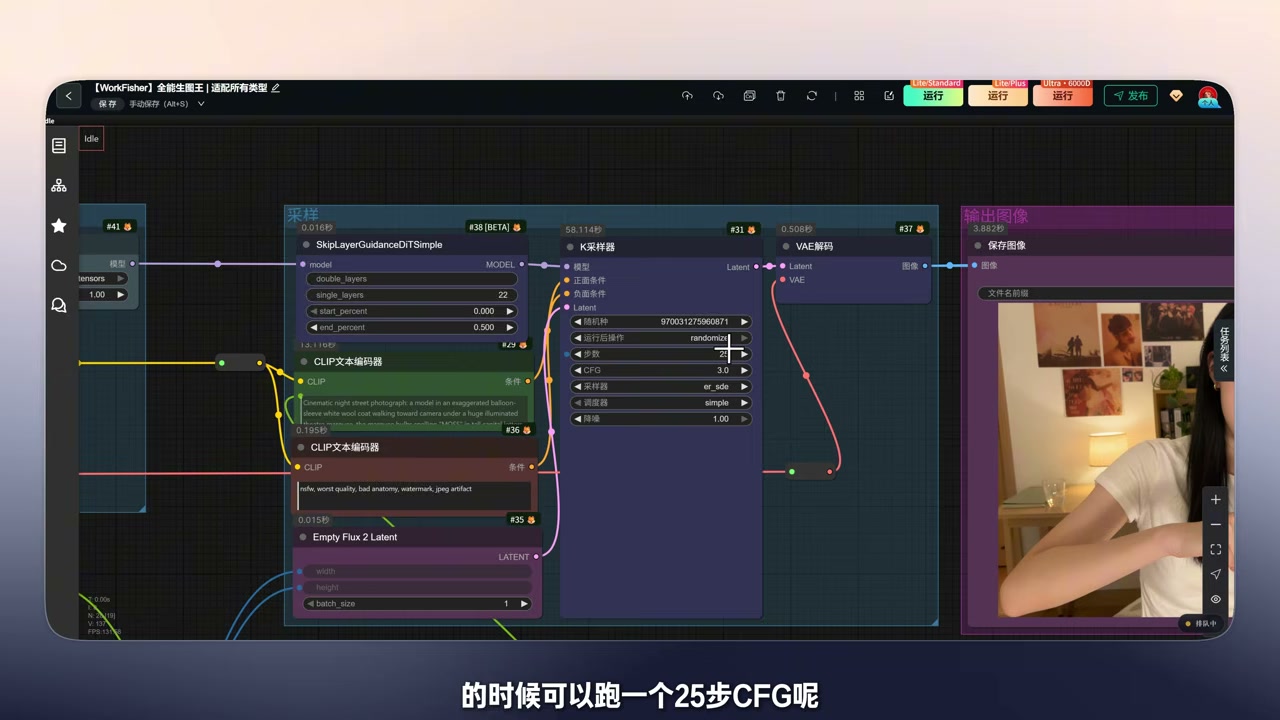
5.2 采样器与 SLG
| 节点 | 参数 | 值 |
|---|---|---|
| KSampler | steps | 25 |
| cfg | 3.0 |
|
| sampler | euler |
|
| scheduler | simple |
|
| denoise | 1.0 |
|
| SkipLayerGuidanceDiTSimple | single_layers | 22 |
| start_percent | 0.000 |
|
| end_percent | 0.500 |
|
| CLIP 文本编码器(负向) | 负面提示词 | oil, worst quality, bad anatomy, watermark, jpeg artifact |
SLG 的 single_layers = 22 和官方推荐一致(22 / 24 / 26 层都有帮助)。官方同时提醒:关掉 SLG 会让画面过于真实、细节反而崩坏,所以这个开关别乱关。
5.3 采样步数怎么定
- 25 步是默认甜点,速度和质量的平衡点,绝大部分场景够用。
- 出现人物渲染不足、轻微肢体崩坏时,把步数往上调,50 步理论上最好。
- CFG 在 3.0 ~ 3.5 之间调;提示词长、主体复杂可以往上,3.5 以上容易过饱和。
5.4 分辨率
官方推荐按总像素数而不是宽高来定:1M / 1.5M / 2M 像素为最佳区间,外推范围是 0.25M(512×512)到 4M(2K)。工作流里用 ImageScaleToTotalPixels 节点把分辨率对齐到总像素,再用 Resolution Selector 挑长宽比。
宽高必须是 16 的正整数倍,否则直接报错。
5.5 放大与 LLM 节点
1SeedVR2 高清放大(可关闭):出图后接 SeedVR2 做放大与再采样,是画面细节的主要来源之一。RunningHub LLM API Pro Node:调用云端大模型做提示词扩写 / 图像反推,面板里可以自选模型(默认是 DeepSeek 系),温度 0.6、top_p 1.0、max_tokens 4096、上下文 114048。
六、四种实际玩法
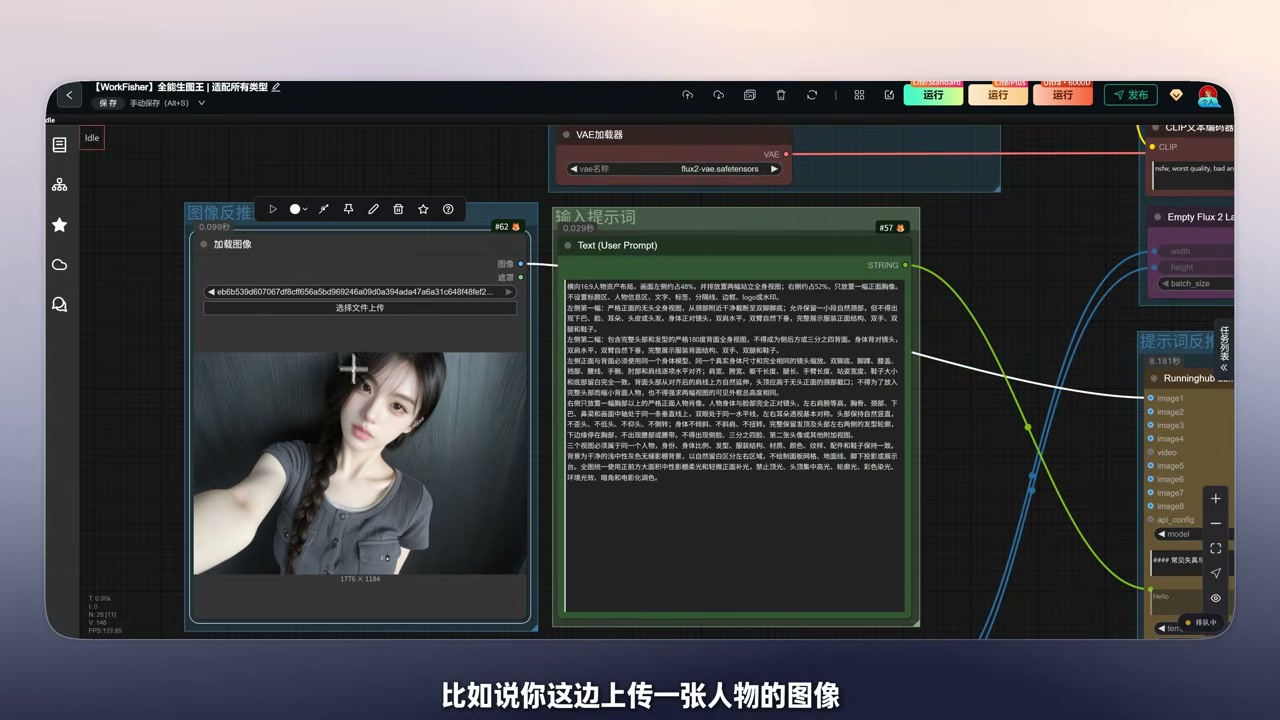
6.1 图像反推:上传一张图,自动生成复刻提示词
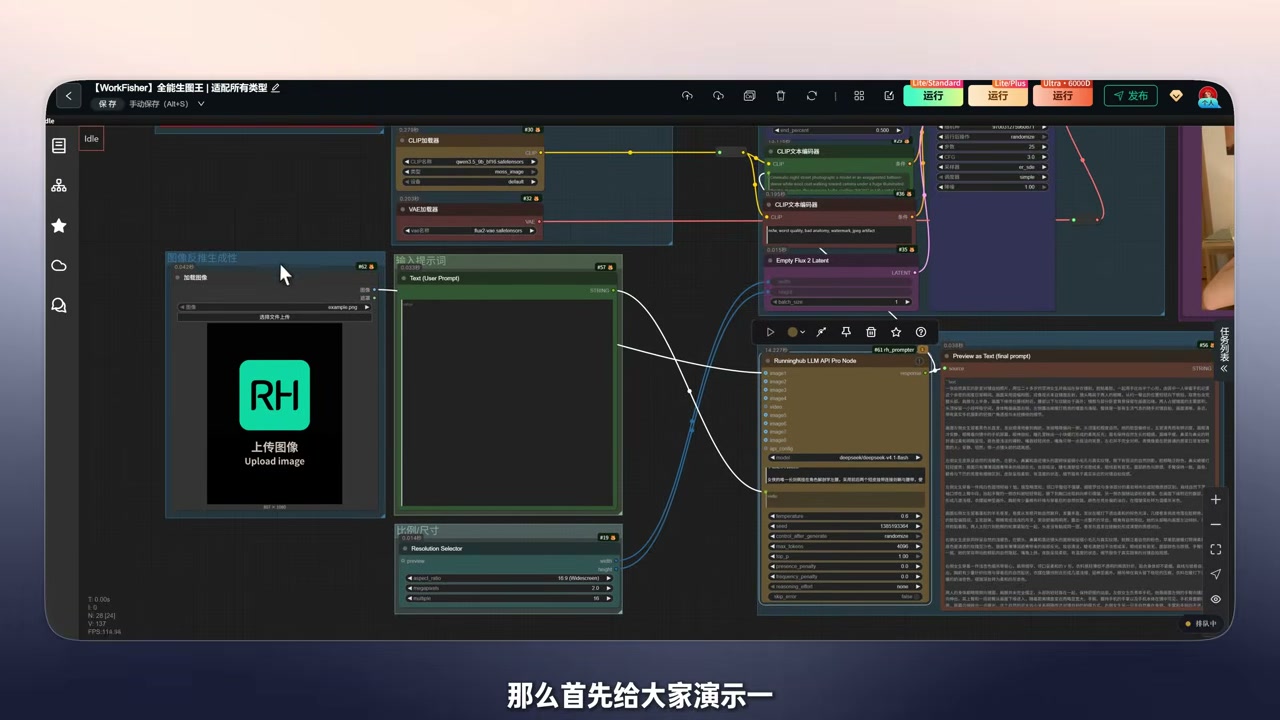
上传参考图 → 调整比例 → 点生成 → LLM 节点自动写出一大段详细提示词 → 直接喂给 MOSS-Image 出图。
这条路的价值在于:你不用会写提示词。只要有一张满意的参考图,就能把它拆成结构化描述再复刻。
6.2 反推 + 定向修改
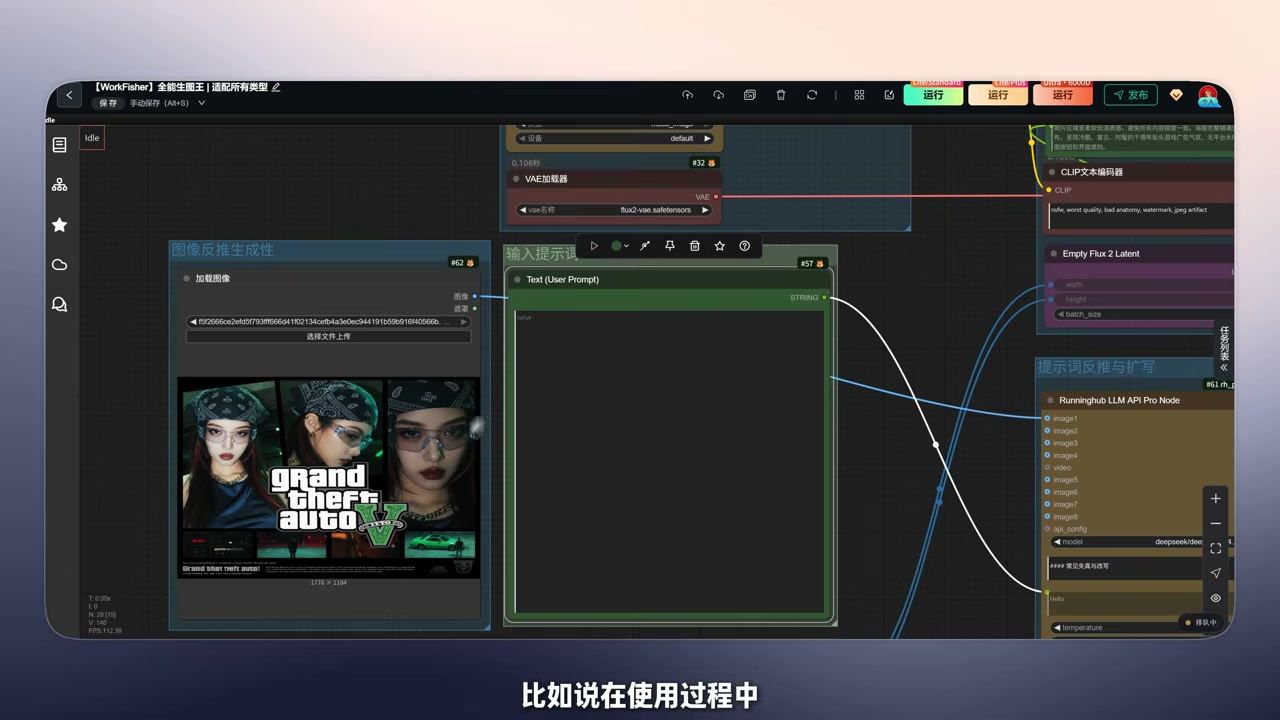
在反推出来的提示词上继续改就行。比如参考图里有 GTA 风格的 Logo,直接在提示里写「不要 GTA 的 Logo,换成别的符号」,扩写时会把这条约束同步进最终提示词。
文字本身也能改——海报类需求里,想让标题换一句话,改提示词就行。
6.3 人像生成:一句话扩写成完整画面
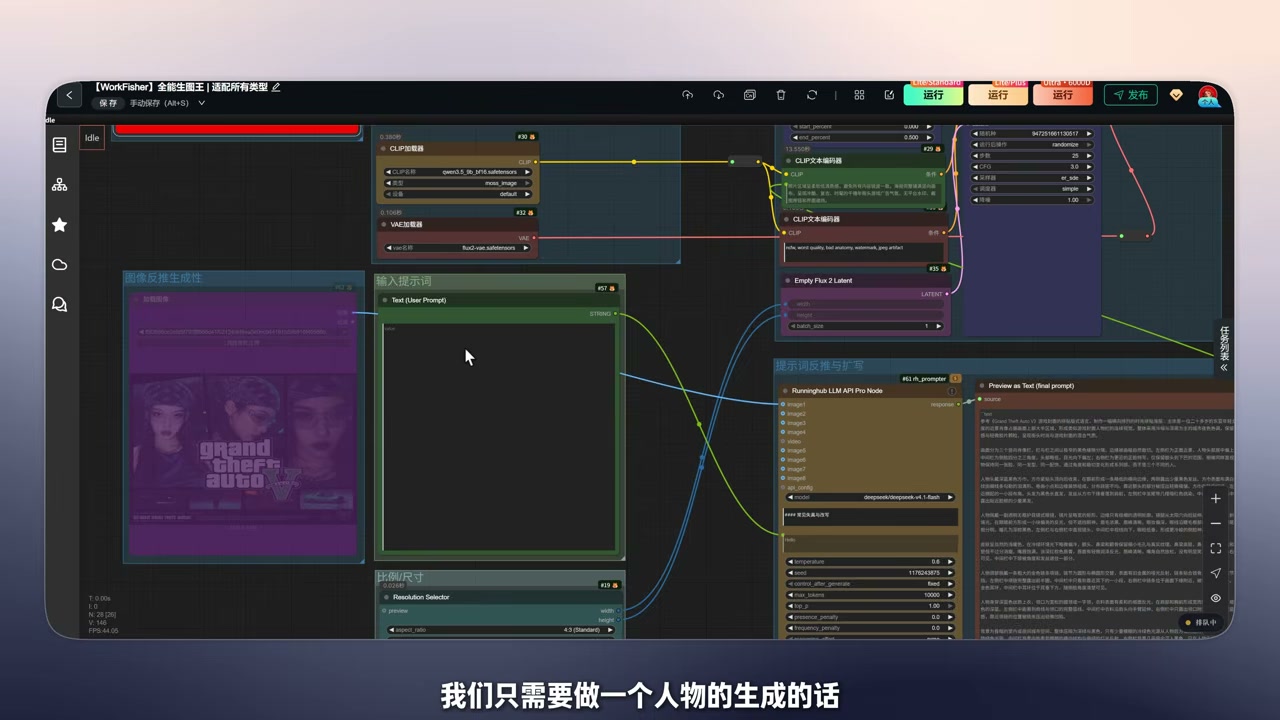
写一句简单描述(比如「一个女生在咖啡店自拍」),扩写节点把它变成 1500 字以上的完整画面描述,再出图。实际观感是:同样的人像题材,加上 LoRA 之后皮肤质感和五官细节明显比原版干净。
6.4 人物设定图:角色图 + 三视图合成
上传一张角色形象图,再叠一张该角色的「公格图」(多视角设定板),两者结合就能得到风格统一的人物设定图。做角色卡、做漫剧分镜前期,这条比纯文字描述稳定得多。
目前这套合成还是演示阶段,更完整的公格图写法还在整理中。
七、本地部署避坑清单
这是踩坑最集中的部分,按顺序检查:
- 必须更新 ComfyUI 到支持 MOSS-Image 的版本。 MOSS-Image 的原生支持在 2026 年 10 月 16 日合入 ComfyUI master(commit
e087d8f6之后),而当时的v0.41.3正式版还不包含这个支持。不更新的话,CLIP 模型大概率直接报错——这是最高频的失败原因。 - 删掉 Mixlab 一类的第三方插件。 有人反馈更新 ComfyUI 之后界面出现断线、整个前端渲染异常,排查下来是某个 Mixlab 插件引起的,删掉即可恢复正常。
- 原生工作流不要和旧插件工作流混用。 从旧工作流切到原生支持时,不能只换模型加载节点——原生模型用了不同的 timestep multiplier,原来插件工作流里的
ModelSamplingSD3节点必须换成ModelSamplingAuraFlow(multiplier 1)。 - 反向提示词别删。
oil这个负面词是针对原版油腻感准备的,即便上了 LoRA 留着也无害。 - 显存不够就降分辨率或关掉放大。 官方给了三种显存模式(GPU 常驻 / 组件调度 / 顺序回退),最后一种最省显存但更慢。
网盘里已经把插件、模型(含 LoRA、CLIP、VAE)、提示词模板、工作流 JSON 全部打包好了:
八、我的判断
该用的人: 需要做海报、信息图、带字配图的人;做角色卡 / 漫剧分镜前期、需要长提示词精确控制的人;以及愿意折腾 LoRA 和工作流的 ComfyUI 老手。
先别上的人: 只想「打几个字就出图」的,MOSS-Image 的提示词依赖会让这条路径很痛苦;需要局部编辑 / 改图的,它帮不上忙;只有 8G 显存又不想折腾的,建议先用云端。
为什么值得试: 它把「长文本 + 布局 + 文字」这三件事同时做对了,这是绝大多数开源底模还在互相卷画质、但文字一写就崩的当下,少见的组合。加上 LoRA 之后补齐人像和姿势,基本盘已经齐了。
后续值得盯的两件事: 一是官方推进的 DMD 少步蒸馏(目标是压到 8 步甚至更少,直接解决速度问题);二是社区已有的 8 步 DMD 蒸馏版和 6GB 显存可训的微调框架,都在把门槛往下压。
九、上手 Checklist
- ComfyUI 升级到含 MOSS-Image 原生支持的 master / nightly
- 删掉 Mixlab 类冲突插件
- 模型:UNET
moss_image_sft_bf16+ LoRAMOSS-SFT-2027_5(强度 1.0)+ CLIPqwen3_5_9b_sft16(类型moss_image)+ VAEflux2-vae - KSampler:euler / simple / 25 步 / CFG 3.0 / denoise 1.0
- SLG:single_layers 22,start 0.000,end 0.500(别关)
- 负面提示词保留
oil, worst quality, bad anatomy, watermark, jpeg artifact - 分辨率按总像素 1M~2M 选,宽高取 16 的倍数
- 提示词扩写走云端大模型,别指望本地小模型扛百 KB 模板
- 肢体崩就把步数往 30 / 50 调
总结
MOSS-Image 的定位很清楚:一个把「文字和布局」做到极致的 5B 开源底模。刚开源时因为人像平庸被低估,直到 Kohaku 的 SFT LoRA 补上了摆人和油腻两个硬伤,它才真正变成一个能当主力用的全能模型。
而让它从「能看」变成「能用」的,是那份上百 KB 的提示词扩写模板——模型给你能力上限,提示词决定你能不能摸到那个上限。25 步、CFG 3.0 这套参数不是玄学,是绕开原版崩坏点、同时保住速度的折中方案。
想继续往下挖,站内这两篇能直接接上:
- 《Fisher Pose 终极版:Qwen2.1 姿势与机位编辑器实测,8G 显存跑通》 —— 如果你要更精细地控制人物姿势与机位,这条比提示词硬写更稳。
- 《MiniMax H3 终极工作流:DMAD 加速 LoRA + 单节点二采,12 步跑通文戏武戏》 —— MOSS-Image 出静帧,接视频模型做动态,是目前最顺的一条生产线。
- 《MiniMax H3 武打视频生成工作流:12G 显存跑开源视频模型的工程拆解》 —— 如果最终要落到动作连续性上,视频那一端的工程细节在这篇。
你在用 MOSS-Image 时踩过什么坑?或者想看某个题材(海报 / 角色卡 / 巨物)的完整提示词对照?欢迎在评论区贴出来,一起把它调得更稳。
实用资源
- OpenMOSS/MOSS-Image(GitHub) —— 官方仓库,含 Base / SFT 权重、用户指南与 ComfyUI 说明。
- MOSS-Image 技术报告(arXiv:2610.23374) —— 5B 单流 DiT、PE 模块与 LLTB / RLA 评测细节。
- Work-Fisher/fisher-moss-prompt-expander(GitHub) —— 提示词扩写 Skill、ComfyUI 模板与精选案例。
- KohakuMossTrainer(GitHub) —— MOSS-Image 的 LoRA / LyCORIS 训练框架,6GB 显存可训适配器。
- WorkFisher 全能生图王(RunningHub) —— 云端版工作流,免显卡直接跑。
- 灵感画廊 · 资料站 —— 完整提示词与全部工作流地址。
版权与许可提醒:MOSS-Image 权重遵循 Apache-2.0;提示词 Skill 与工作流同样以 Apache-2.0 发布,但工作流里引用的第三方 LoRA、角色与素材各有各的授权,商用前请单独确认。