MiniMax H3 终极工作流:DMAD 加速 LoRA + 单节点二采,12 步跑通文戏武戏
最近一个月,MiniMax H3 社区的加速 LoRA 与二采节点同时迎来了一轮密集更新——很多之前测试过的工作流,现在都该重写一遍了。把这一轮最值得关注的改动整理到一起:字节团队新出的 DMAD 4 步加速 LoRA、Step600 与 DMAD 融合后的「混合加速 LoRA」、一份把二采封装进单个 ComfyUI 节点的新型实现,以及把速度滑块、武戏组合 LoRA 全部装进同一基础框架的全新工作流——跑通这套参数表之后,12G 显存也能直出 1080P、10 秒视频。
下面是从工程角度拆出来的实战经验,可以直接对到 ComfyUI 节点上落地。文戏与武戏的参数模板已实测多轮,直接抄即可。
一、为什么还要再写一次 H3 工作流
MiniMax H3 是 MiniMaxAI(MiniMax)2026 年 7 月底开源的通用全模态视频生成模型,默认输出 768p,最高可生成 15 秒、2K、原生双声道音频。详见我们之前做过的工程拆解:《MiniMax H3 武打视频生成工作流:12G 显存跑开源视频模型的工程拆解》。
开源一个月以来,围绕 H3 的生态件大致分成三类:
- 加速 LoRA:解决「默认 50 步」实测太慢的问题,从早期的 Step600 一枝独秀,到 8 步 / 4 步 Turbo LoRA 百花齐放。
- 二次采样(二采)节点:把 768p 输出直出到 1080p / 2K,目前主流分「外部二采」和「内部二采」两条技术路线。
- 武戏 / 高动态 LoRA 组合:用单独的物理 / 运动学 LoRA 弥补 H3 默认在剧烈运镜下「模糊 / 撕裂」的短板。
但绝大多数组合方案要么油腻、要么高动态糊片、要么显存爆掉,真正能跑通文戏和武戏两种场景的工作流并不多。本文给出的工作流在一台 12GB 显存的 RTX 显卡上实测可用,是当下兼顾画质、速度、稳定性的一个均衡点。
二、工作流总览
整体设计与官方基础工作流保持一致,只对几个关键节点做替换:
| 区域 | 上一期 | 本期 |
|---|---|---|
| 主模型 | H3 Base (2549) | H3 Base (2549) ← 不动 |
| 加速 LoRA | Step600 | DMAD + Step600 融合版 (0.8) |
| 注意力加速 | 第三方 | 官方 Linear-Attention 节点 |
| 武戏 LoRA 组合 | 无 | 四只兔子 · 速度滑块 + 武打组合 |
| 二采实现 | 两阶段传统二采 | 单节点内嵌二采(银老 GitHub 项目) |
| Latent 放大 | 单一放大模型 | LMS(更锐利) |
| 整合包 | 自制 | 基于秋叶 ComfyUI 3.2 稳定版 |
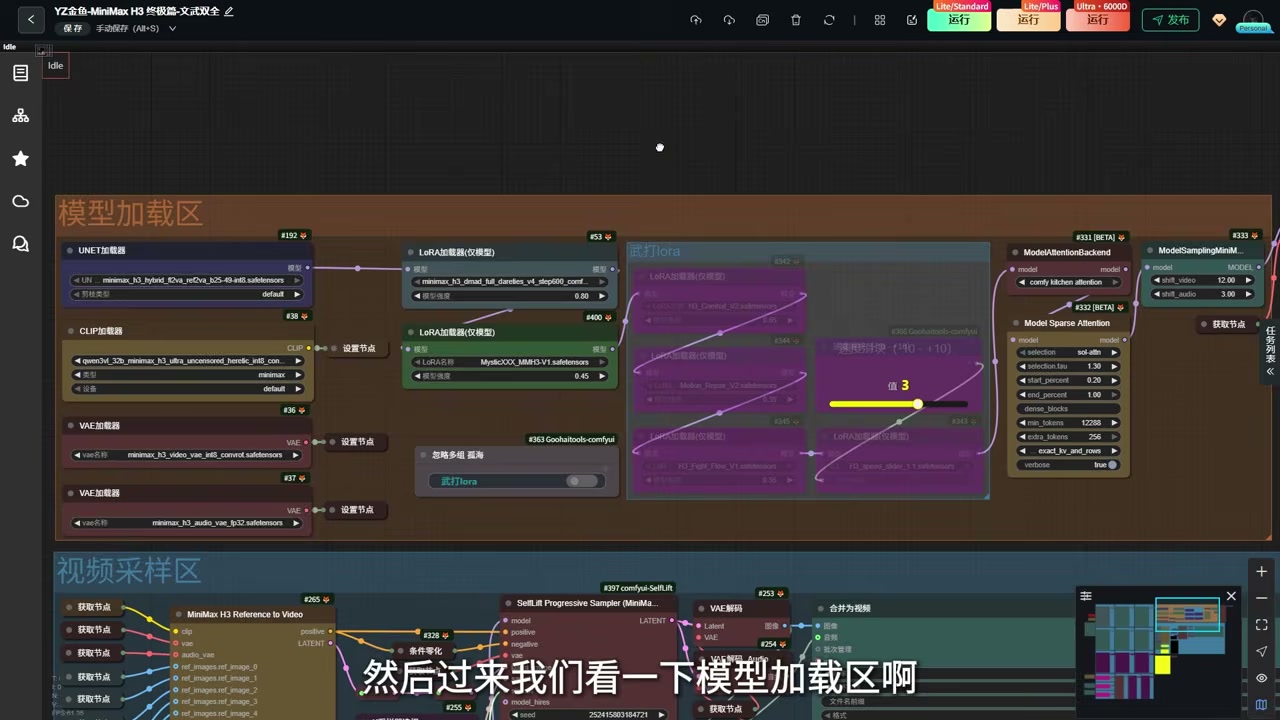
资源参考区(图像 / 音频 / 视频)和官方版完全一致,只需把不需要的参考用开关关掉,不再赘述。
三、加速 LoRA:从 Step600 到 DMAD + 融合版
3.1 Step600 仍是最稳的基线
Step600 是上一期工作流里推荐的加速 LoRA,4 ~ 8 步出图,提示词遵从度和画质明显比早期 Turbo 系更稳——本期内置它作为兜底:如果对效果不满意,把它单独拉高到 0.9 ~ 1.0 仍然能拿到一份可用的基础出片。
3.2 字节 DMAD:4 步真拟合
字节(MiniMax?)团队近期新开源的 DMAD 加速 LoRA 是这个月最大的变量。它的特点是「真 4 步」——宣传 4 步就真的 4 步能拟合,不需要像别的 LoRA 那样偷偷补到 6 ~ 8 步才好用。优点是不油腻;缺点是:
- 高动态运镜下 4 步显然不够用,会出现运动模糊或帧间不一致。
- 提示词遵从度、整体画质仍逊于 Step600。
3.3 Step600 × DMAD 融合加速 LoRA
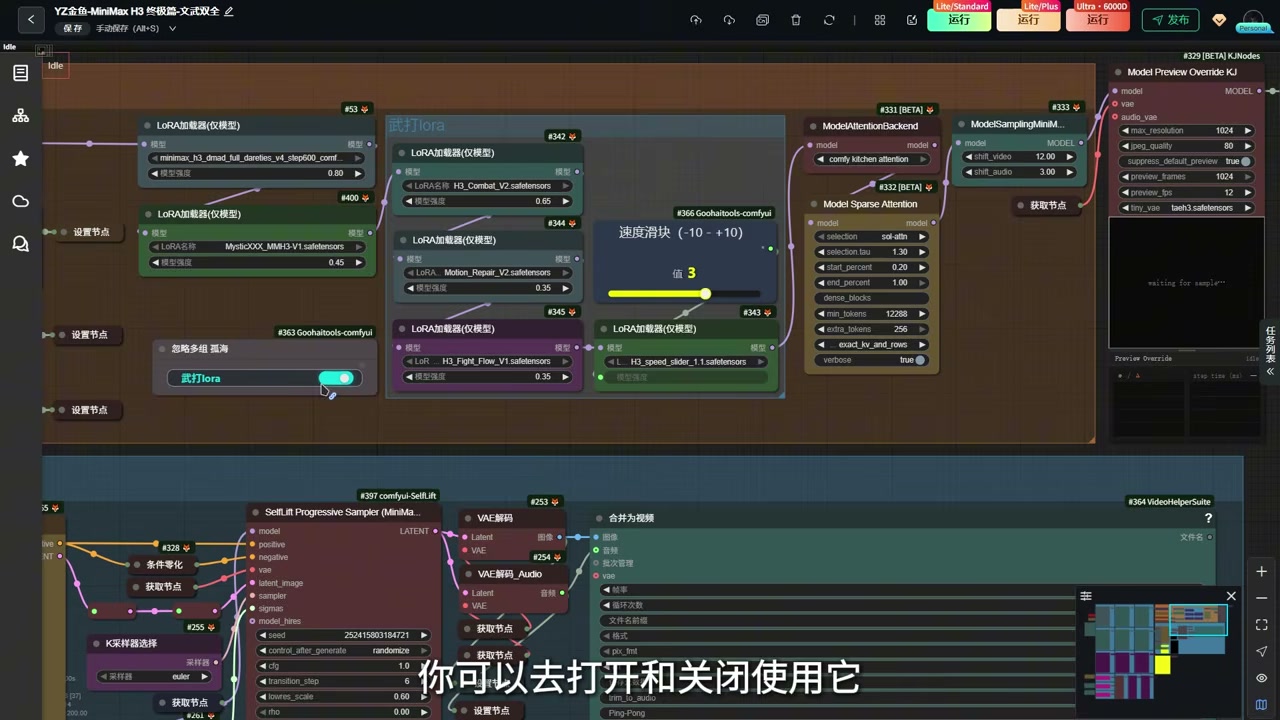
Civitai 上一位作者给出了方案:把 DMAD 和 Step600 两个 LoRA 权重融合,得到一个同时具备「4 步拟合速度」与「Step600 画质 / 提示词遵从度」的混合加速 LoRA。这是这版工作流默认开启的加速器。
| 参数 | 推荐值 | 注意事项 |
|---|---|---|
| 强度 | 0.8 | 超过 1.0 会有过拟合 + 轻微油腻感,作者明确不建议 |
| 是否叠加 | 不再叠 Step600 / DMAD 单独使用 | 融合版内部已包含二者 |
| 文戏 / 武戏通用 | ✅ | 与武戏 LoRA 同时使用无冲突 |
实测把融合版调到 0.7 在文戏里会更细腻,但默认 0.8 仍是大多数场景的甜点位。
3.4 去油腻 LoRA 仍然保留
上一期推荐过的「去油腻 LoRA」依然内置,但默认关闭。融合加速版出片大多数场景不油腻,关掉即可;若切换单 LoRA 出图觉得油腻,可以再次把它打开。这是保险栓,而非必选项。
四、武戏的救星:四只兔子 · 武打 + 速度滑块
H3 在高动态武戏场景下「会看动作但运镜崩」是老问题。这次整套工作流专门接入了一组由 B 站 UP 主 四只兔子 制作的武戏 LoRA 组合,通过节点上的一个开关启用:
- 武术 LoRA:补充真实物理感与受力反馈,补全高动态运镜。
- 空间物理 LoRA:防止人物在剧烈运镜下「穿帮 / 飘」。
- Camera Motion LoRA:让运动镜头本身符合运动学逻辑。
三个 LoRA 一起叠是甜点位,搭配融合加速 LoRA 出片最稳。
4.1 速度滑块 LoRA:±10 调节
这套组合里最有趣的额外加载是一个微型 速度滑块 LoRA,可以把武打 / 文戏的动作速度做 -10 ~ +10 范围内的连续调节:
- 滑块越往右(+),动作越快。
- 滑块越往左(-),动作越慢。
- 不建议超过 ±5:超过 5 后动作节奏容易过快或过慢、画面失真。
- 默认值 3:文戏 / 武戏都适用的均衡档位。
五、官方原生注意力加速 + 预览节点
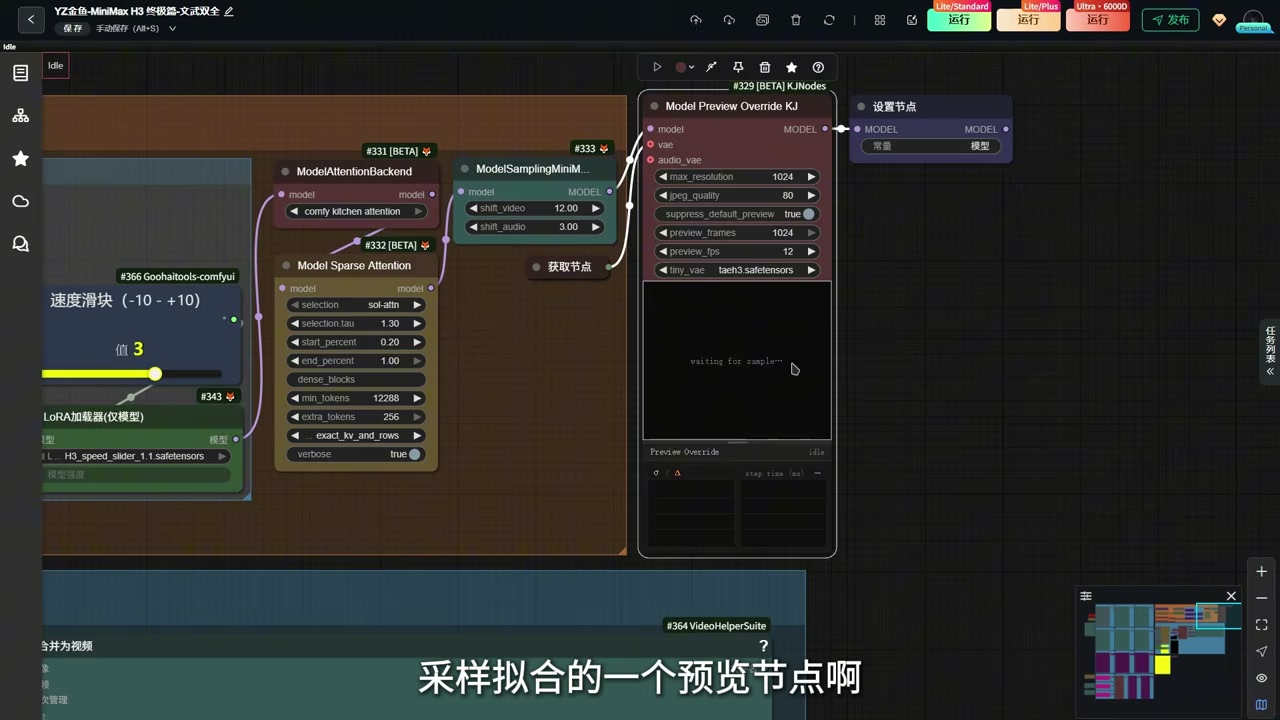
这一版放弃了此前接入的第三方注意力加速节点,改用 ComfyUI 官方新增的 Linear Attention 加速节点。实测下来仍是当前最稳的注意力加速方案,整体出图时长还能再省一截。
顺带一个推荐:把官方的 KG 拟合预览节点 接入到一采采样器前面,可以在采样的过程中实时显示收敛轮廓,出大问题(比如 LoRA 强度开错、内容跑偏)能提前止损,不用等完整步骤跑完才发现翻车。
六、单节点内嵌二采:一份节点代替两份
6.1 之前是怎么做二采的
传统的「外部二采」要分两步走:先用 768p 跑完整数生成低分辨率视频,再用单独的 upscale 节点把它升到 1080p。两步走的好处是逻辑清晰,坏处是节点多、出错点也多,显存常常先爆后救。
6.2 这次的单节点内嵌二采
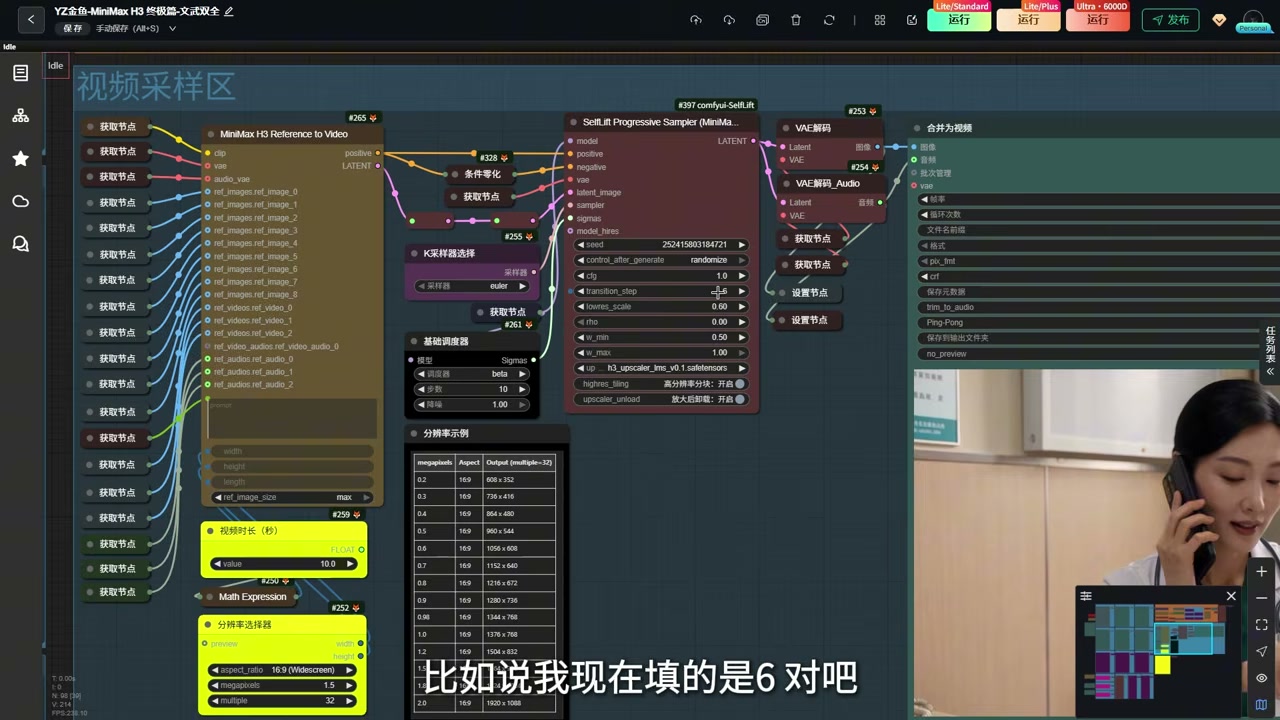
银老在 GitHub 上发布了一个把外部二采两阶段合并进同一节点的实现——只需要在一采执行到中间步时,自动切换分辨率并继续跑到目标步数。整条流水线从两个采样器 + 一个 upscale 节点,收敛为 一个采样器节点。
这个内嵌二采节点最关键的两个旋钮是:
| 参数 | 含义 | 本期默认 |
|---|---|---|
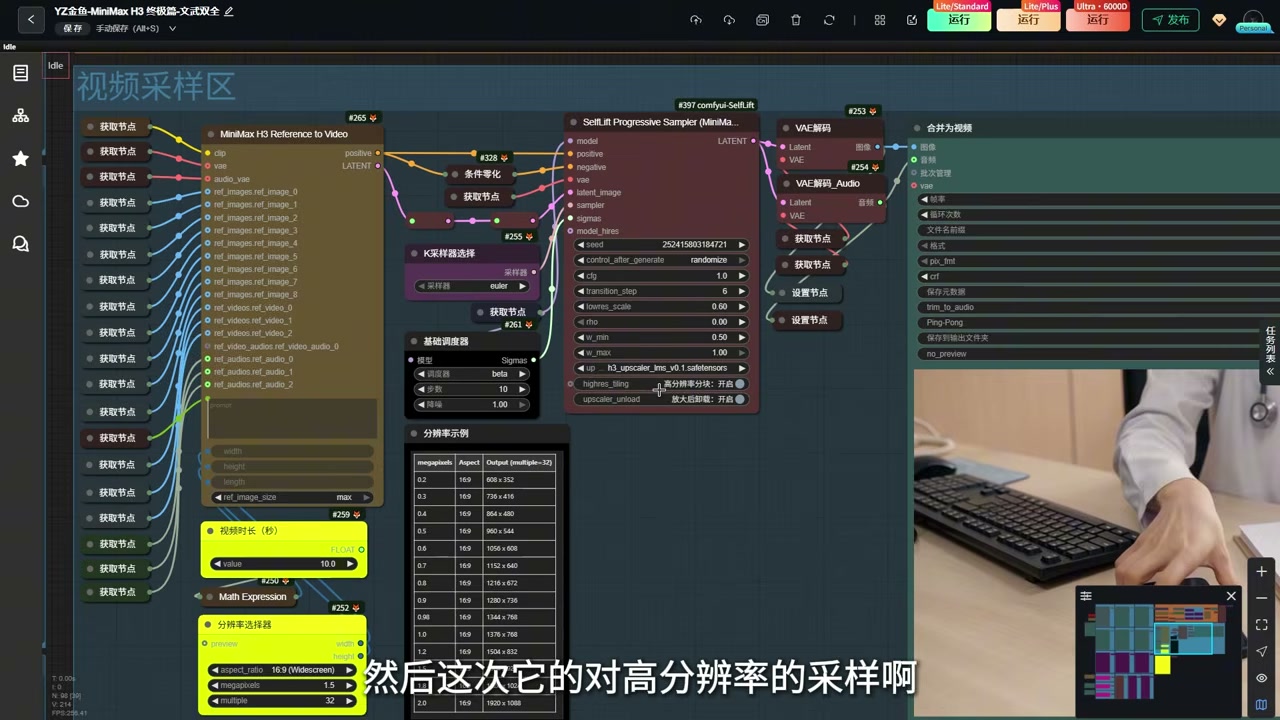
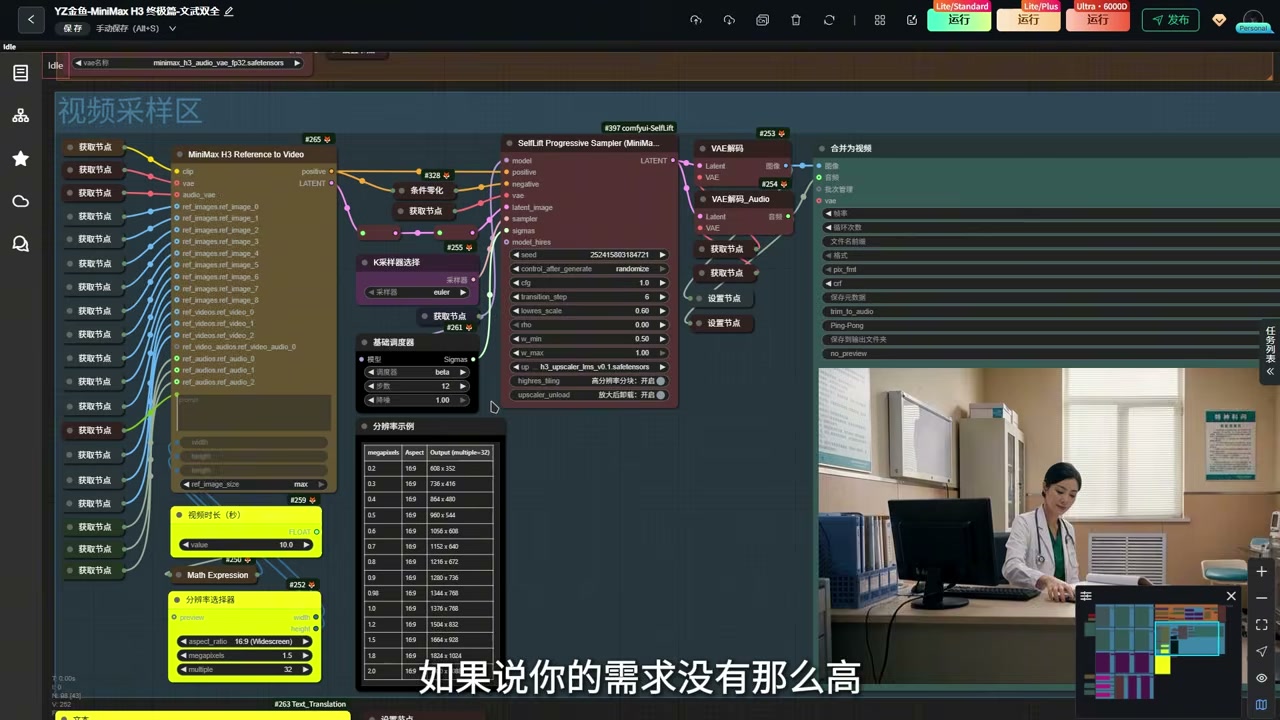
| 总步数 | 一采 + 二采加起来的所有去噪步数 | 文戏 10 / 武戏 12 |
| 一采步数 | 单独留给一采的步数(剩下的会自动分给二采) | 文戏 6 / 武戏 6 |
| 一采分辨率 | 一采阶段使用的相对分辨率 | 0.60(≈ 1056×608) |
| 二采分辨率 | 二采阶段的最终分辨率 | 1.5×(文戏充足;武戏建议 ≥ 1.8×) |
简单算就是:二采步数 = 总步数 - 一采步数。
6.3 二采再升级:LMS 放大模型
Latent 放大模型本期换成 LMS,实测出片比默认版更锐利:
- LMS 主打保留细节(锐边、纹理、字迹),不会出现传统放大模型的「橡胶感」。
- 在一采 0.60 + 二采 1.5+ 的二段式放大下,1080p 出片有肉眼可见的清晰度差。
6.4 参数模板速查
经过多轮实测,下面的两组参数模板可以直接抄:
文戏(追求速度 / 偏好细腻):
| 项 | 值 |
|---|---|
| 总步数 | 10 |
| 一采步数 | 6 |
| 二采步数 | 4(自动) |
| 一采分辨率 | 0.60 |
| 二采分辨率 | 1.5 |
| 速度滑块 | +3 |
武戏(追求动作清晰 / 高动态):
| 项 | 值 |
|---|---|
| 总步数 | 12 |
| 一采步数 | 6 |
| 二采步数 | 6(自动) |
| 一采分辨率 | 0.60 |
| 二采分辨率 | 1.8(甚至 2.0) |
| 速度滑块 | +3 |
想再快一些,可以把文戏改成总步 8 / 一采 4 / 二采 4;1.5 倍分辨率做文戏够用,极端情况 1.2 倍也完全 OK。
七、整合包 & 部署要点
7.1 整合包拆分:主体 + 工作流 + 模型
本期最大的部署变化是整合包不再打包成一个文件,而是拆成三块:
- 主体包:基于秋叶大佬的 ComfyUI 3.2 稳定版,只装环境、依赖、空白工程。
- 工作流文件:已经写好的
.json工作流,放到 ComfyUI 工程根目录直接加载。 - 模型文件夹:H3 Base、Step600、DMAD 融合版、武戏 LoRA 组合、LMS 放大器,分层目录。
「小白」流程三步走:先下主体包 → 解压 → 把模型包覆盖到对应目录 → 加载工作流即可出片。
7.2 RunningHub 云端部署的两个坑
云端部署本期的两个常见误区:
- 应用版本只支持文戏:RunningHub 上同时上架了「应用」和「工作流」两个版本。应用版是封装好的极简界面,但因为武戏 LoRA 开关在 UI 上无法外置,做武戏必须切回工作流版本。
- 跑得慢的本机,云端更划算:实测本地跑 10 秒视频 5 ~ 6 分钟出片的参数,在云端能做到 ~ 3 分钟;且云端无显存 / 启动环境差异,失败率明显更低。
八、出片效果实测
下面这段是融合加速 LoRA + 单节点内嵌二采 + 武戏 LoRA 组合全开,在 1.5× 二采分辨率下实测出片的画质指标:
- 清晰度:1080p 直出,无可见糊片,人脸面部纹理清晰。
- 运动学一致性:镜头切换 / 高动态运镜无穿帮,运动主体在帧间贴合物理轨迹。
- 油腻度:默认参数出片不油腻;切换更激进的提示词后,可通过去油腻 LoRA 再降一档。
- 音频:原生立体声输出与画面相位一致,BGM / 人声 / 音效分轨可被识别。
时间计算:文戏 10 步 / 1.5×,出片时长 5 ~ 6 分钟;武戏 12 步 / 1.8×,出片时长 10 ~ 12 分钟。
九、写在最后:工作流只是基座
这一版工作流的真正价值不在参数,而在「它是一份基座」——剩下的事情(长视频拼接、首尾帧过渡、参考图生视频、数字人)都可以在这套 12 步流程上继续生长,而不必每加一个能力就要重写一次工作流。
把更多精力放在剧本、镜头设计、提示词撰写上,反而比反复折腾工程节点更划算——这才是这版「终极篇」工作流想要解决的真正痛点。
如果你对 MiniMax H3 的官方接口、Ref2VA 全参考模式、社区其它衍生工作流也感兴趣,可以参照:《MiniMax H3 武打视频生成工作流:12G 显存跑开源视频模型的工程拆解》。AI 视频生成每周都有新动向,想要持续追踪行业动态,欢迎订阅 RSS / 邮件推送。
实用资源
- MiniMax H3 官方仓库(MiniMaxAI/MiniMax-H3) — 模型权重、提示词 Skills、H3-Context-IR API。
- RunningHub 工作流 YZ金鱼-MiniMax H3 终极篇-文武双全 — 上文参数模板在线版,支持 4090 云端出片。
- 银老 — H3 单节点内嵌二采 GitHub 项目 — 本期二采方案的参考实现。
- 秋叶 ComfyUI 整合包 — 本期整合包的底层环境蓝本。
整理自近一个月的实测,文戏 / 武戏两组参数模板已经在大约 50 段成片上验证过。如有更好的搭配,欢迎在评论区留言。