
MiniMax H3 上手实测:在 Mac / iPad 用 Draw Things 本地生成音画同步视频
MiniMax H3 是目前开源圈里最能打的一款音视频生成模型:一次生成画面 + 同步的立体声,文生视频、首尾帧、参考图生成全都能做。2026 年 8 月 3 日官方开源之后,Draw Things 很快就把 Mac 和 iPad 端的支持补上了。这篇是完整的上手实测 —— 模型怎么选、硬盘要留多少、加速 LoRA 挑哪个、你的设备到底要跑多久,以及最容易被忽略的提示词工作流。
点击按钮跳转 · 链接直达 · 提取码 xDDf
一、为什么是 H3:一次生成”画面 + 声音”的差别有多大
过去两年开源视频模型基本都卡在同一个点上 —— 只出画面,声音得自己配。而 H3 是音视频联合生成:同一次采样里同时产出视频帧和 32 kHz 立体声音轨,对白、环境音、动作音效是同步出来的,不是后配的。
官方模型卡给出的规格相当能打:
| 维度 | MiniMax H3 规格 |
|---|---|
| 输出时长 | 4 ~ 15 秒 |
| 输出帧率 | 24 FPS |
| 音频 | 32 kHz 立体声,原生同步生成 |
| 输出分辨率 | 短边默认 768 px,2K 需 H3-Regenerate-2K |
| 画面比例 | 21:9、16:9、4:3、1:1、3:4、9:16 等 |
| 对白语言 | 稳定支持 11 种(中、英、日、韩、法、德、西、俄、葡、意、阿) |
| 权重规模 | H3-Omni-Transformer 为 33B 单流稠密 Transformer |
底层是个不太一样的架构:文本编码器直接复用 Qwen3-VL-32B 的完整预训练权重,取第 50 层的 hidden states 喂给 Omni Transformer;视觉走 f16t4d24 的时序因果视频 VAE,音频走独立的 H3-AudioVAE(左右声道共享编解码器、40 Hz latent 率),位置编码用三维 MM-RoPE 管 (t, h, w)。
有一点要提前说清楚:官方开源的只是 H3-Base 这一层。负责”读懂复杂指令”的 H3-Context-IR 托管在服务端,没开源;负责 2K 重生成的 H3-Regenerate-2K 也还没放出来。所以本地跑的天花板是 768p 短边 + 原生立体声,想要 2K 得走官方 API。
二、一个模型,两种玩法:FL2VA 与 Ref2VA
H3 放出的是两个任务专用 checkpoint,选哪个完全取决于你要做什么:
| Checkpoint | 缩写 | 输入 | 适合的场景 |
|---|---|---|---|
| MiniMax-H3 Base FL2VA | 首尾帧到音视频 | 文本 + 0/1/2 张图 | 文生视频、图生视频、首帧+尾帧控制 |
| MiniMax-H3 Base Ref2VA | 参考到音视频 | 文本 + 多图/视频/音频参考 | 角色一致性、多素材融合、对话短片 |
FL2VA 支持三种输入:不给图就是纯文生视频;给一张图可以当首帧(或尾帧);给两张图就锁定首尾帧。官方文档里 FL2VA 的原始质量通常更好,Ref2VA 能吃更多参考素材但基础画质略低。
Ref2VA 的输入规格是:最多 9 张图片、最多 3 段视频(每段 2~15 秒、总时长 ≤15 秒)、最多 3 段音频,全部加起来最多 12 个文件。实际用起来,最舒服的姿势是把两张角色参考图丢进创意板,再用 subject_definitions 描述每个主体是谁,让模型生成两人对话。
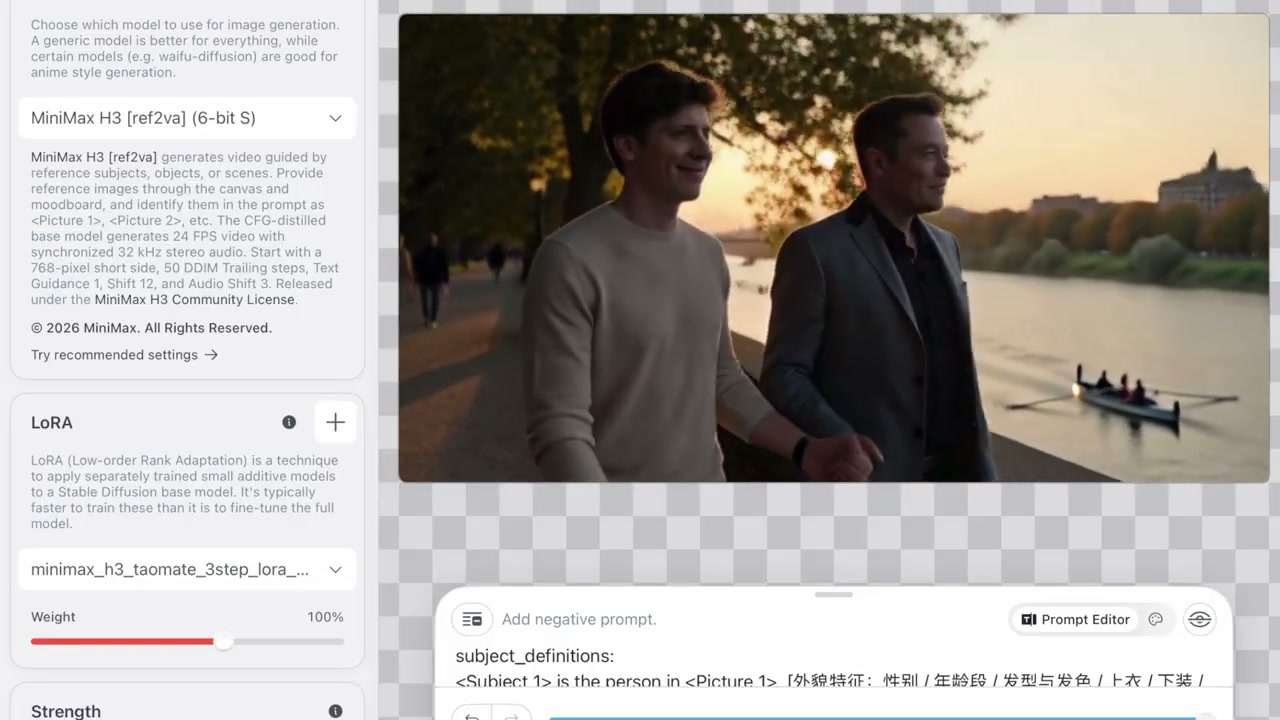
这套「参考图 + 主体定义」的玩法,是 H3 跟其他开源模型拉开差距的地方 —— 角色能在不同片段里保持一致,而不是每段都长得不一样。
三、Draw Things 上手:模型列表与硬盘账
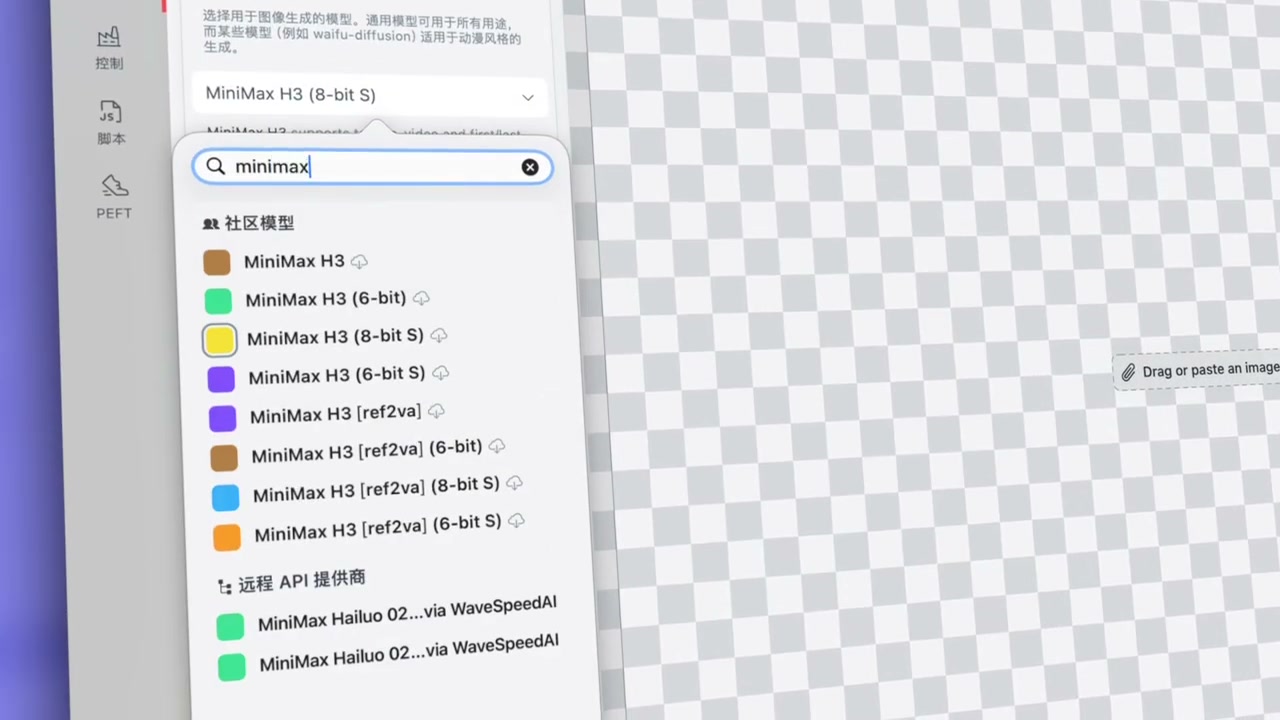
Draw Things(一个 Mac / iPad / iPhone 都能装的离线 AI 绘图 App)的模型列表里搜 minimax,直接能看到 8 个社区模型条目,外加两个走 WaveSpeedAI 的远程 API 选项 MiniMax Hailuo 02:
MiniMax H3/MiniMax H3 (6-bit)/MiniMax H3 (8-bit S)/MiniMax H3 (6-bit S)MiniMax H3 [ref2va]/[ref2va] (6-bit)/[ref2va] (8-bit S)/[ref2va] (6-bit S)
真正的成本在模型文件体积。这套东西拆开来是这样的:
| 文件 | 体积 | 说明 |
|---|---|---|
minimax_h3_fl2va_i8x.ckpt |
34.37 GB | 8-bit S 首尾帧版本主模型 |
minimax_h3_ref2va_i6.ckpt |
30.36 GB | 6-bit S 参考生成版本主模型 |
qwen_3_vl_32b_50_i8x.ckpt |
26.55 GB | 文本编码器(Qwen3-VL-32B) |
minimax_h3_vae_f16.ckpt |
5.51 GB | 视频 VAE |
minimax_h3_fl2v_turbo_4step_v1.2_768p_comfyui_bf16_lora_f16.ckpt |
1.46 GB | FL2VA 侧 4 步加速基座 |
minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16_lora_f16.ckpt |
1.46 GB | Ref2VA 侧 4 步加速基座 |
minimax_h3_turbo_v4_step600_ema_lora_f16.ckpt |
935.4 MB | Turbo 权重 |
minimax_h3_taomate_3step_lora_avg_rank_19_bf16_lora_f16.ckpt |
205.4 MB | TaoMate 3 步加速 LoRA |
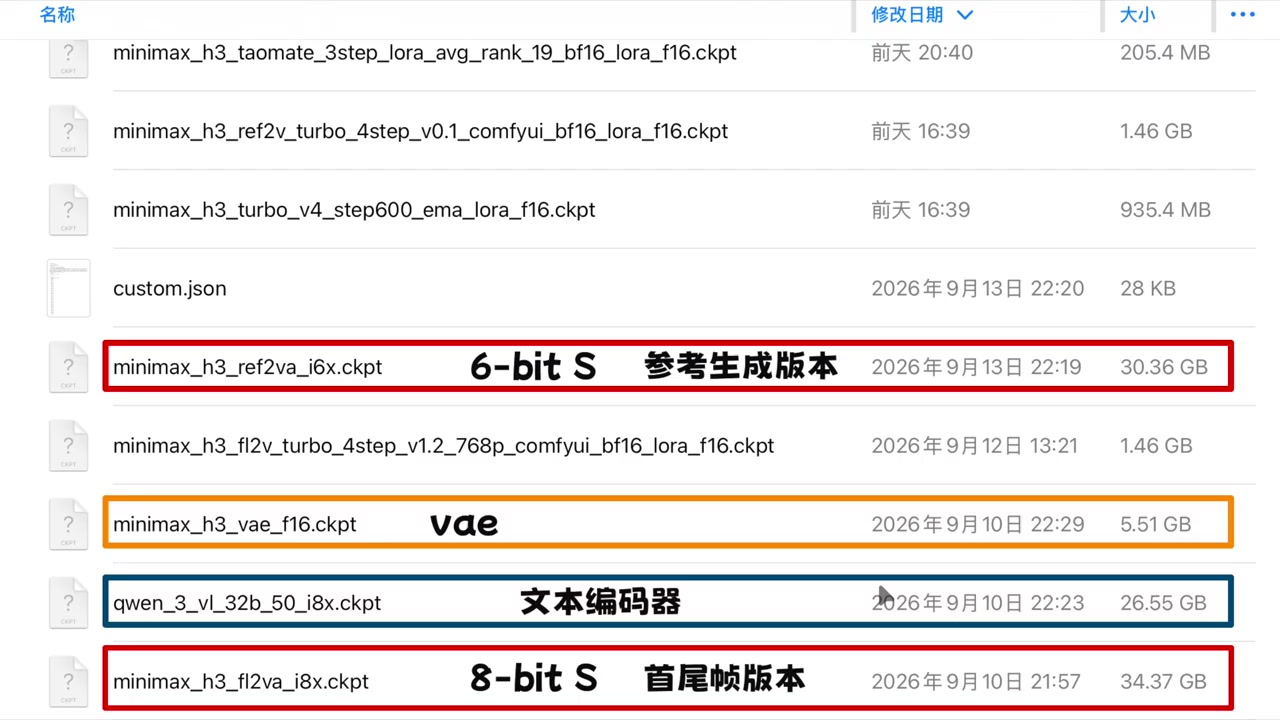
结论很直接:本地跑 H3,硬盘至少要留 60~70 GB。 主模型加文本编码器就是 60 GB 级别,再加 VAE 和各类加速 LoRA,100 GB 起步才宽裕。
顺带一个好消息:Draw Things 里 FL2VA 是第一个支持首尾帧双控的模型,尾帧不是塞在提示词里,而是放在「控制 → 创意板」里,配合首帧一起生效。
默认参数也基本是照官方模型卡填的:768 短边、50 步 DDIM、文本引导 1.0、Shift 12、Audio Shift 3,输出 24 FPS + 32 kHz 立体声。
四、加速 LoRA 实测:为什么是 TaoMate 3 步版
原生 50 步在本地跑是等不起的,所以加速 LoRA 基本是必装项。当前生态里主要有三套:
| 加速 LoRA | 步数 | 来源 |
|---|---|---|
| LightX2V 4-step | 4 步 | lightx2v/Minimax-h3-Turbo |
| LarryVRH 4-step | 4 步 | larryvrh/MiniMax-H3-Turbo-Lora |
| TaoMate 3-step | 3 步 | Kijai 优化版 minimax_h3_taomate_3step_lora |
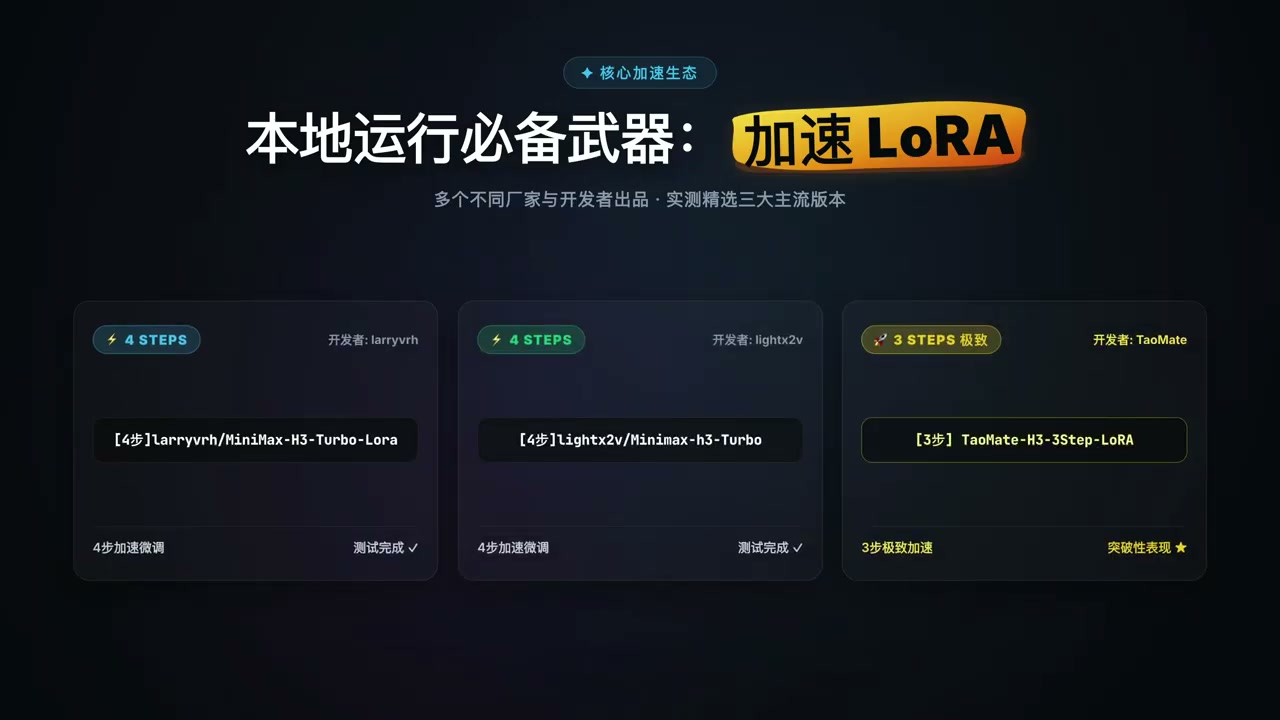
三个都实测过一遍之后,结论很清楚:TaoMate 3 步版是首选 —— 它用更少的步数换来了更好的画面表现,是”步数最少 + 效果最好”的组合。Kijai 优化过的版本只有 182 MB,导入 Draw Things 完全没负担:相比 30 GB 量级的主模型,加速 LoRA 的体积基本可以忽略不计。
三套 LoRA 的源文件都可以直接拿:
https://huggingface.co/Kijai/MiniMax-H3_comfy/tree/main/lorashttps://huggingface.co/lightx2v/Minimax-h3-Turbo/tree/mainhttps://huggingface.co/larryvrh/MiniMax-H3-Turbo-Lora/tree/main
五、四个案例:同一个模型,四种工作模式
实际跑下来,H3 的四种模式差别非常直观。
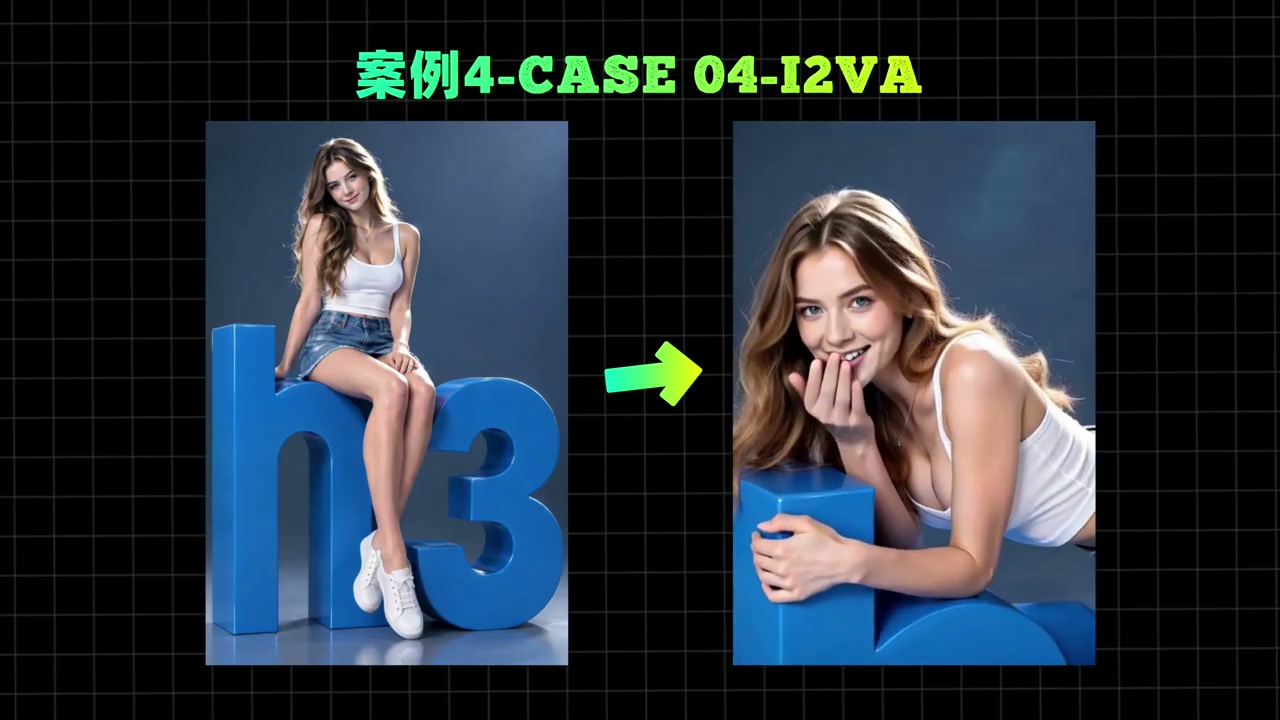
图生视频(I2VA):给一张图当首帧,模型把它动起来。人物坐在字母雕塑上,镜头推进后自然变成托腮回望 —— 首帧的构图、人物、光线都被保留,只有动作和机位在走。
首尾帧(FL2VA):首帧和尾帧都指定,中间的运镜、过渡由模型补全。这是做转场、做分镜最省事的方式。
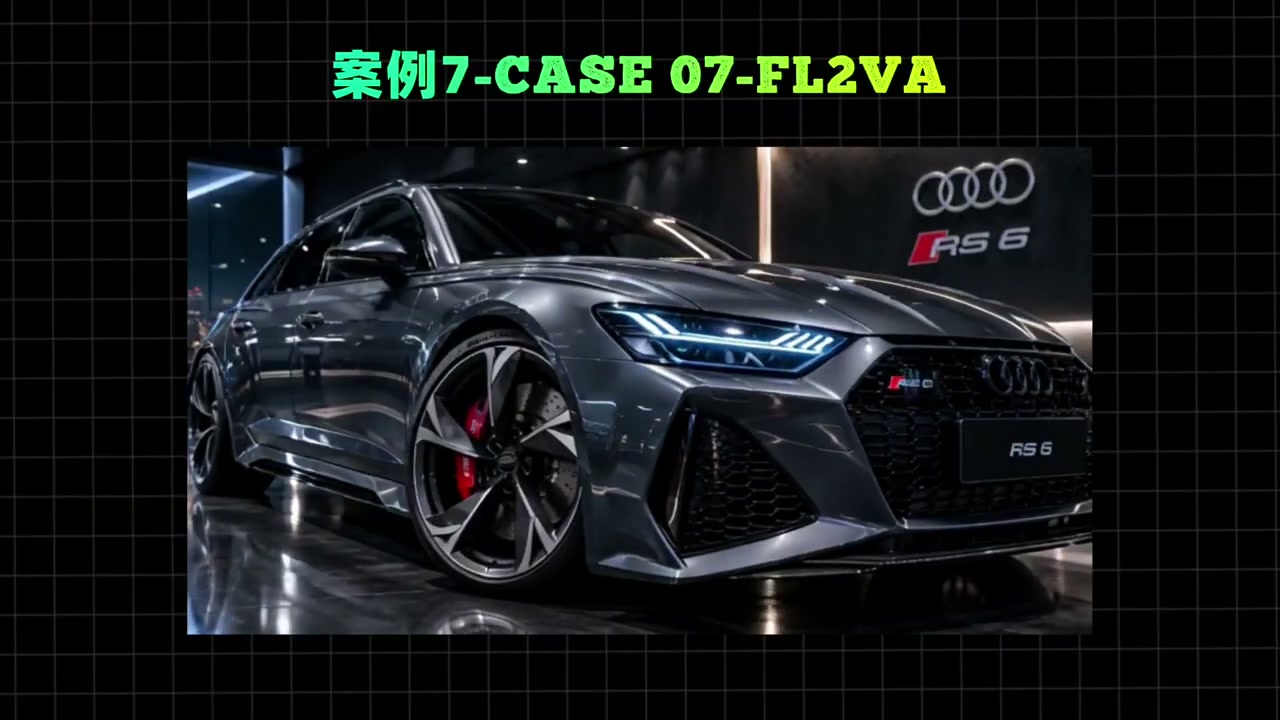
参考生成(Ref2VA):两张角色参考图 + subject_definitions,生成两个角色之间的对话镜头。对白是模型自己配的,口型和情绪基本对得上。
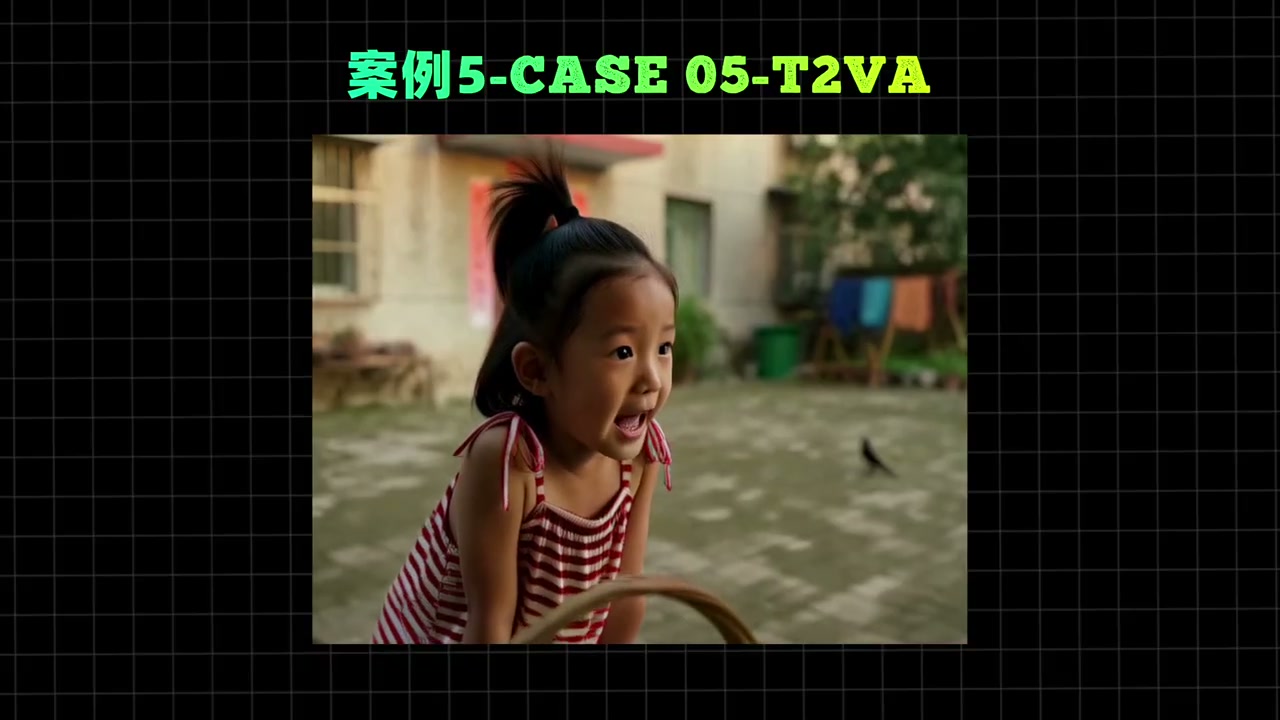
最狠的一个例子是:开场那段「DrawThings 上的 H3 爷爷」的镜头,就是在只有 16 GB 内存的 M4 iPad Pro 上用 FL2VA 跑出来的 —— 苹果用户终于不用为了生成视频去攒英伟达显卡了。
六、你的设备能跑吗:内存、耗时与参数起步
这是最多人问的问题。结论:从 M1 Ultra 开始,相当一部分 Apple Silicon 设备都能本地跑;内存越大优势越明显。
| 设备档位 | 建议 |
|---|---|
| M4 及以上 + ≥32 GB 内存 | 推荐配置,能跑更大分辨率和更长时长 |
| M1 / M2 / M3 + 16 GB | 能跑,但分辨率和帧数要压着来 |
| 低端设备 / 内存 < 16 GB | 建议走云端(见下一节) |
社区里有一个很有参考价值的实测数据点(ComfyUI,不是 Draw Things,但能看出量级):
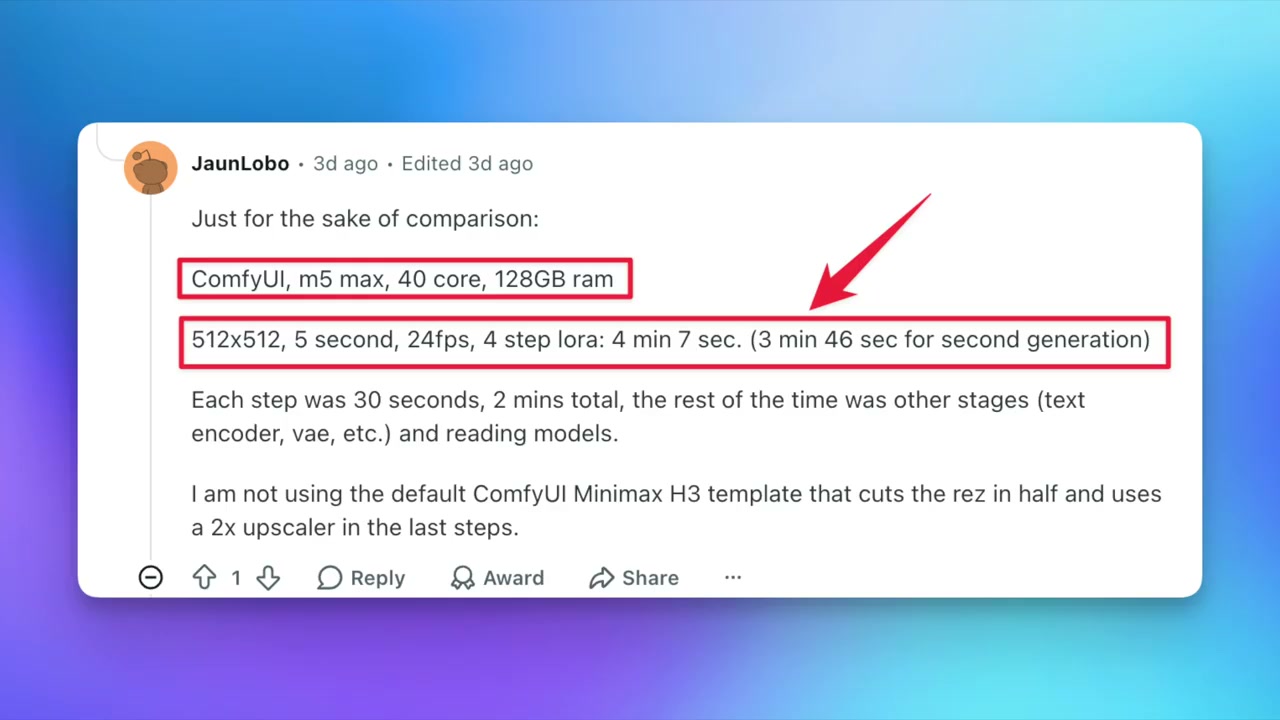
ComfyUI · M5 Max(40 核、128 GB 内存)· 512×512、5 秒、24 fps、4 步 LoRA:首次 4 分 7 秒,第二次 3 分 46 秒。每步约 30 秒,采样阶段占 2 分钟,剩下的时间全花在文本编码器、VAE 和读模型上。
这条数据里最值得注意的其实是最后一句:瓶颈不只在采样。大模型本体之外,文本编码器(26.55 GB)和 VAE 的加载 + 解码是固定开销,设备越弱,这块占比越高。
所以测试参数有个很务实的起步方式 —— 不要一上来就拉满:
- 先用小分辨率跑,比如 576×384。
- 帧数压到 107 帧左右(约 4.5 秒)。
- 跑一次,记下耗时。
- 再逐步往上抬分辨率和帧数。
这样每一步的耗时都是可预期的,不会在跑了一个小时之后才发现参数给大了。想做高清画质,就得换更硬的设备。
七、硬件不够时的退路:Draw Things+ 云计算
如果你的机器实在跑不动,Draw Things 提供了云端兜底方案:任务上传到云端算力节点处理,本地只负责上传和下载。
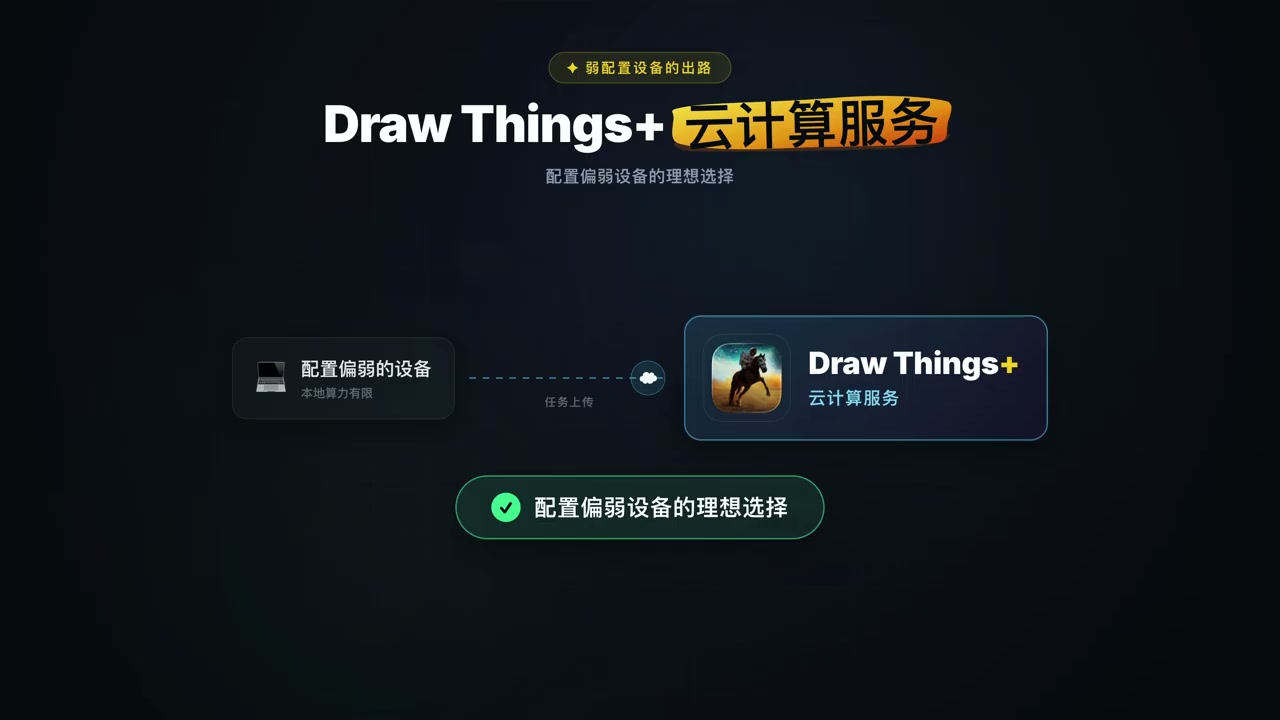
这条路对两类人特别有用:一是想先低成本试试 H3 到底什么水平再决定要不要买机器;二是偶尔需要出一条高分辨率成片,不值得为此专门配一台工作站。
八、提示词才是胜负手:LLM + Agent Skill 工作流
这是整篇里我最想推荐的部分。H3 的上限非常高,但你不写提示词,它就发挥不出来。
现在的做法是:所有视频提示规划都由 LLM 生成,你只需要给它一句简单指令。官方还直接提供了一份提示词写作 Skill,安装方式:
1 | npx skills add https://github.com/MiniMax-AI/MiniMax-H3 --skill h3-prompt-writing |
这个 Skill 是一份纯 Markdown + 参考文件,不调任何外部 API,所以在 Claude Code、Cursor、Codex、LangChain 等等任何能读 SKILL.md 和本地文件的 Agent 环境里都能用。它带两份提示词指南:
base-en.txt—— 文生视频 / 首尾帧模式ref-en.txt—— Ref2VA 全参考模式
更进一步的玩法是:把这两份指南丢给 LLM,让 Agent 现场造一个叫「MiniMax H3 提示生成器」的 Skill,之后想做什么都用斜杠调用它。
实际用起来就是这样:
「我现在想做图像转视频,请为我设计一个提示。」
当前场景:粘贴参考图。我需要一场猛烈的火山爆发,伴随着熔岩流淌的声音,无人机以第一人称视角俯冲到巨大的 Minimax 文字下方 —— 感受文字开始崩塌的感觉非常刺激。
然后把 LLM 规划好的提示词粘进 Draw Things,跑出来的结果非常出色。
这两份官方指南在 Hugging Face 上也能直接下:
VIDEO_PROMPT_WRITING_GUIDE_base_en.md(文生视频 / 首尾帧)VIDEO_PROMPT_WRITING_GUIDE_ref_en.md(参考生成)
九、还没解决的三个问题
上手一圈下来,有三件事目前是明确的短板:
- 音画结合的输入还只做了一半。 Draw Things 现在主要是文字 + 图像作为条件,「音频 + 图像」一起作为输入条件(比如给一段音频让画面跟着动)这条路径还没打通 —— 这是我最期待官方补上的能力。
- 长视频的音画一致性。 H3 单次最长 15 秒,超过这个长度就得靠分段 + 前后帧衔接,声音的连续性比画面更难保持。
- 2K 还在云端。 H3-Regenerate-2K 没开源,本地只能 768p 短边。
社区侧已经在补这些洞:ComfyUI 当天就合入了 H3 支持;antirez/h3.c 是一个 Metal 原生的 Apple Silicon 实现,专门做了 M3 Max / M5 Max 的性能优化;还有 Motion-Context 这类方案,把上一段的尾帧和音频一起喂给下一段,来保住运动方向和速度的连续性。
十、我的建议:谁值得折腾
不是所有人都需要在这上面花时间。给你一个直接的判断标准:
- 值得折腾:你有 Mac / iPad,想在不依赖云服务的前提下批量出带声音的短片;你需要角色在多条片段里保持一致;你接受几十分钟一条的等待时间。
- 先别折腾:你只是偶尔想要一条 AI 视频 —— 官方 API 和 Hailuo AI 的按量计费大概率比你的电费便宜;或者你没有任何一台内存 ≥16 GB 的 Apple Silicon 设备。
如果决定试,我的顺序建议是:
- 先装 Draw Things,搜
minimax,只下 6-bit 版本,把磁盘压力和下载时间压到最低。 - 只下 TaoMate 3 步 LoRA,别折腾其他加速方案,它是目前综合最优解。
- 参数从 576×384 / 107 帧起步,测出耗时基线再往上加。
- 提示词交给 LLM,配合官方
h3-prompt-writingSkill,别自己硬憋。
总结
MiniMax H3 让「本地生成带声音的视频」从不可能变成了可能,Draw Things 把这件事搬到了 Mac 和 iPad 上。33B 的单流 Transformer、一次采样同时出画面和立体声、FL2VA 与 Ref2VA 两种控制方式、官方直供的提示词写作 Skill —— 这几样凑在一起,已经是一个能用的完整闭环。
但要清醒:本地跑起来要 60 GB 硬盘、32 GB 内存、一条几分钟的等待,这些门槛都摆在那儿。它的价值不在于替代云端,而在于把「我的素材不出本机」这件事变成可能 —— 对隐私敏感、或者需要批量跑自有素材的人来说,这一点值回所有成本。
社区的完整资源索引在 MiniMax-AI/awesome-minimax-h3-integration,从显存分档推荐到各家量化包都有,想深挖可以从那里进。
你用 H3 跑出来最长的一条片子是多少秒?在 M 系列设备上生成一条大概要等多久?欢迎在评论区聊聊,或者把你踩过的坑分享出来。
延伸阅读:
MOSS-Image 全能生图:LoRA + 提示词模板工作流实测 ·
Fisher Pose 终极版:Qwen2.1 姿势与机位编辑器实测,8G 显存跑通 ·
MiniMax M3.1 Flash 实测:70 亿 Token 主力模型与 Agent 自动剪辑实践