
RTX Spark 该不该买:128GB 笔记本对比 2 张 L40S 的回本账
128GB 内存的笔记本到底值不值这个价?这是最近很多人盯着 RTX Spark 问的问题。喊出 1 PFLOP AI 算力、128GB 统一内存,听起来像是把数据中心塞进了机身,但真要掏钱之前,谁都想先搞清楚三件事:它比我现在租的云卡快还是慢、跑下来到底省不省钱、以及——它凭什么能卖出去。
这篇把账一笔笔算清楚:用 Blender 官方场景实测 GB10 和 2 张 L40S 的差距,再把租和买两条路的回本周期摊开看。结论可能和很多人的直觉相反——这台电脑真正稀缺的不是算力,而是那 128GB 内存里装得下的模型。
一、先算清楚现在的云账单:60 块一小时花在哪
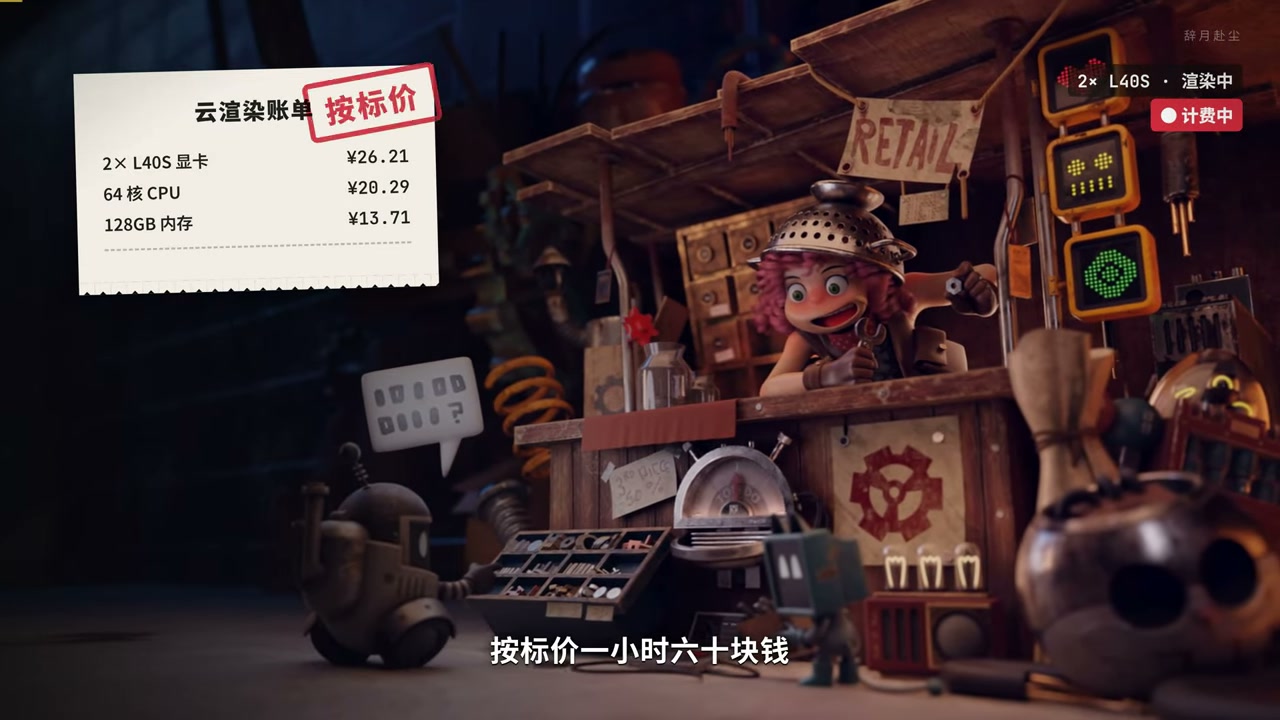
做 3D 渲染的人对云 GPU 的账单都有痛感。常见的配置是 2 张 L40S 加 64 核 CPU、128GB 内存,按标价一小时大约 60 块钱,拆开看是这样:
| 计费项 | 单价(每小时) |
|---|---|
| 2 × L40S 显卡 | ¥26.21 |
| 64 核 CPU | ¥20.29 |
| 128GB 内存 | ¥13.71 |
| 合计 | 约 ¥60 |
有意思的是,这里头 CPU + 内存占了将近一半,显卡反而只占四成多——渲染虽然挂在 GPU 上,但主线程逻辑、场景合成、色彩管理这些活儿都在吃 CPU 和内存。
按这个价,一个月轻松一万出头,出片密集的月份一天能烧掉三百多。这时候英伟达扔出一台 128GB 内存、号称 1 PFLOP 算力的笔记本,你很难不动心:买一台,把云退了,是不是就等于把成本砍到零?
于是有了这次实测。租一台同芯片的机器,用 Blender 官方测试场景,和手头那两张 L40S 在完全相同的场景、相同的参数下比一比。
二、RTX Spark 和 DGX Spark,其实是同一颗芯片
先做个找不同:左边是 2025 年 DGX Spark 的宣传片,右边是 2026 年 RTX Spark 的。两段片子放在一起,两块芯片飞过来、一合体、一发光,动作几乎一模一样。
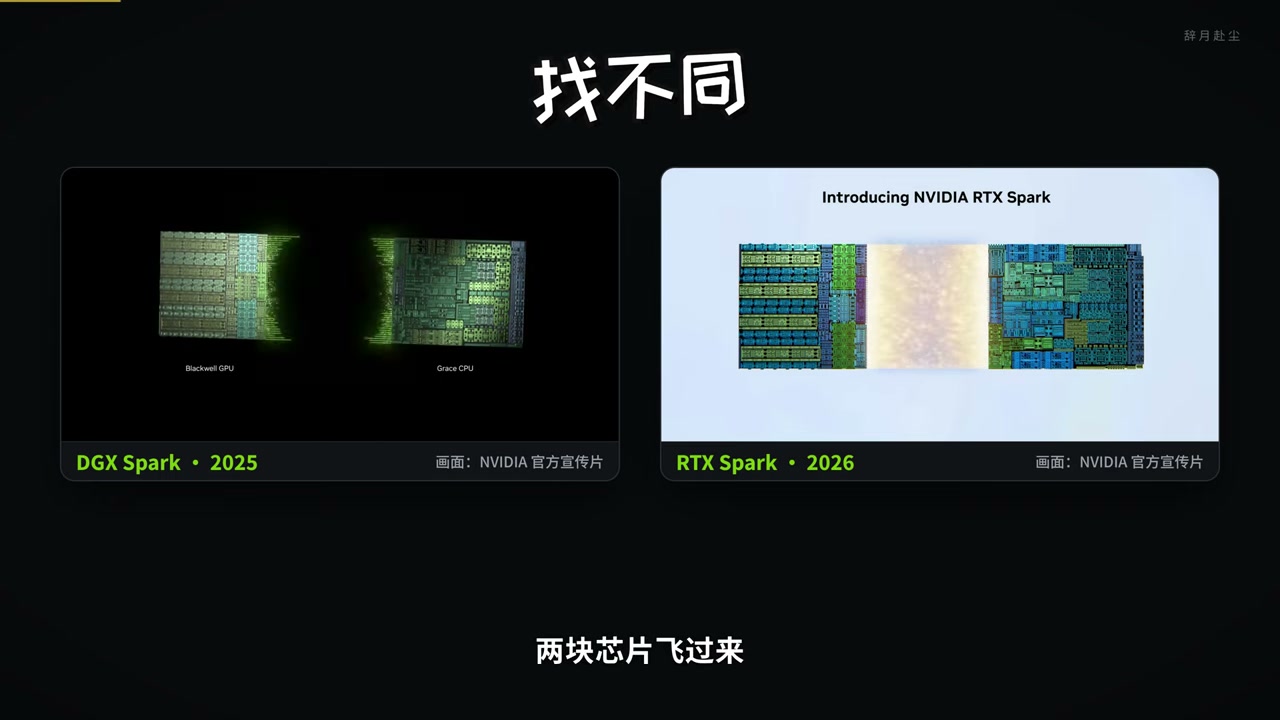
有意思的是两颗芯片的叫法:左边那颗是 GB10,右边宣传片里标的是 N1X。但把两张管芯照片摆在一起看就明白了——它们是同一颗芯片。
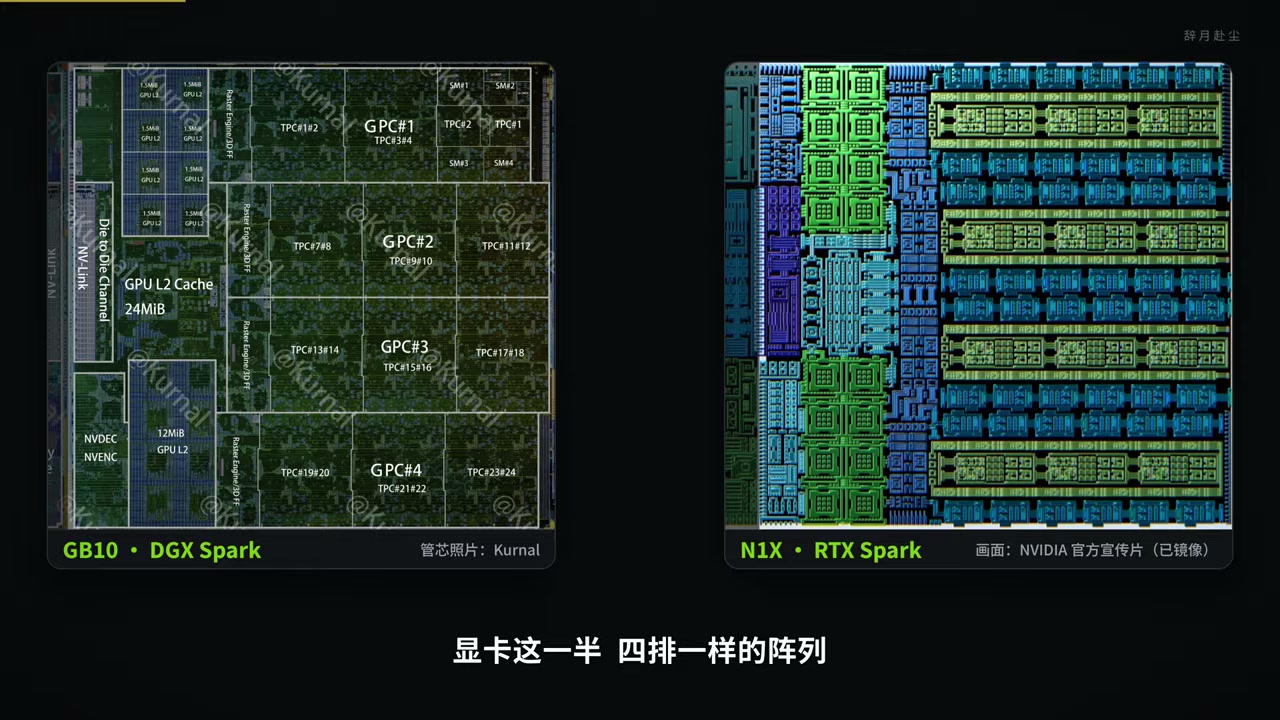
对得很死:
- 显卡那一半:四排一模一样的阵列,一共 6144 个 CUDA 核心,和桌面版 RTX 5070 一样多
- CPU 那一半:10 个大盒加 10 个小盒,是联发科帮着做的,位置逐一对得上
- 参数上:显卡、CPU、内存、AI 算力基本一模一样
唯一的区别在功耗:台式形态的 DGX Spark 和 RTX Spark 都是 140W,而塞进笔记本后被压到 45~80W,速度上会再打一点折扣。
也就是说,去年卖给 AI 开发者的那个「小金盒子」,今年原封不动地被塞进了 Windows 笔记本。这套逻辑我很熟悉,和 Apple 当年用统一内存改造 MacBook 是同一个思路——想要大模型跑得动,先把内存池做大。
规格摊开看:
| 项目 | N1X / GB10 |
|---|---|
| CUDA 核心 | 6144(与桌面 RTX 5070 相同) |
| CPU | 20 核 Arm(联发科参与设计) |
| 统一内存 | 128GB,CPU 与 GPU 共用 |
| 功耗 | 台式 140W,笔记本 45~80W |
| 标称 AI 算力 | 1 PFLOP |
这次最值得盯的还是那 128GB。英伟达外号「砍刀客」,刀法最狠的地方一直是显存:RTX 5060 给 8G,旗舰 5090 也才 32G。突然一台笔记本给到 128G,确实是让人愣了一下——它怎么突然这么大方?
三、实测:GB10 比 2 张 L40S 慢近 7 倍
测试条件很朴素:租来的 GB10(约 5 块/小时)对照两张 L40S(约 60 块/小时),同一个 Blender 官方场景,同样的 Cycles 参数,同样是 90 帧。
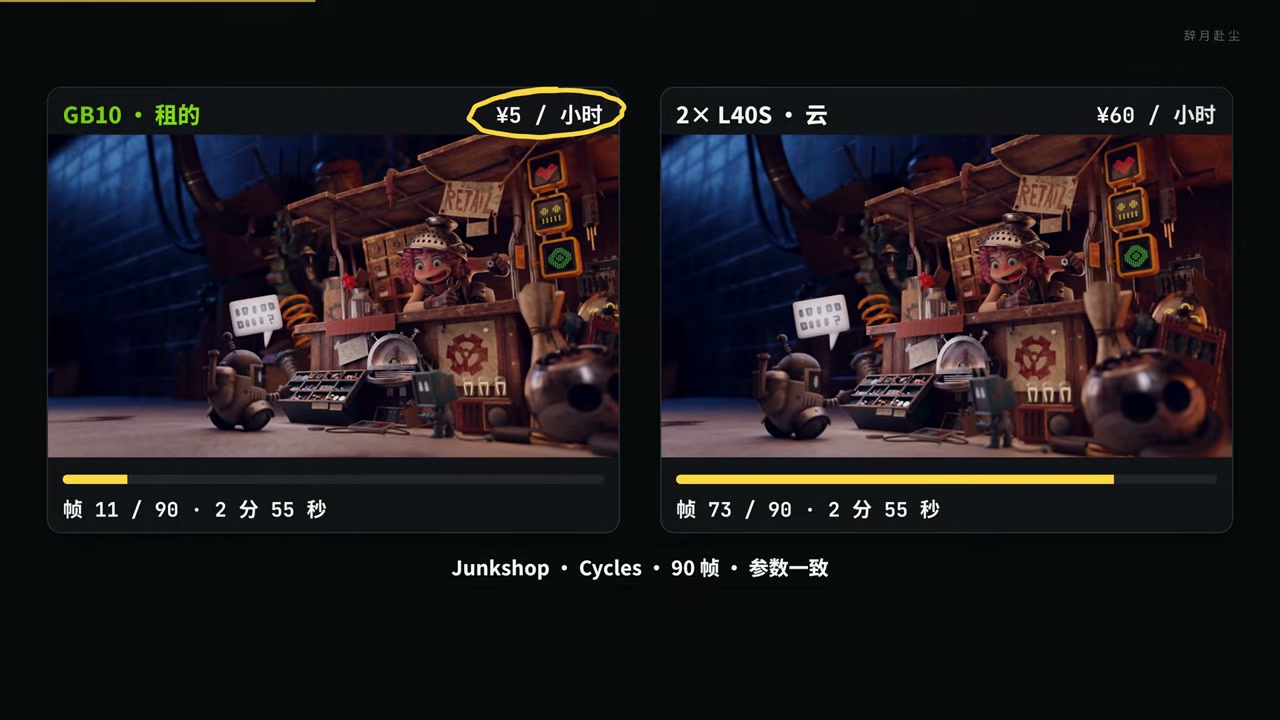
结果很直接:L40S 那边先渲完,GB10 慢了将近 7 倍。
那是不是「不会用」的问题?把两边的显卡占用都录下来看,渲染过程中两张 L40S 都跑到了 99%,GB10 也是满的——两边都吃饱了,不存在资源闲置。差距就是实打实的 10 打 10。
硬件账也对得上:
| 对比项 | 2 × L40S | GB10 |
|---|---|---|
| CUDA 核心数 | 36000+ | 6144 |
| 功耗 | 约 700W | 140W |
| 显存 | 2 × 48GB | 128GB 统一内存 |
光核心数就差了将近 6 倍。所以这个结果并不神秘,只是把「小金盒子」的定位摆清楚了:它的价值不在吞吐,在容量。
需要说明的是,这类测试天然有局限——场景、光追采样数、CPU 参与度都会影响结果,不同显卡的渲染器后端也不完全一样,拿单一场景的结论去横向硬比显卡是不严谨的。如果关注的是 Blender、Octane、V-Ray 这类生产环境的绝对性能,还是要参考更系统的评测。
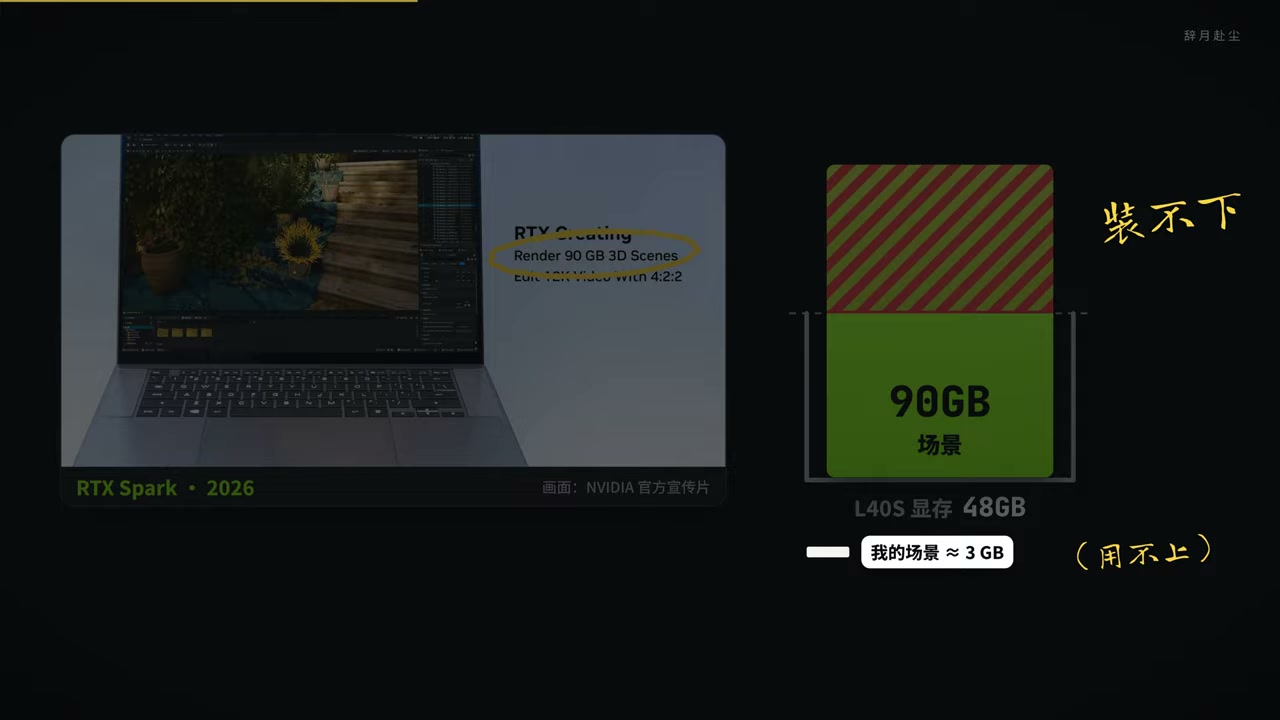
不过英伟达自己也承认过一个边界:标称能渲染 90GB 的超大场景,而单张 L40S 只有 48GB 显存,确实装不下。这是 128GB 统一内存真正的护城河——不是「渲染更快」,而是「原本根本渲不了」。
四、算钱:租着划算,买断要 8 个月回本
慢不等于贵。把两条路的单价摆出来:
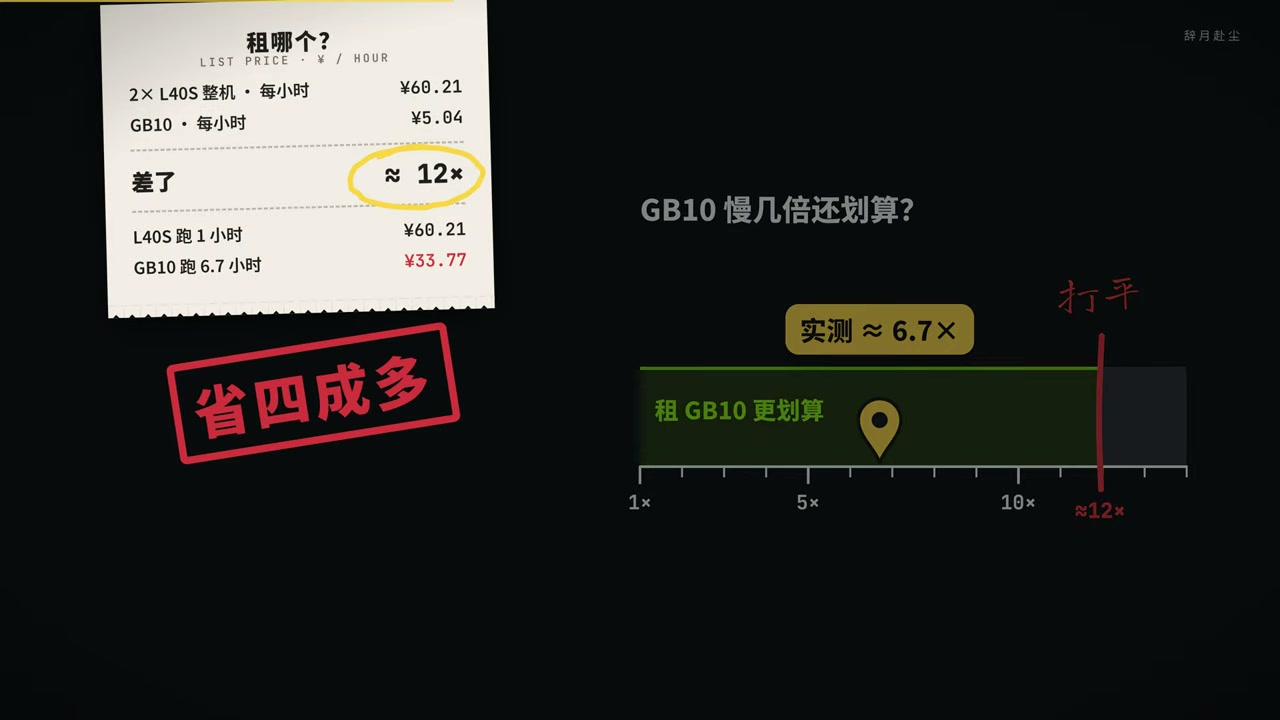
| 方案 | 单价 | 做一个同样的活 |
|---|---|---|
| 2 × L40S | ¥60.21 / 小时 | 1 小时,¥60.21 |
| GB10 | ¥5.04 / 小时 | 6.7 小时,¥33.77 |
价差约 12 倍,实测速度差约 6.7 倍。只要慢不超过 12 倍,租 GB10 就更划算,而实测下来同一个活能省四成多。这就是「慢不等于贵」的算法。
那直接买呢?带 128GB 的 RTX Spark 台式机,按微软的标价折合人民币 4 万出头。假设它 24 小时不停跑,每个月能顶掉 6000 多块云账单,听着 6 个多月就回本。但真算起来有两个硬伤:
第一,一台干不完。 手上这些活换到它身上要跑 1000 多个小时,而一个月只有 720 个小时。得买两台、8 万块,回本周期拉到 8 个月左右。
第二,得等。 原来一个半小时出的 4K 成片,换到它身上要 10 个小时,只能睡前点渲染、早上起来看结果。
钱是能回本的,但这么慢,只为渲染买它,还是有点勉强。
五、指望省 API 钱?这条账更回不了本
那换个思路:不买来渲染,拿来跑本地大模型,省下 API 费用总行了吧?这里就绕不开另一个人。
DeepSeek 的 API 夜间价,100 万 token 的输出才 4 块钱。4 万块钱能买 100 亿个 token。而这台电脑跑一个 80 亿参数的小模型,速度是每秒 50 多个 token。
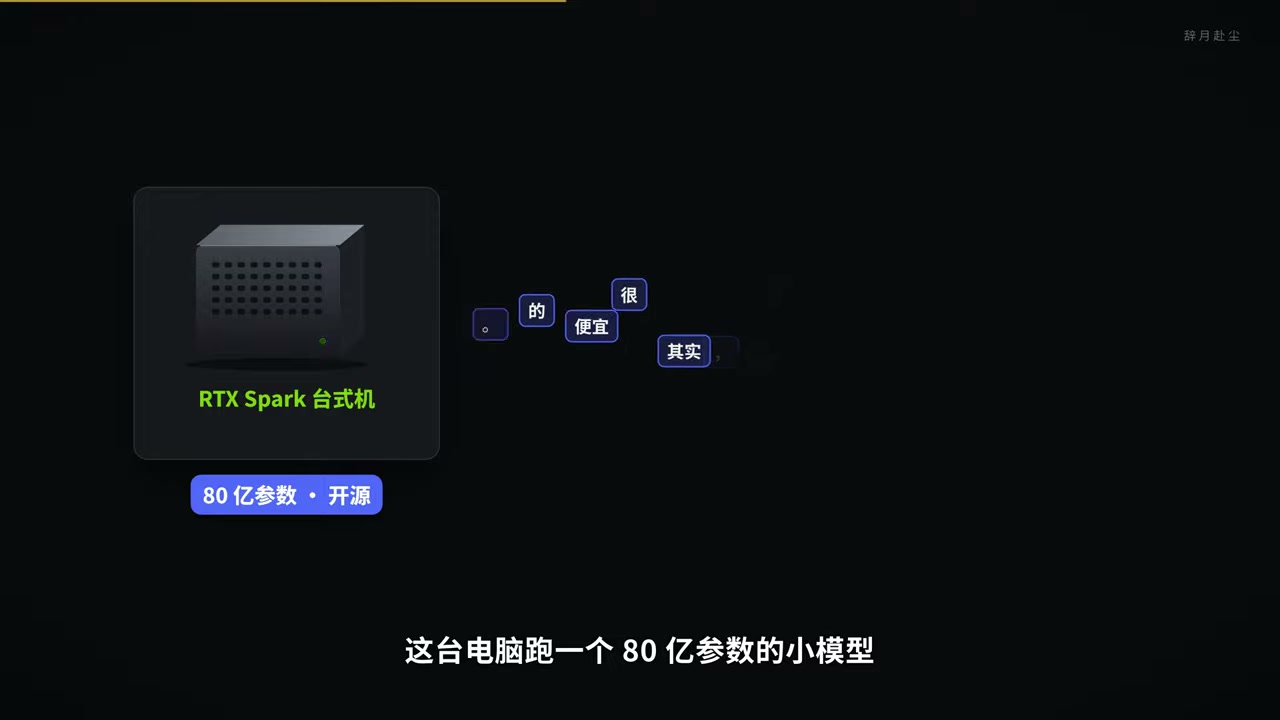
按这个速率不吃不睡地跑,需要将近 6 年才能回本,电费还没算。
靠省钱,这台电脑回不了本。
六、那它凭什么卖?英伟达卖的不是算力
看英伟达自己怎么讲这台机器:专门给 AI 智能体用,能跑 1200 亿参数的模型。它想卖的故事是——你电脑里住着一个 AI 助手,24 小时帮你干活,数据不出你自己的电脑。
这个故事成不成立,只看一件事:那个模型从哪来。
回到 1979 年。个人电脑刚火的时候,电脑是住在机房里排队的,按机时付钱,想用就得等。
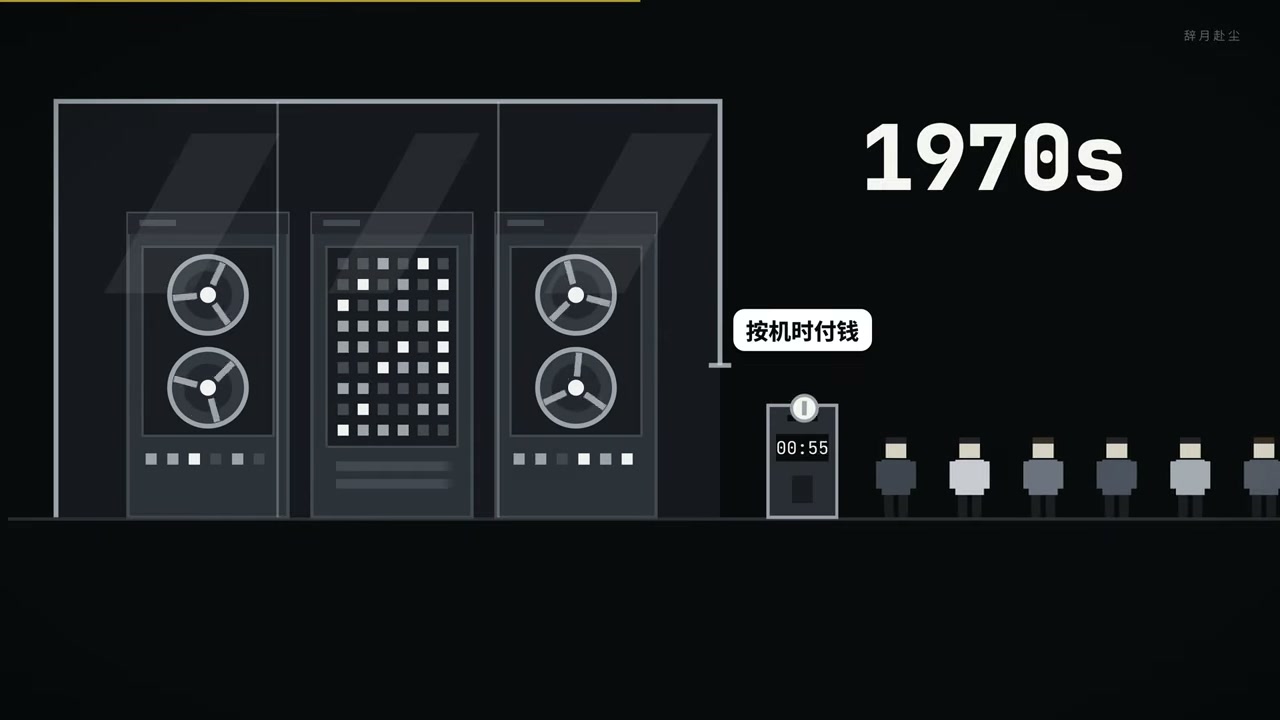
1979 年 Apple II 上出现了电子表格软件,好多人就是为了它,把电脑搬回了家。电脑之所以变成个人的,是因为有好软件能装进自己的机器。
而 AI 的前几年正好是反过来的:最好的模型全在别人的云里,只能按 token 交钱,下载不了。那时候买一台 128GB 的笔记本能干嘛?打游戏。
七、DeepSeek 把藏宝图印成了传单
转机出现在 2025 年 1 月。DeepSeek 发布了 R1,推理能力对标 OpenAI 的 o1,而权重直接放上网,MIT 许可证,下载随便。那阵子的盛况是「服务器繁忙,请稍后再试」,官网挤不进去,大家干脆自己动手,本地部署 DeepSeek 传满天飞——大多跑的是小一号的蒸馏版,但很多人是头一回在自己电脑上跑起大模型。
更狠的是它真不藏:
- 开源周连放 5 天底层代码
- 今年 4 月的 V4 照样放权重
- 10 月 20 日,连自家线上服务用的推理框架 DeepInfer 都开源了,整理好挂上 GitHub
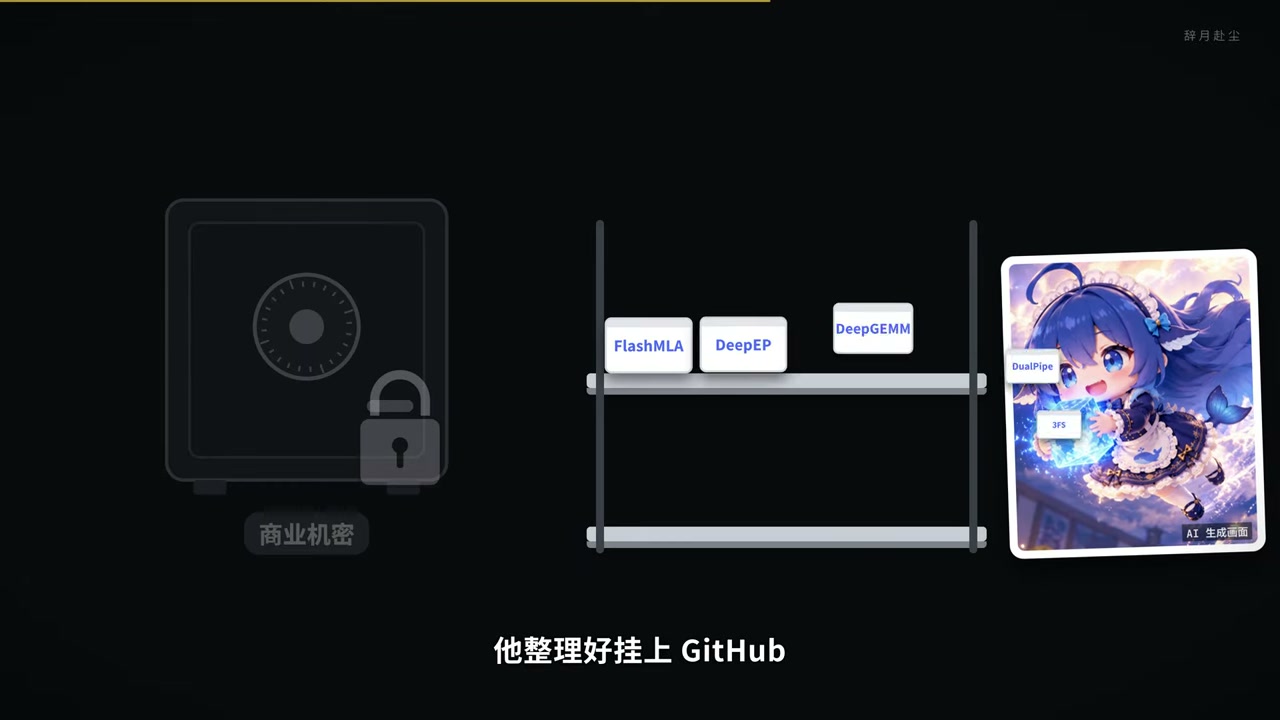
网友叫它「原神」,这不算夸张。就连 OpenAI 都坐不住了——奥尔特曼说他们在开源上「站错了历史的一边」,半年后也发布了开源模型。黄仁勋在 CES 上也点名:R1 是第一个开源的推理模型,让全世界吃了一惊。
回到那个问题:砍刀客为什么突然大方,给笔记本塞 128G?
因为现在有东西可装了。 RTX Spark 的演示用的就是 Nemotron、千问这些开源模型。没有下得下来的模型,那 128GB 就是摆设。
当然刀也没真放下:今年内存涨价,128G 的 DGX Spark 折合人民币从 27000 涨到了 47000,还新出了个 64G 的便宜版。刀只是换了个地方砍。
八、开源模型越便宜,英伟达反而越值钱
可能有人要问:开源模型又强又便宜,英伟达不该难受吗?市场当年就是这么想的。
2025 年 1 月 27 日,DeepSeek 冲上美国 App Store 免费榜第一。大家一算 V3 最后一次训练的成本,结论是「那谁还买那么多卡」,英伟达当天跌了 17%,蒸发将近 4 万亿人民币,创下每股单日最大跌幅。
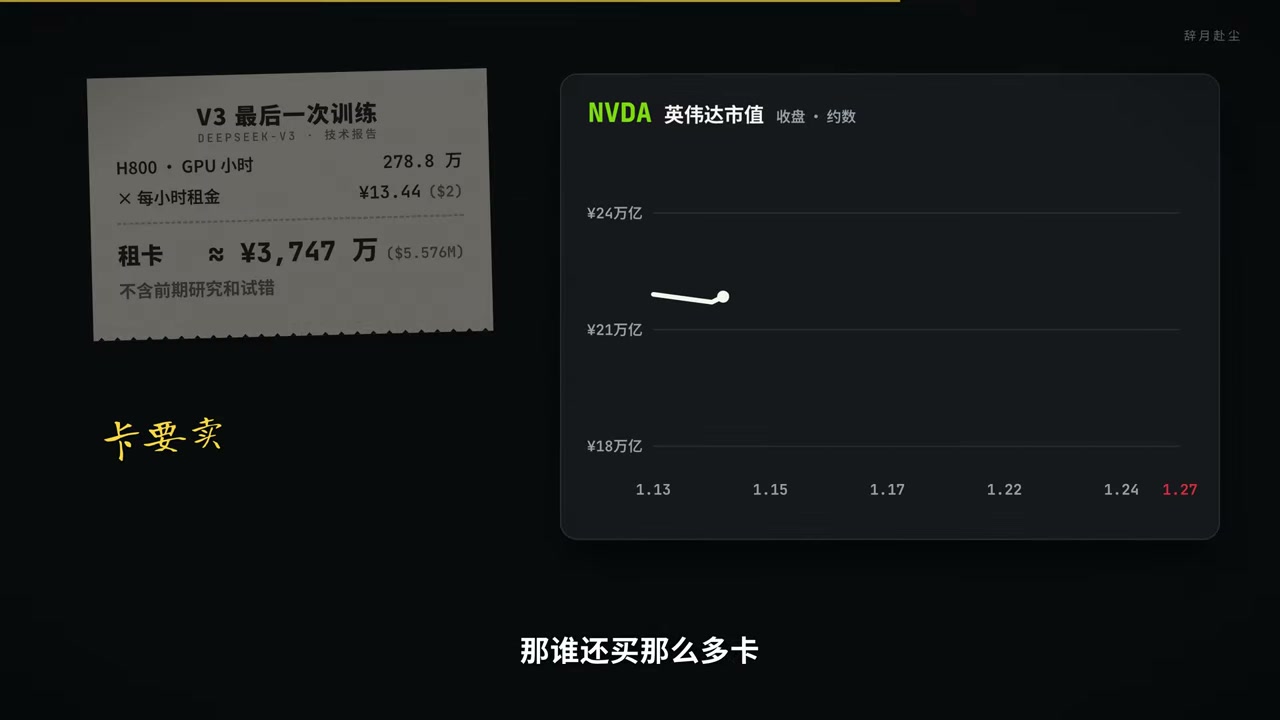
但 1865 年,经济学家杰文斯就发现了:蒸汽机越省煤,英国烧的煤反而越多。东西一便宜,用的人就多了。后来果然,推理模型一动就是几千个 token,用量一路涨;黄仁勋在 GTC 上说,要的算力轻轻松松就是一年前预估的 100 倍。到今年 10 月初,英伟达市值接近 39 万亿人民币,差不多是暴跌那天的 2 倍。
黄仁勋有句名言:买得越多,省得越多。
梁文锋证明的恰恰是倒过来那句:省得越多,买得越多。
个人 AI 电脑又把账放大了一圈:数据中心的卡卖给公司,电脑卖给每个人。
全世界一年卖掉 2 亿 8 千多万台电脑,哪怕只有一小部分装上英伟达的 AI 芯片,也是一门新的大生意——前提是大家手里有下得下来、跑得动的好模型。
九、英伟达这 30 年为什么不自己造 CPU
老黄比谁都清楚电脑有多重要。2026 年 10 月 7 日在微软发布会上,他说英伟达就是因为 Windows 才创立的。
但 30 多年来,英伟达在电脑里只卖显卡,CPU 一直在英特尔和 AMD 手里。
他不是没想过。2020 年英伟达要花 2600 多亿人民币买下 AMD,各国监管一起拦,2022 年黄了。买不下来就换个下法:CPU 跟联发科一起做,GPU 自己做,拼成 GB10,先装进 DGX Spark 给开发者试水,再拉上微软装进 Windows 笔记本。另一边,英伟达还往英特尔投了 330 多亿人民币,一起做带 RTX 显卡的 x86 芯片。
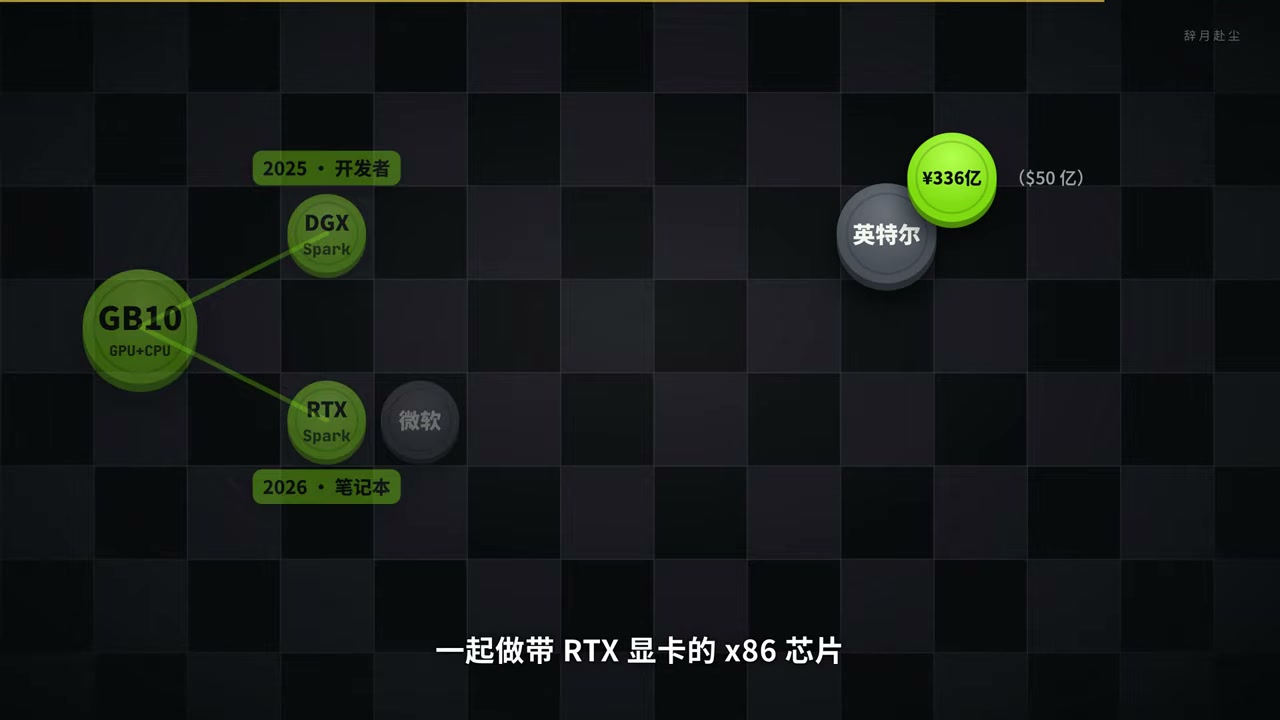
AMD 也好,x86 也好,里面都得有一块英伟达。
对手也不弱:苹果 M5 Max 同样是 128GB,内存带宽差不多是两倍,CPU 也更强;AMD 有 128GB 的 Strix Halo;高通在 ARM 版 Windows 上已经做了好几年。
英伟达最硬的牌还是 CUDA——在笔记本上写的 AI 代码,搬到数据中心还是同一套软件。
十、买不买:两条人群,两个答案
如果你的主要负载是渲染这类重吞吐任务,那笔账已经算完了:租 GB10 比租 2 张 L40S 省四成多,但慢近 7 倍;买断 4 万到 8 万要 8 个月回本,还得忍受 1 个半小时变 10 小时。除非你本来就有大场景装不进 48GB 显存的刚需,否则只为渲染买它确实勉强。
如果你是把 AI 当日常生产力的人,那结论完全不同。128GB 统一内存、CPU 和显卡共用一大块,这是苹果这几年已经走通的路——跑大模型、开大工程,不用再为显存发愁。类似 UNIFIED MEMORY 的用法在本地大模型圈已经有成熟方案,比如用显存 / 内存 / SSD 三级调度跑 125B 模型的 Strata 实测,以及把 70B 塞进 4GB 显存的 AirLLM 分层流式;苹果统一内存那条线在 MiniMax H3 × Draw Things 实测里也验证过。
这条路的唯一前提是:软件跟得上。 微软和不少软件公司都在说会把常用软件尽快搬到 ARM 版 Windows 上,Photoshop、Premiere 已经能原生跑了——但「能跑」和「跑得快」是两回事。买之前先查查你天天用的那几个软件在 ARM 版 Windows 上的实际表现。
总结
这台机器的账其实只有两种人算得清:一种是用算力吃饭的人,另一种是用模型吃饭的人。
对前者来说,RTX Spark 是台称职但慢得离谱的渲染机——租着能省四成多,买断要 8 个月回本,还得接受出片变慢 7 倍的代价。
对后者来说,128GB 统一内存才是重点:它让「模型住进自己电脑」第一次在硬件上说得通。而在 DeepSeek 把权重、代码、推理框架一个一个放出来之后,个人电脑终于有了装得下的模型——这才是 RTX Spark 真正的需求来源。
所以这台电脑要是卖得好,最该谢的人姓梁,不姓黄。老黄在淘金热里卖铲子,而有人把藏宝图印成传单满大街发。铲子还能不好卖吗?
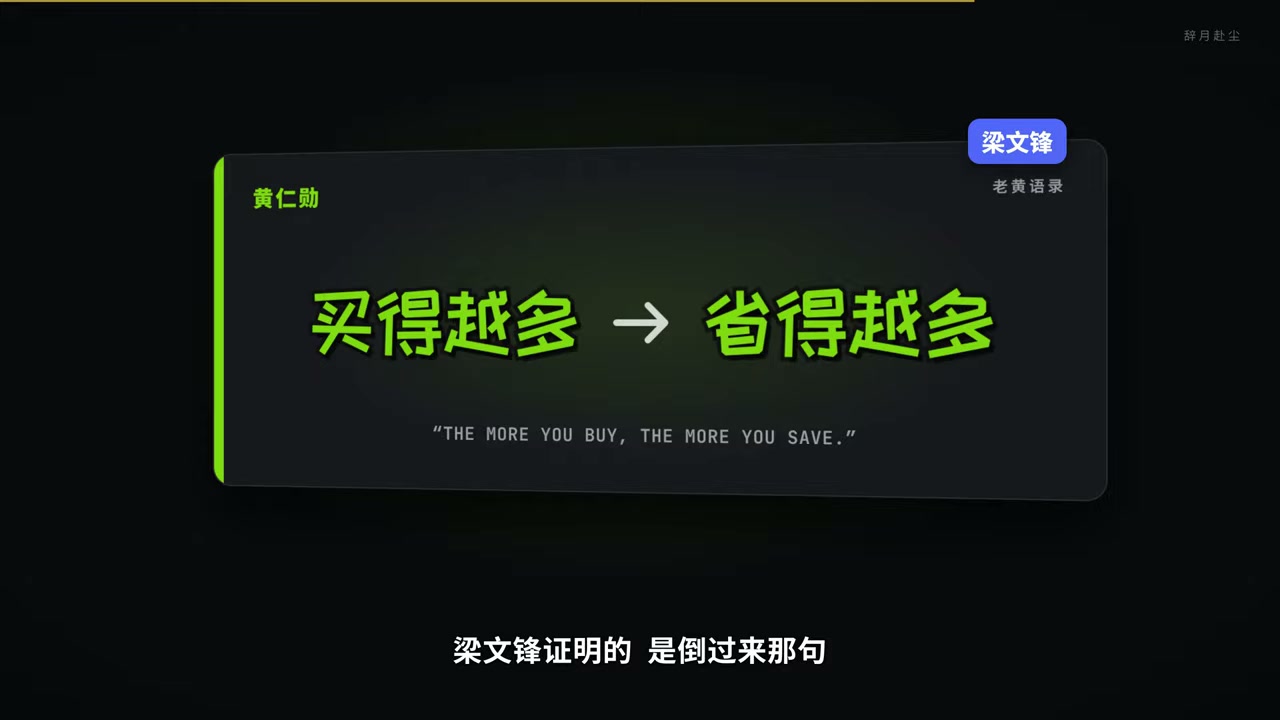
有意思的是,两句话其实是同一件事的两面:买得越多省得越多,省得越多买得越多。AI 硬件这一轮真正的燃料,不是更快的芯片,而是更便宜的开源模型。
本文的数据来自一次自建 Blender 渲染环境的实测,场景、参数与账单明细均已列出,结论适用于相近工作负载;不同显卡的渲染后端差异较大,选购前请结合自己的实际场景再做判断。
如果你也在本地跑大模型,可以看看 Strata 用 64G 内存 + 16G 显卡跑 125B 的实测,或者 AirLLM 分层流式的技术拆解。