
Pi 还是 Oh My Pi:极简内核与开箱即用 fork 的取舍
让 AI 替你干完一整套活,而不是一次只干一件——这件事已经从加分项变成了选工具时的第一道题。Claude Code、Codex、Pi Agent 我都长期用过,最后留在手边的是 Oh My Pi(OMP),原版 Pi 的一个 fork。
但选它的理由不是「功能多」这么简单。Pi 和 Oh My Pi 几乎站在两个哲学的对立面:原版说「我不需要就不造」,OMP 说「你需要的都装好了」。这篇把两边的逻辑、代价和实测数据都摊开,最后给三条拿来就能用的判断标准。
一、原版 Pi 的取舍:「我不需要就不造」
Pi 的作者 Mario Zechner 动手做它,不是做不出来,是有意不做。
动机很具体。2025 年 4 月起 Claude Code 是他的主力工具,但到 8 月他写下抱怨:它「变成了一艘宇宙飞船,八成的东西我根本用不上」;更要命的是 system prompt 和工具定义每次发版都在变,直接打断手头的工作流。在那篇 《What I learned building an opinionated and minimal coding agent》 里,他把自己的哲学定成一句话——如果我不需要,它就不会被造出来。
落到数字上就很直白:
| 项目 | Pi |
|---|---|
| 系统提示 + 工具定义 | 合计不到 1000 个 token |
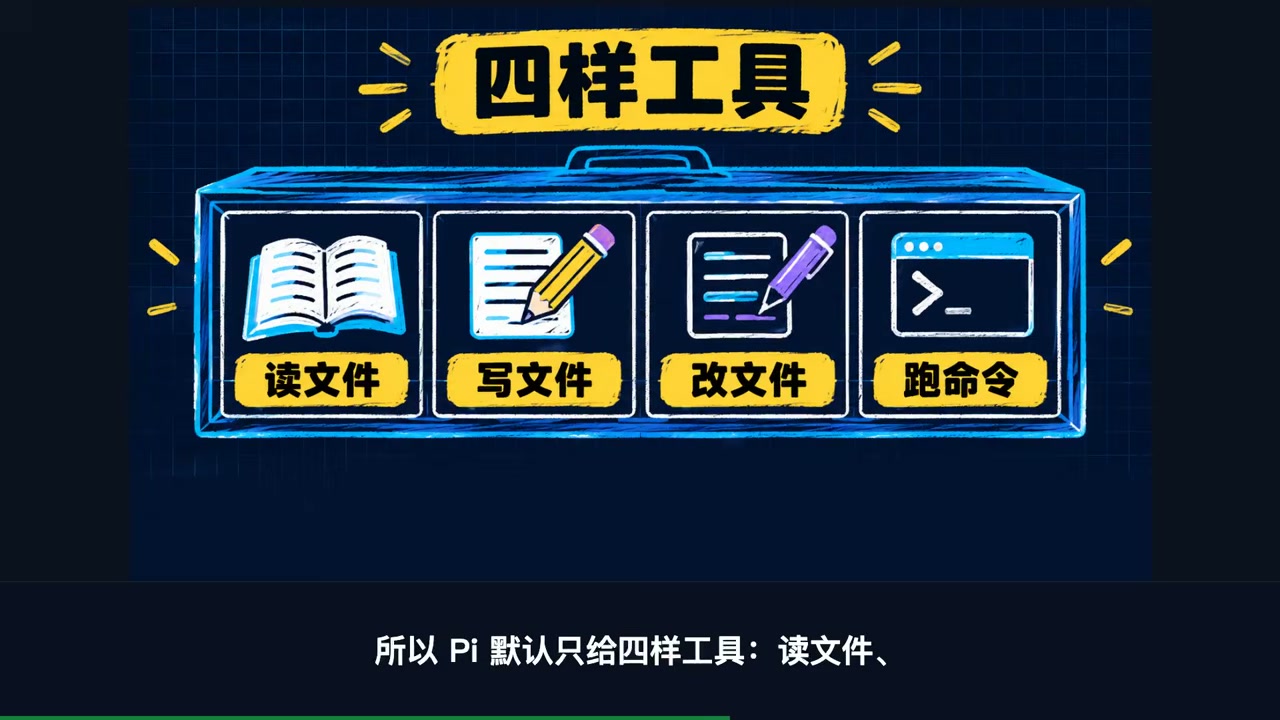
| 默认工具 | 4 个:read / write / edit / bash |
| 扩展方式 | TypeScript 扩展,在自己进程里加载 |
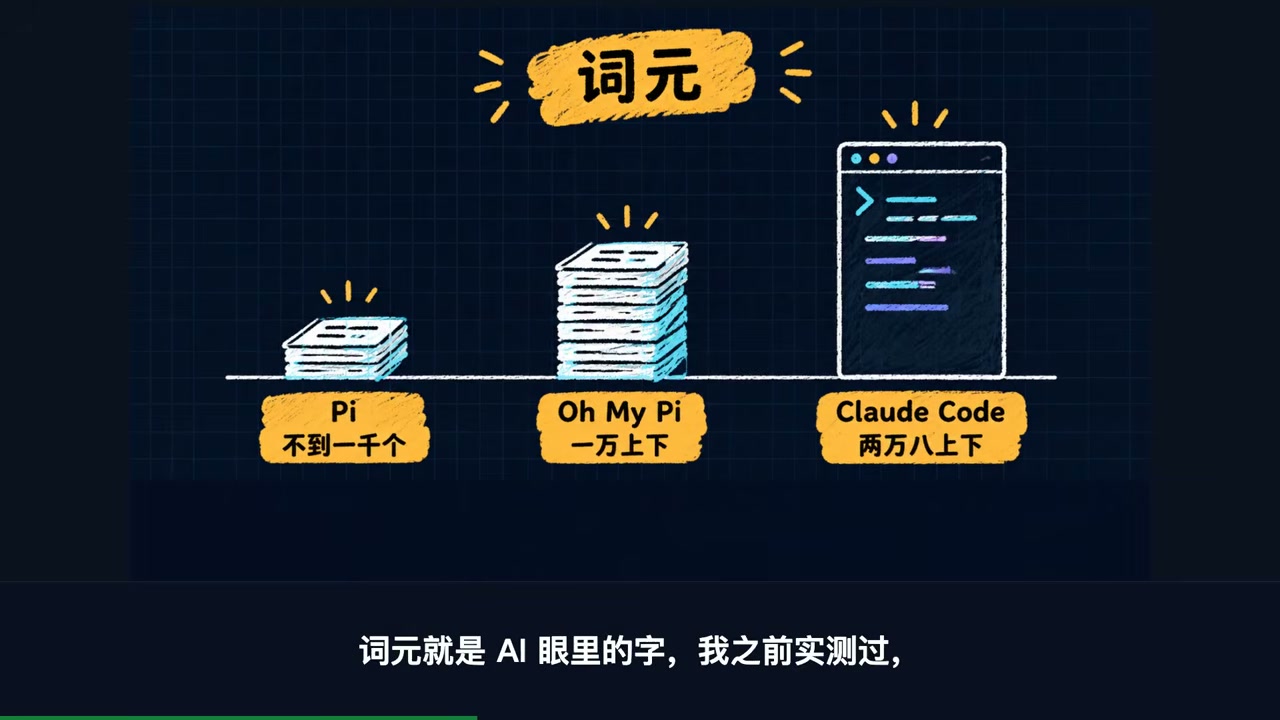
他的判断依据是:现在的前沿模型都是强化学习训出来的,天生就知道 Agent 该怎么干活,没必要再用一万词的说明书教一遍。这话有旁证——Terminal-Bench 2.0 的榜单上,Pi 排到过第 6 名(2025 年 10 月那一版),而那时它连上下文压缩功能都还没加上。
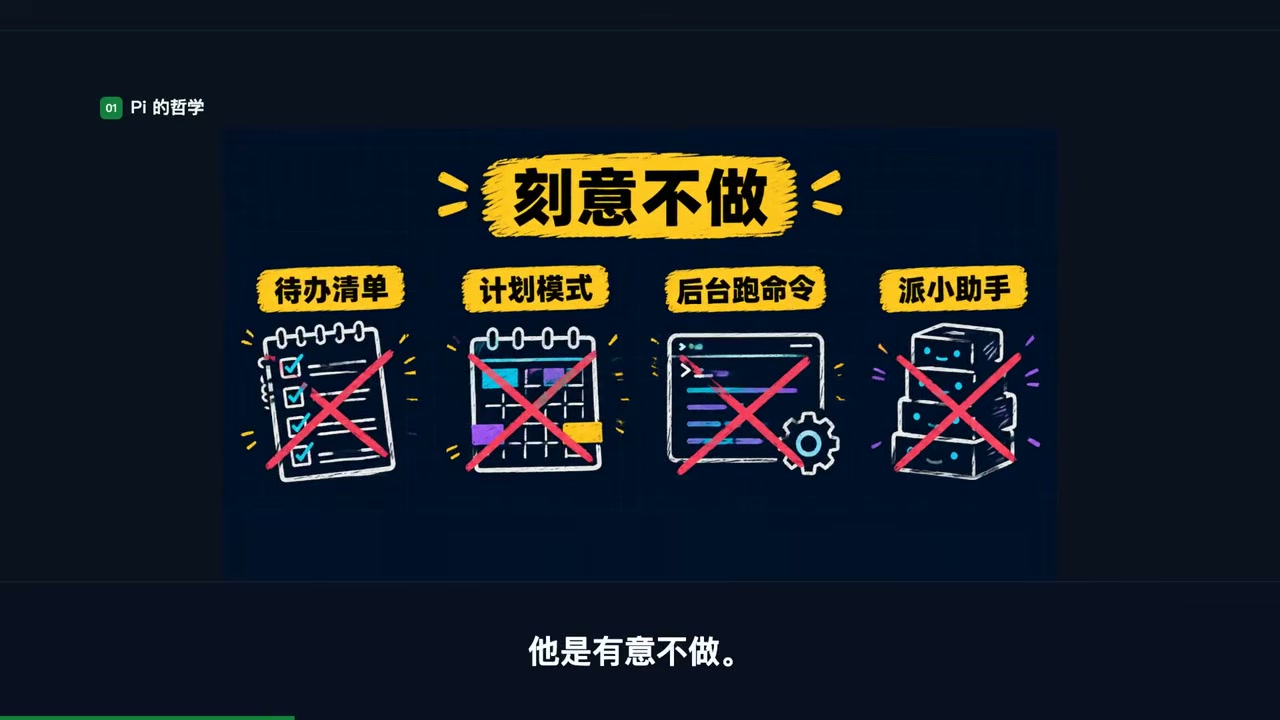
二、Pi 刻意不做的五件事
想明白它省掉了什么,才算明白它为什么省。
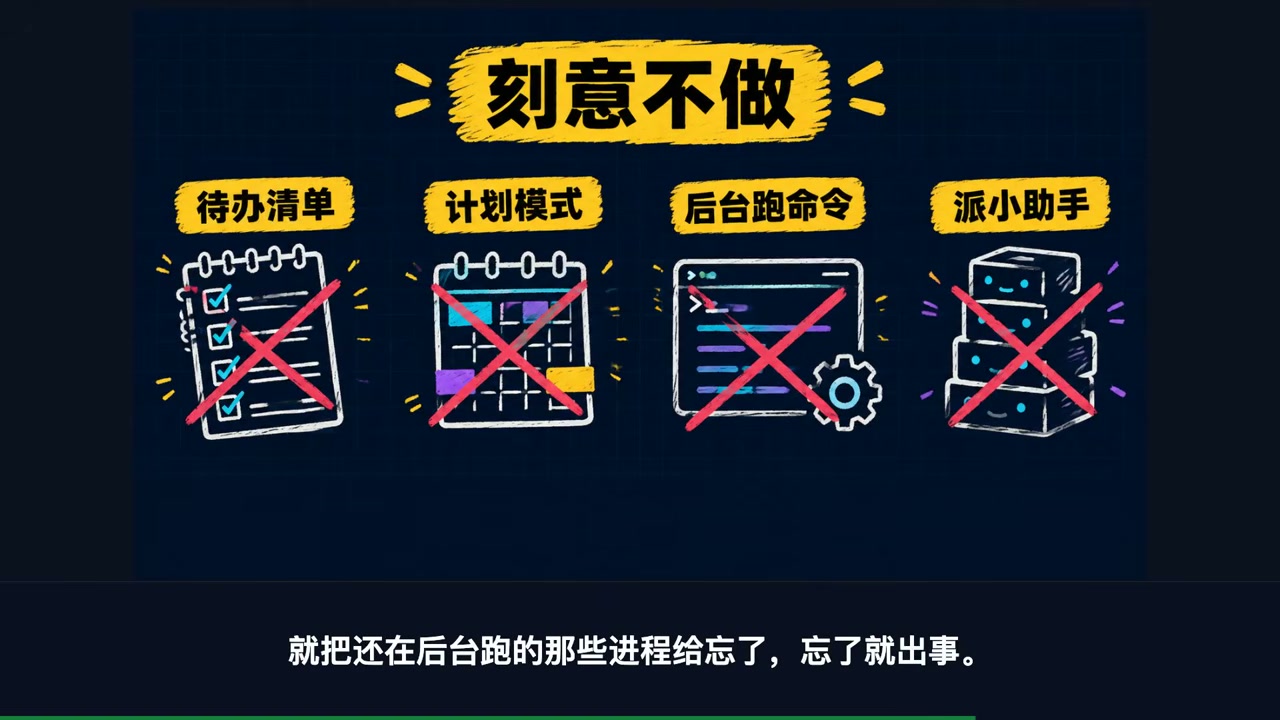
1. 不做待办清单。 他的原话是待办清单「一般让模型更困惑,而不是更帮忙」——那东西加的是模型要额外追踪和更新的状态,出错机会反而更多。要记进度,就写进一个 TODO.md,简单、可见、归你管。
2. 不做计划模式。 他要的是「看得见每一步在干嘛」。同样用文件承载:PLAN.md 能跨会话共享,还能跟代码一起进版本库。
3. 不让命令跑后台。 例子很具体:Claude Code 早期版本在上下文压缩之后,把还在后台跑的进程全忘了,用户只能手动 kill。要跑长任务,用 tmux。
4. 早期坚决不接 MCP。 理由是 MCP server 大多把整个工具描述塞进上下文:Playwright MCP 21 个工具 13.7k token、Chrome DevTools MCP 26 个工具 18k token,还没开工就先吃掉 7%~9%。替代方案是做成带 README 的 CLI,Agent 需要时才去读——渐进式披露。得公道地说一句:Pi 现在的官方文档里已经有 MCP 了,当年那句「永不接 MCP」后来改了。
5. 不做小助手(骂得最狠的一条)。 「小助手是黑盒套黑盒」——你在外面看不见里头在干嘛,Agent 之间的上下文传递也很差,子助手一旦出错,调试极其痛苦。顺着这句,他把并行也判了死刑:「派多个小助手并行实现不同功能,在我这里是反模式」,除非你不介意代码变成一堆垃圾。
如果想先看看 Pi 本身怎么上手,之前写过一篇 Pi Agent 零基础入门:在 Mac 上一键装好,让它替你整理资料、写文章,从安装到接模型走了一遍。
三、那句「求你去 fork 他」
Pi 作者在博客结尾留了一句:
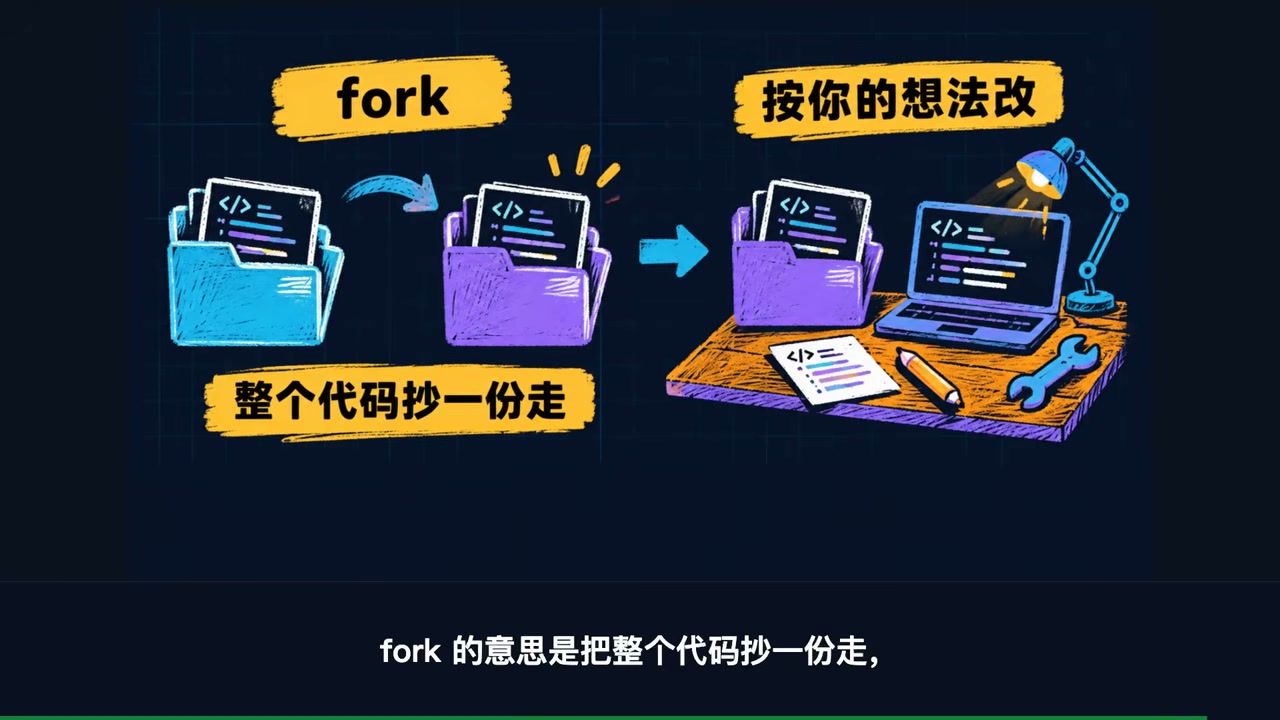
如果 Pi 不合你的需求,我恳请你 fork 它。我是真心的。
Oh My Pi 就是接住这句话的 fork——2025 年 12 月 31 日动手,后来落地成 Stencil Labs 的产品。它的首页定位只有一句:
The Pi you love, with batteries included.
也就是「你喜欢的那个 Pi,电池都给你装好了」。
有意思的是,两个人其实在回答同一个问题:一个 Agent 到底需要多少 harness? Zechner 的答案是「几乎不需要」,Bölük 的答案是「比你想的多得多」——他把这套观点写成了 《The Harness Problem》。
四、Oh My Pi 多装了哪四样
挑最影响日常的四样讲。
1. 一等公民的子助手
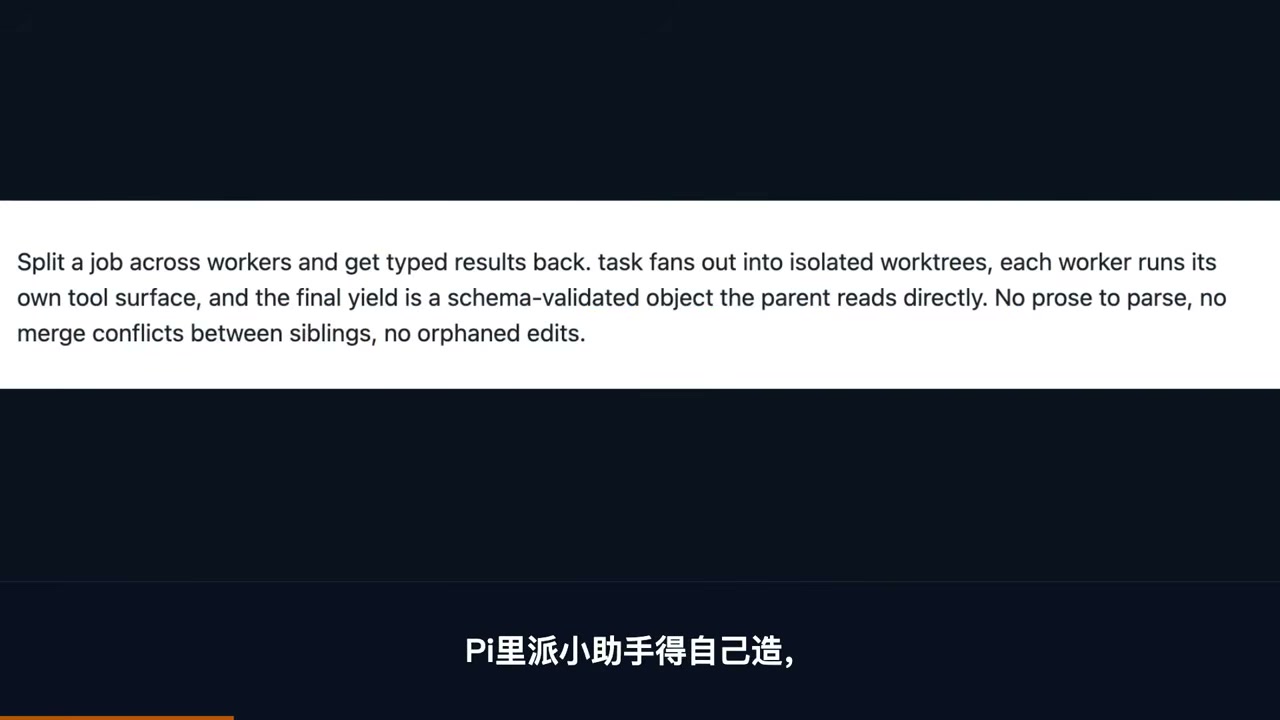
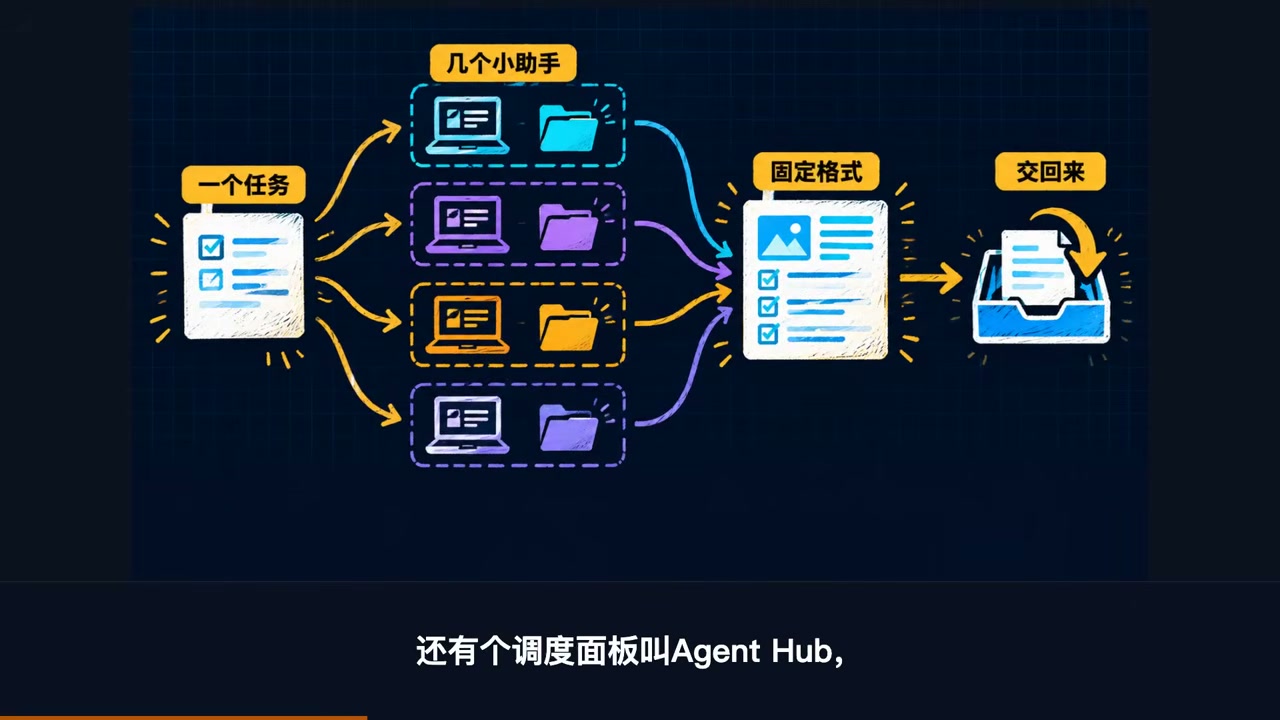
一个任务可以分给几个 worker 并行跑。每个 worker 领到一块隔离的工作区(独立 worktree)和自己的工具面;干完交回来的不是一段聊天文字,而是schema 校验过的结构化对象,父 Agent 直接读字段,不用去解析散文,兄弟之间也不会互相踩到文件。
旁边还有一个叫 Agent Hub 的调度面板(Alt+A 打开):能看到每个子助手当前干到哪一步、花了多少 token;点开能读它的实时 transcript,能发消息纠偏,能把停掉的 worker 重新唤醒,也能单独干掉一个卡死的而不影响主会话。
2. 哈希锚点(hashline)改文件
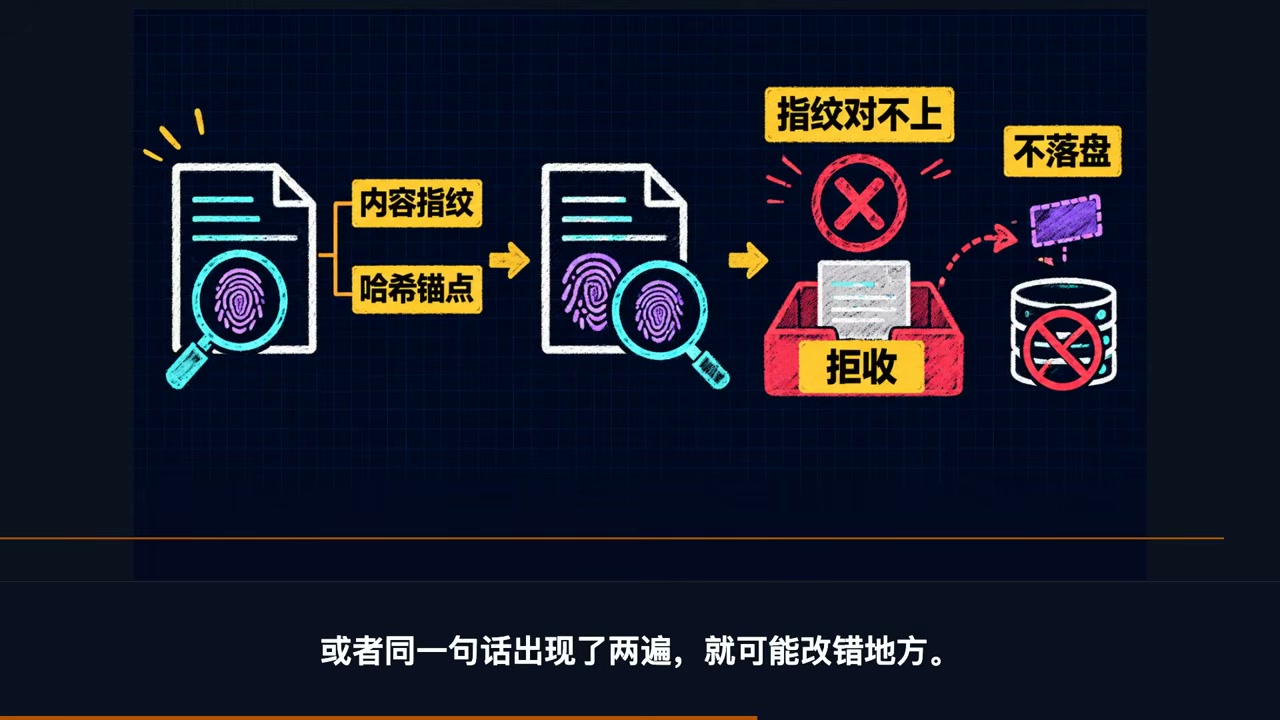
别的 AI 改你的稿子,做法是「把原话抄回去再改」。文件要是中途被别的程序动过,或者同一句话出现了两遍,就可能改错地方。
OMP 给每行内容算一个短哈希,模型直接指锚点(形如 2:f1),而不是重打一遍原文。锚点对不上,这条修改直接拒收、不落盘,你的文件不会被写坏。
3. 按岗位分模型,挂了自动换
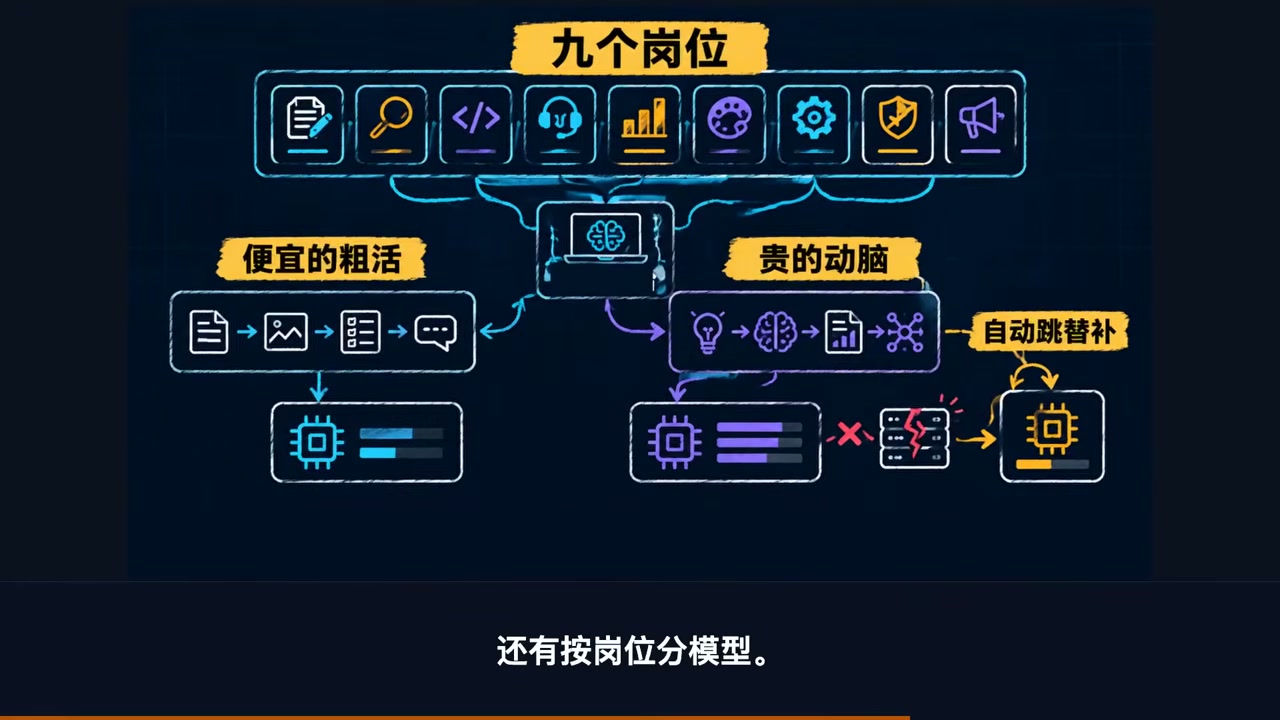
九个角色各配各的模型:default(常规)、smol(便宜,专供子助手铺量)、slow(深度推理)、plan(计划)、commit(写 changelog),外加 vision、task、advisor、tiny。
便宜的派给粗活,贵的留给动脑子的活;哪家撞了 429 或配额打满,retry.fallbackChains 里的下一家自动接手这剩下的活,不用你半夜爬起来换 key。角色之间还能挂不同的模型,路径级的 enabledModels 甚至能做到同一个仓库一个模型集、另一个仓库另一个。
4. 生态继承:你原来那些设置不用重做
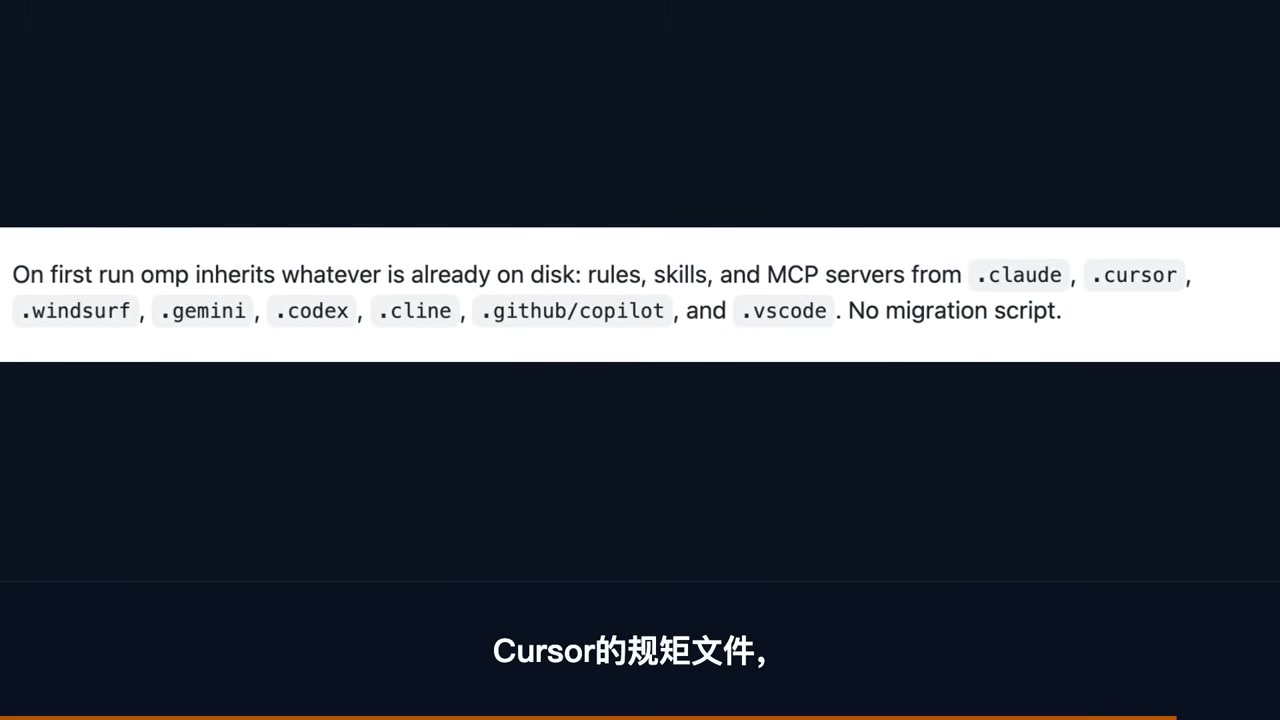
这条最容易被忽略,但省事。OMP 第一次启动就直接读你硬盘上本来就有的规矩文件——Cursor 的 MDC、Cline 的 .clinerules、Codex 的 AGENTS.md、Copilot 的 applyTo,一共八种格式,原生读取,不用导出导入、不用 YAML 转 TOML。上一代工具写的插件,大多也能靠一层兼容垫直接加载。
这四样加上 31 个内置工具、LSP/DAP 调试、约 8 万行 Rust 内核,我在 Oh-My-Pi(OMP)完整上手:32 个内置工具 + 多模型路由 里逐个跑过一遍,想看配置细节可以直接接上。
五、但「装得多」就一定更好吗?实测数据在这
这是最该泼冷水的地方。Composio 用同一个模型(DeepSeek V4 Flash)跑 30 个真实任务,8 个 harness 同台,结果如下:
| 指标 | Pi | Oh My Pi |
|---|---|---|
| 通过任务 | 20 / 30 | 17 / 30 |
| 中位耗时 | 132.2s | 272.4s |
| 平均 token / 任务 | 558,885 | 742,283 |
| 单次成功成本 | $0.028 | $0.103 |
在这套基准上,原版 Pi 赢了。 差三个任务,单次成功成本不到四分之一,中位耗时不到一半。完整基准在这里。
但有两个注脚必须一起读:
- OMP 是这 8 个 harness 里的第二名。它打的对手包括 Claude Code(16 通过)、Codex(16)、OpenCode(14)——也就是说它比主流选手都强,只是输给了自己的上游。
- OMP 的额外能力有硬证据:只改编辑格式、不换模型,Grok Code Fast 1 的成功率从 6.7% 干到 68.3%;16 个模型平均提升约 15 个百分点;Grok 4 Fast 的输出 token 少用 61%。弱模型从这套护栏里获益最大。
所以结论不是「Pi 更好」或「OMP 更好」,而是:这套东西要按任务类型分家。 一次性、小范围、要快要便宜的活,Pi 的极简是对的;涉及多文件、用的是弱模型、要改得准的活,OMP 的护栏才算得过来。
六、把 OMP 架成一条内容流水线
接上一节,聊个更实际的场景:让 AI 跑内容生产。
一条成熟的口播内容产线,量级大致是这个形状:
| 环节 | 做法 |
|---|---|
| 岗位说明书 | 每个岗位写清「怎么写、怎么查、怎么合、润到哪」,一份活一套规矩 |
| 调研 | 派一批 worker 查原始资料、盯证据,谁也不碰谁的文件 |
| 写稿 | 按分章切块,每块单独跑 |
| 编排 | 稿子分章分镜编排,能同时跑的都同时跑 |
| 验收 | 多个模型同时审,主模型再单独过一遍 |
| 润色 / 标题 | 多模型同时出意见,主模型汇总 |
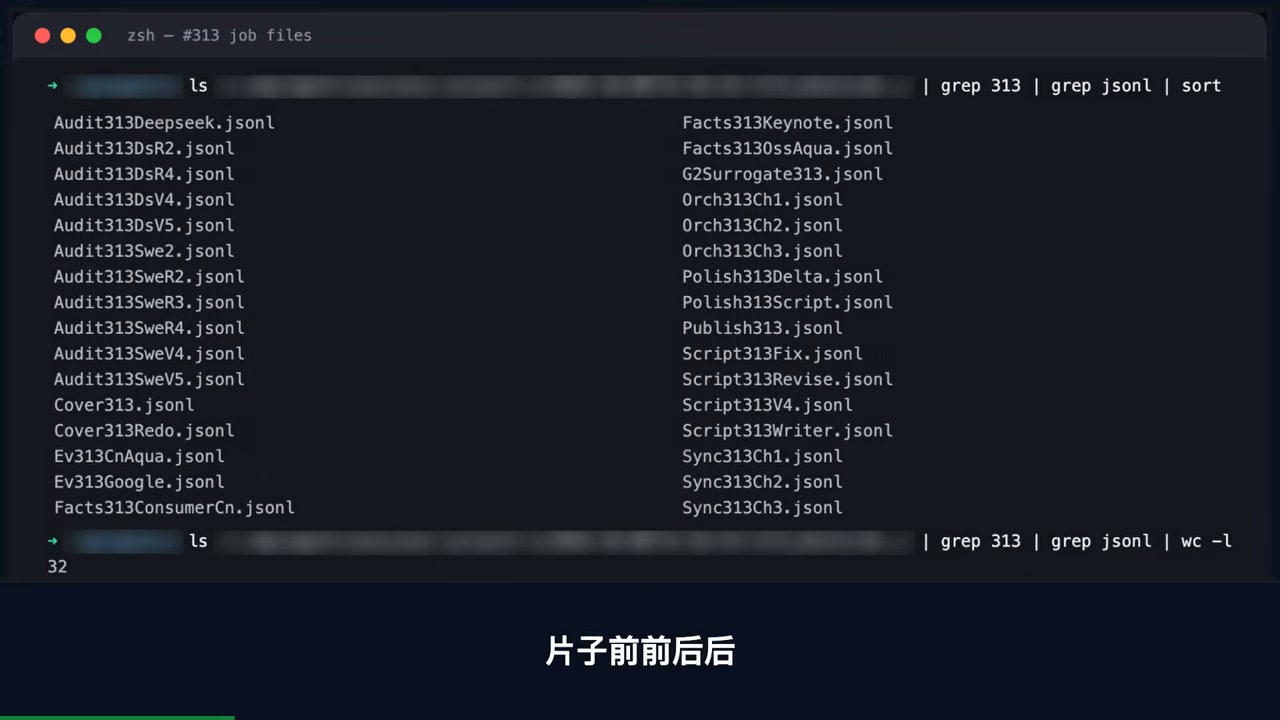
成熟产线的量级参考:登记过的岗位说明书(skill)三十多个,口播一条线出了三百多集,单集片子前后派出 30 多个 worker 同时跑,最近 30 天累计跑了 400 多个子任务。
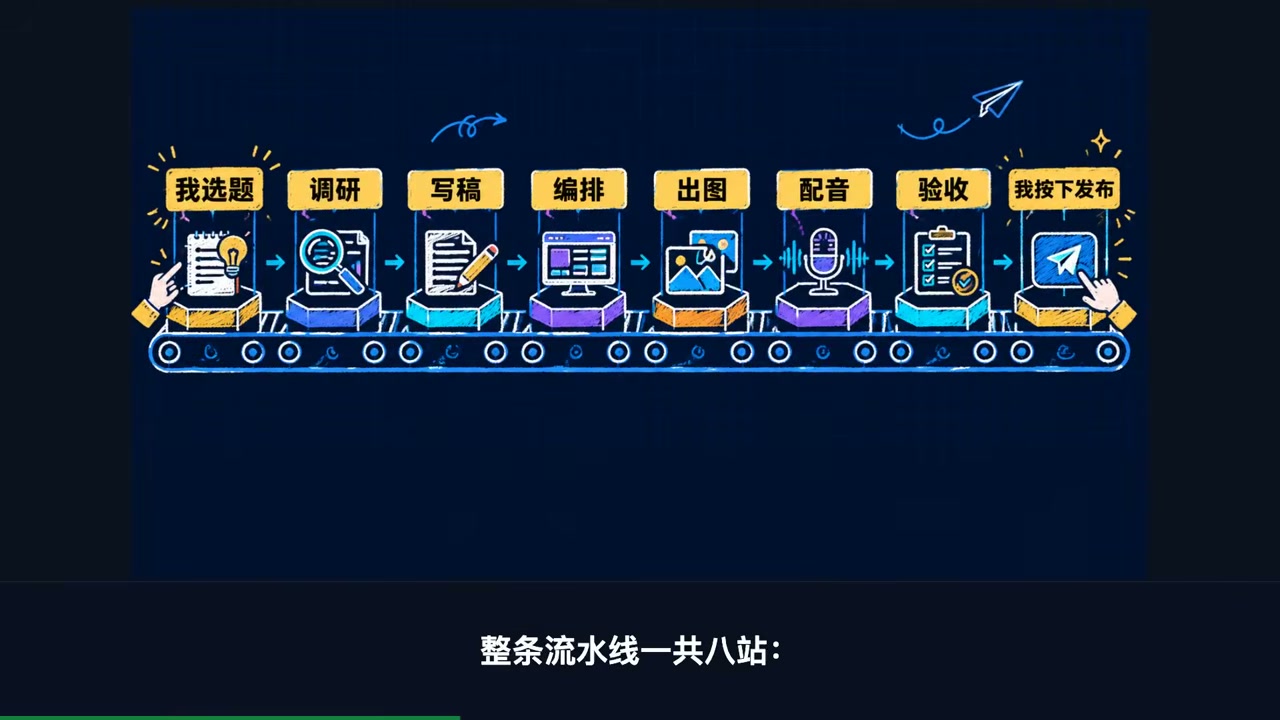
整条流水线八站——选题、调研、写稿、编排、出图、配音、验收、发布——只有两站离不开人:选题和按下发布。
关键在分工原则:调研的只管查资料,核查的只管对原文,润色的只管改文字,谁也不碰谁的文件。
这正好接回第二节那个争议。Mario 反对并行,说的是写代码——怕两个 AI 同时改同一份代码互相踩。而内容生产天然可切分:调研、核查、润色三块活互不依赖,隔离工作区一开,并行就成立了。
「互不依赖」不是修辞,是能不能并行分活的唯一判据。
多 Agent 在终端里并排跑、各自可观察的玩法,我另外写过一篇 多 Agent 并行:5 个 Agent 协作干一件大事,可以对照着看。
七、缺点也得摊开说
1. 防护不如系统级沙箱。 OMP 的默认工具跑在你本机的全线权限下,这一关比不上 Codex 那种从操作系统层面设的围栏。想隔得更彻底,还得自己再套一层容器,把它单独关进一个小房间——Pi 侧有 pi-sandbox 这类插件可以补。
2. 比 Pi 重。 Pi 的 system prompt 加工具定义加起来不到 1000 个 token(作者自己写在博客里的),OMP 连规矩带角色塞掉一万上下,占的都是模型一次能看见的那点地方。上面那张基准表里 token 用量差三成多、中位耗时差一倍,都是这笔账。小项目未必划算。
3. 发版太密。 最近一个月就发了 40 多个版本。升级勤快是好事,赶上小毛病也是真的。生产环境建议固定一个版本跑一段时间,别每次发版就跟着升。
八、照做三件
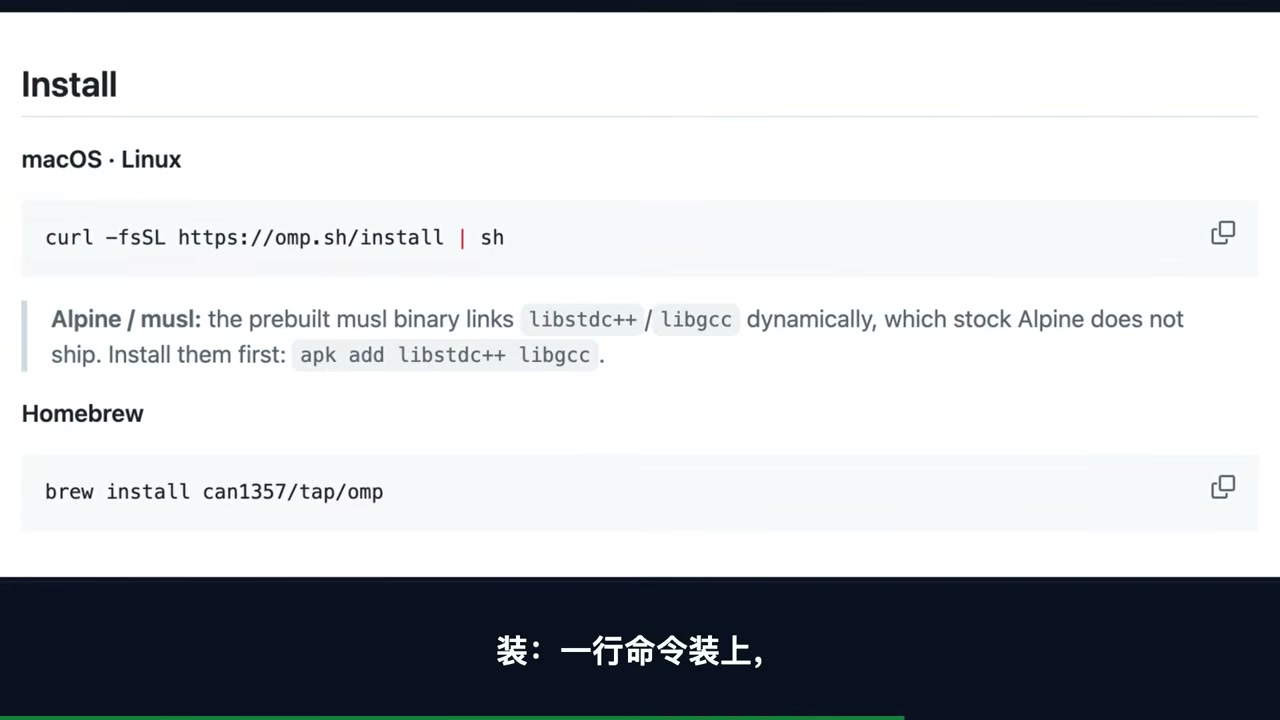
装
macOS / Linux 一行:
1 | curl -fsSL https://omp.sh/install | sh |
Homebrew:
1 | brew install can1357/tap/omp |
分活
把互不碰同一份文件的活切成几块,再派给小助手同时跑。判断标准只有一条:这块活和别的活,会不会改到同一个文件。 会,就串行;不会,并行。
分岗
粗活指定便宜模型(smol),动脑子的活留给贵的(slow / plan),再给每个岗位排好替补链。
最后是选底座时该看的三条
| 标准 | 问自己 |
|---|---|
| 并行分活 | 能不能把活摊开干,而不是一次只干一件? |
| 岗位换模型 | 能不能让不同岗位用不同价位的模型,一家挂了自动换? |
| 改文件准不准 | 文件被中途改过,会不会改错地方? |
总结
Pi 和 Oh My Pi 其实是同一个问题的两个答案:一个 Agent 到底需要多少 harness?
Zechner 的答案是「几乎不需要」,用不到 1000 token 的说明书和 Terminal-Bench 第 6 名背书;Bölük 的答案是「比你想的多得多」,用哈希锚点把一个弱模型的成功率从 6.7% 拉到 68.3% 背书。两个人都有证据,也都留下了完整的反驳空间。
我自己的取舍标准收敛成上面那三条:能不能并行分活、能不能按岗位换模型、改文件会不会改错。 这三条过了,OMP 值得装;过不了,Pi 那套极简才是更省心的选择。
顺带提醒一句,选工具这件事这两年变得太快。Terminal-Bench 的榜单一月一换,模型厂商一家的 API 一周能改两次规格。与其追榜单,不如盯住「你手上这套工具,能不能把活摊开干」——这个问题的答案,比任何跑分都更接近你实际的产出。
本文引用的基准数据来自 Composio 对 8 个 harness 的同模型对照实验,终端基准与官方文档均已附链接;不同任务类型下两者的优劣会反转,选购前建议按自己的实际负载再验一遍。
你手上现在跑的是哪一套?是极简内核还是开箱即用?评论区聊聊你的选择和踩过的坑,觉得这篇有用的话欢迎收藏,转给正在挑 AI 工具的朋友。