Pi Agent 必装 8 个插件实测:补齐权限、MCP、多 Agent、记忆、联网与浏览器自动化的完整工程方案
最近在 Pi Agent 上做插件组合的端到端对比时,发现一个反直觉的事实——Pi Agent 本身只内置了「文件读、文件写、文件编辑、Bash 执行」四个能力,几乎是最小化的 harness,这种克制反而成了它能跑生产的原因。但也正因为最小化,它在 Agentic Coding 过程中必然要靠插件补齐——权限、MCP、多 Agent、记忆、确认、联网、浏览器这几条主线,任意一条缺位,工作流就会断。
下面把我连日蹲点测试、对照官方文档和实际项目里摸出来的工程要点,按「插件定位 → 安装路径 → 配置文件位置 → 实测用法 → 与其他插件的协作点」五条线索整理成一篇笔记。除了七大核心插件外,还会顺带讲一个彩蛋级别的「等 Agent 出结果时玩游戏」插件,并用一个端到端的个人财务 Web App 任务,把 7 个插件的真实协作流程串起来。
如果你刚装好 Pi Agent,建议先看一下之前整理的 Pi Agent 零基础入门 那篇,把那 4 个原生能力、配置文件路径、模型接入方式先打通,再回头看本文会顺畅很多。
1. pi-sandbox:第一道护栏,装完 Pi 第一件事
Pi Agent 的「轻」是把双刃剑——它默认对文件系统、命令行、网络没有任何限制,意味着 Agent 在你不知情时,完全可能 .env、~/.ssh/、系统级文件任意读写,或者在后台静默执行 rm -rf。装不装 pi-sandbox,差别是「裸奔」和「带围栏」。
安装一行就够:
1 | pi install npm pi-sandbox |
配置文件在 ~/.pi/agent/ 目录下,文件名就叫 sandbox,里面存的是「动态生成的授权规则」——它在每次你和 Pi Agent 交互时,把你「同意」或「否决」过的决策,实时落盘成规则。所以它不是「预设白名单」,而是「按需生长」:第一次写 .env 时它会跳确认框,你点「拒绝」后,这条规则就会出现在配置里,之后 Pi 也不会再问第二次。
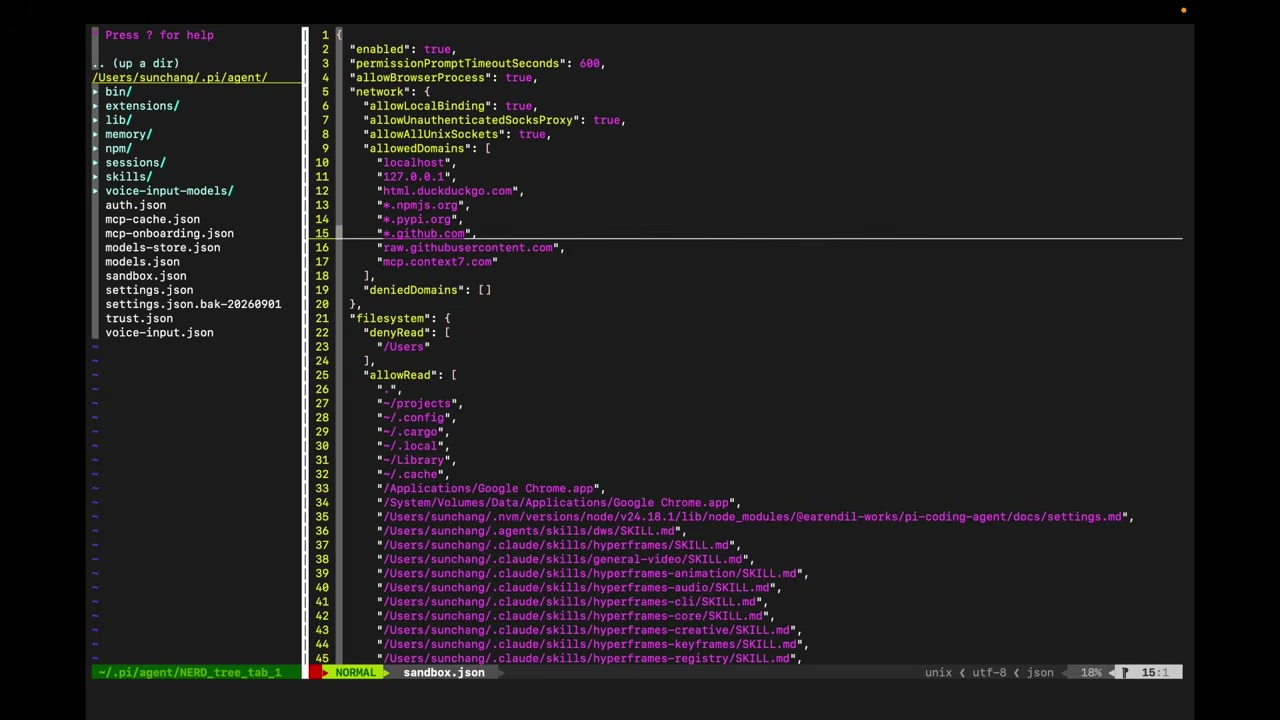
规则覆盖范围相当完整:文件读取目录、用户目录、特殊文件写保护、域名访问白名单、URL 授权全部能管。最关键的,它默认把一些敏感文件(如 .env、~/.ssh/ 下的私钥)标记为「不允许写」,Agent 一旦尝试,会立刻弹出确认框让你否决。
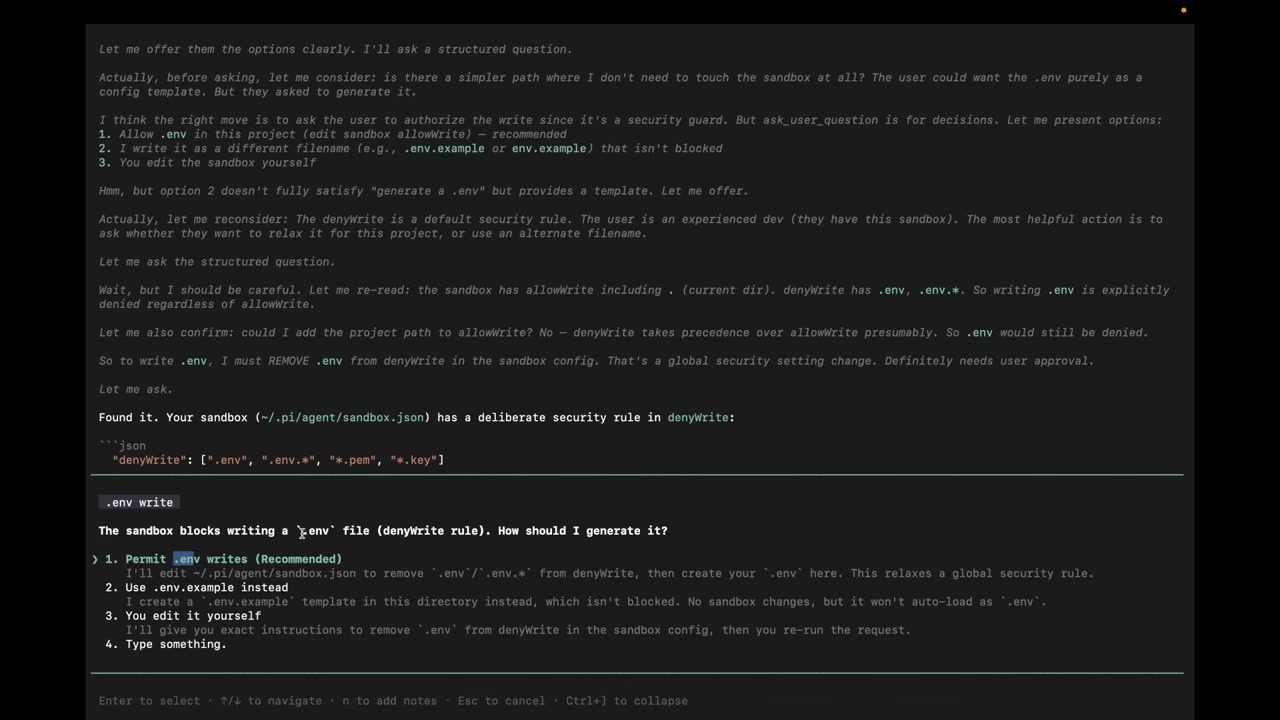
把这点打在小目标里看,工程意义在于——它把 Agent 的能力边界从「事后兜底」提前到「事前阻断」。很多 Agent 工具是「出问题后回滚」,而 pi-sandbox 是「出问题前确认」,在生产工作流里后者更省事。
必装指数:⭐⭐⭐⭐⭐ 装完 Pi 第一时间就装,不要等出事故再补。
2. MCP:把外部工具和数据装进 Pi 的「嘴」
智能体要在真实业务里干活,不可能不调 MCP——读数据库、查文档、画原型、调内部 API,几乎全靠 Model Context Protocol 这套接口规范。Pi Agent 默认没接 MCP,装上 MCP 插件后,补齐的就是这一块。
安装同样简单:
1 | pi install npm MCP |
但 MCP 的配置不在 ~/.pi/agent/ 下,而是在 ~/.config/mcp/mcp.json——这点很多人会踩坑,装完发现不生效,其实就是改错了文件路径。
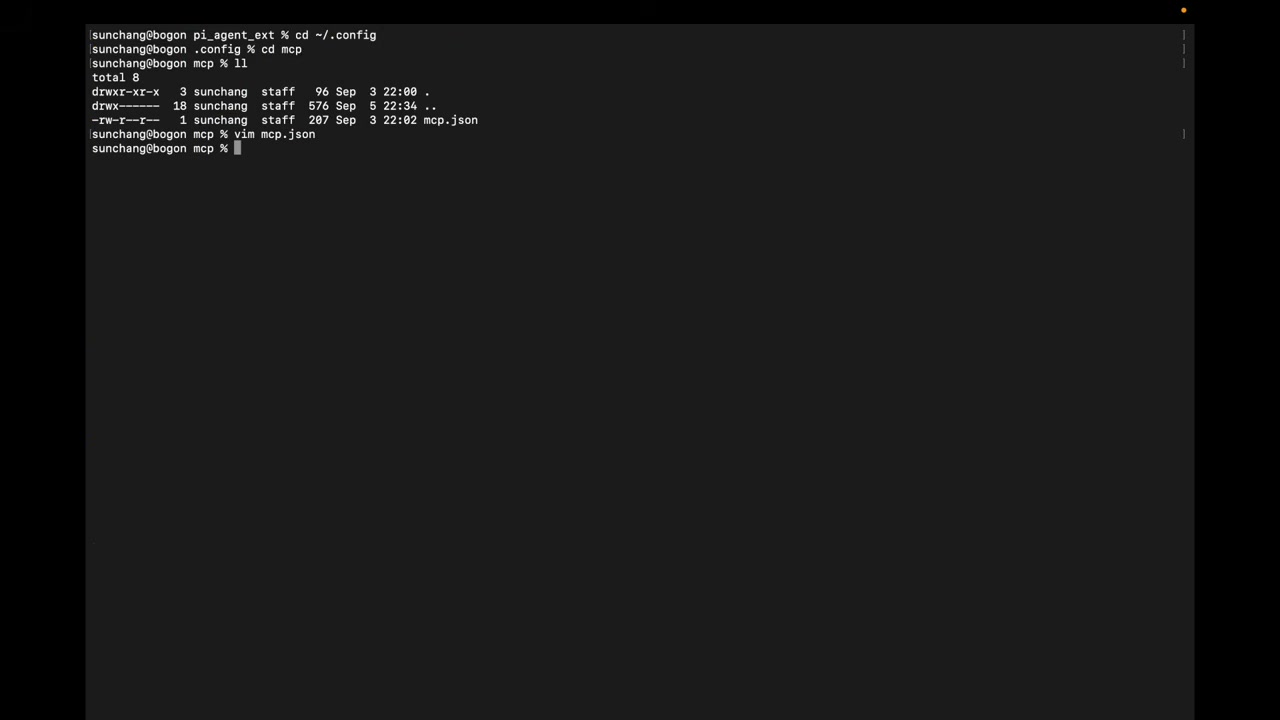
mcp.json 的结构是标准 MCP 配置——mcpServers 字段下挂若干个服务,每个服务用 command + args 或 url 启动。我自己常用的 Stitch MCP(一个 AI 设计生成服务)配置示例:
1 | { |
配置完成后,在 Pi Agent 里直接说「用 Stitch 帮我做个 To-do Web App」,它会自动识别到 Stitch MCP 已经注册,直接调用接口完成任务——整个判断和调用过程是 Agent 自己做,不需要你手动 @mcp 触发。
注意点:MCP 服务依赖网络、密钥或本地进程。装好后第一次用,建议先让它跑一个最简单的请求(如
fetch 当前时间),确认链路通了,再上复杂任务。
3. Pi-Herdr-Agents:多智能体编排,一条命令拉起 Agent 团队
如果说 pi-sandbox 是「护栏」、MCP 是「嘴」,Pi-Herdr-Agents 就是「大脑」——它不只是 Pi 和 Herdr 的桥接,而是自带一套预定义的多 Agent 团队和工作流引擎。
装上之后,不需要再额外装任何 subagent 插件,它就帮你预定义好了 Planner(任务规划)、Scout(代码侦测)、Worker(编码)、Tester(测试)等角色。你只需要用一条斜杠命令:
1 | /subagent Scout "Read the code and summarize functionality" |
它会自动在 Herdr 环境里生成一个子 Agent 面板,主 Agent 界面用一个状态框显示每个子 Agent 的进度,并且主 Agent 不会被 block——你可以在主界面继续操作,子 Agent 在旁边 pane 独立工作。
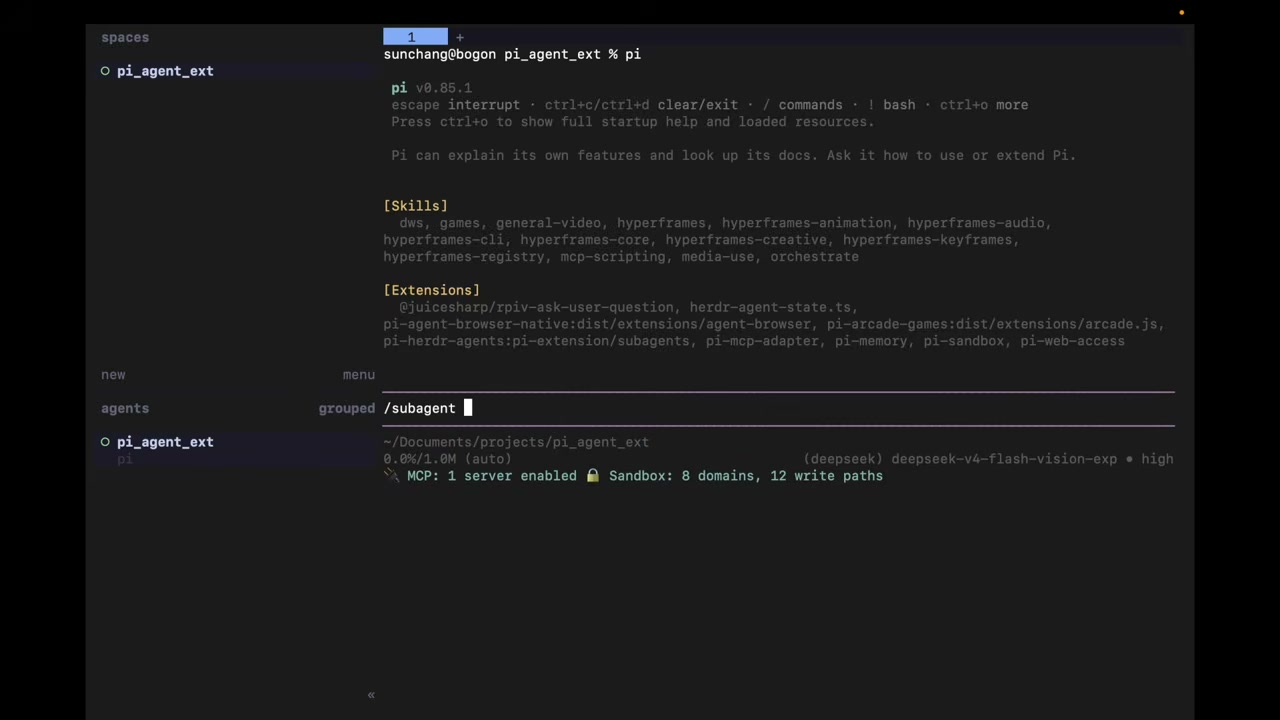
这条线的工程价值在于——它把「多 Agent 协作」从「自己拼装 subagent 工具链」降级为「一条命令」。传统做法需要自己写 subagent 注册逻辑、状态同步、消息传递,Pi-Herdr-Agents 直接帮你做掉。
子智能体的优先级覆盖机制
子智能体的定义文件有三处可以放,优先级从高到低:
- 项目级:
<项目根目录>/.pi/agents/(最高优先级,覆盖下面所有) - 全局级:
~/.pi/agents/(覆盖下面的包级) - 包级:
~/.pi/agent/npm/node_modules/pi-herdr-agents/agents/(最低,只能作为默认值)
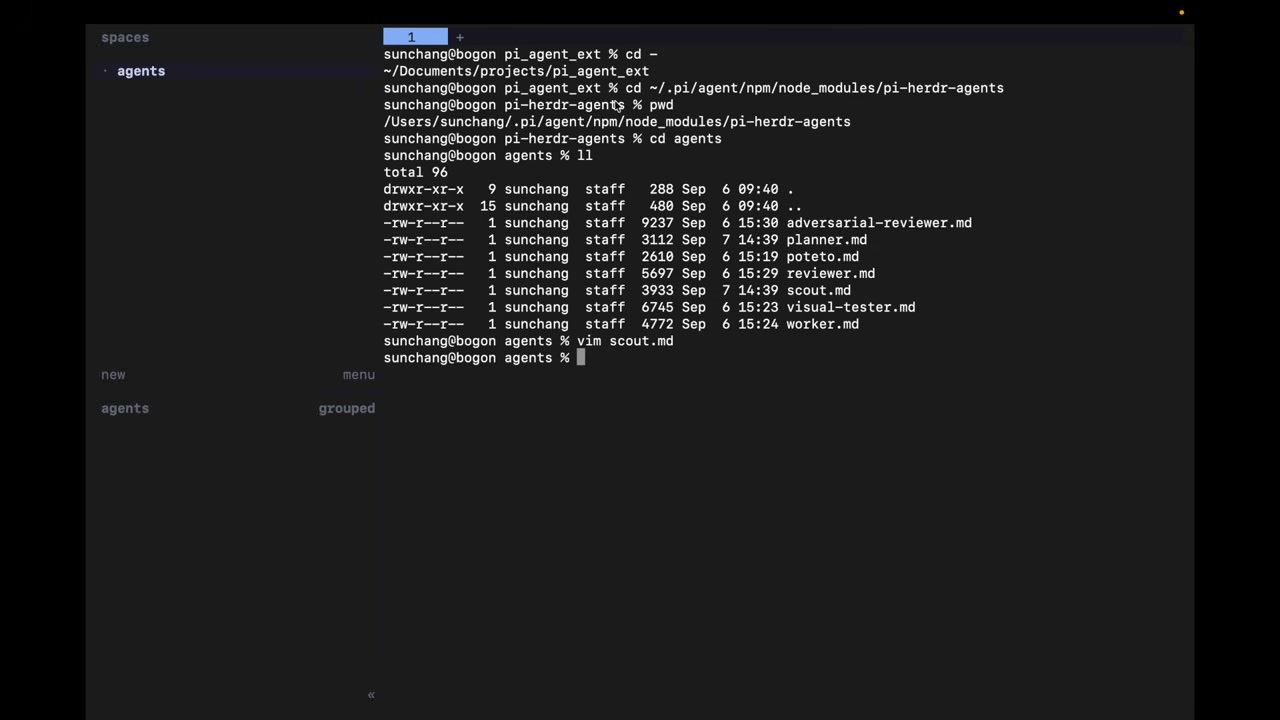
把这个机制打在小目标里看,意味着同一个 Pi Agent 在不同项目里可以有不同的「团队」——A 项目用 Planner+Scout+Worker 的标准团队,B 项目可以换成 Architect+Implementer+Reviewer 的另一套。改的只是项目下的 .pi/agents/ 文件,不需要动全局,不需要重写 Pi-Herdr-Agents。
如果你对「不同项目用不同工作流」这条线感兴趣,可以参考 GPT-6.1 Sol vs Opus 5.5 那篇实测里关于「不同任务用不同模型」的策略,工程哲学是相通的——配置分层 + 项目级覆盖,而不是单点硬编码。
4. pi-memory:跨会话长期记忆,把每次决策沉淀下来
Pi Agent 的 Session 管理能力极强,但它的设计哲学是「Session 之间不共享」,所以下次开新会话时,你之前告诉它「我习惯用 pnpm 而不是 npm」「我的项目放在 ~/work」这些偏好,又要重新说一遍。
pi-memory 正好补齐这点。安装:
1 | pi install npm pi-memory |
装完首次启动 Pi 后,会在 ~/.pi/agent/memory/ 下生成三类文件:
memory(无后缀,长期记忆文件):Agent 把跨会话需要保留的偏好、决策、约定写在这里daily/<日期>:每天的工作记忆,按日期归档recovery/:用memory forget删除的记忆先暂存这里,可以恢复
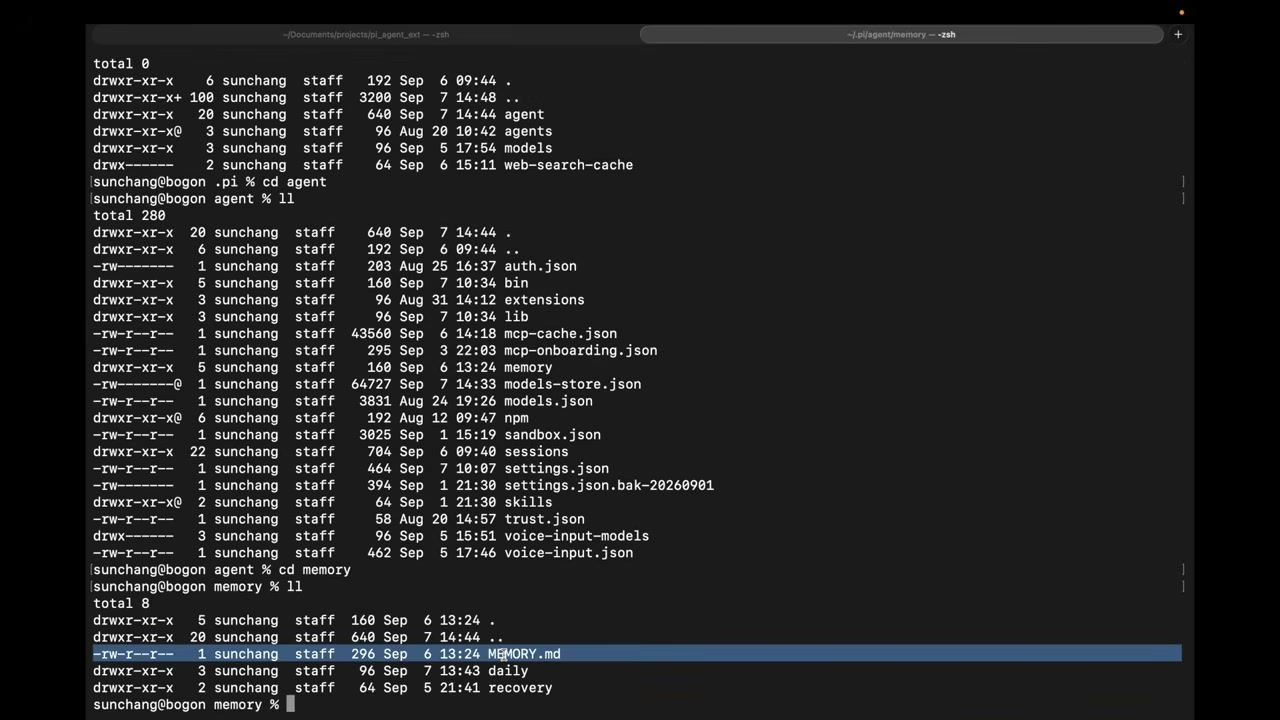
把这条线打在小目标里看,它的工程意义不只是「记忆」,而是「决策的可追溯性」。任何 Agent 在生产环境跑久了,都需要回答「为什么之前做这个决定」——传统做法要靠人去翻 Session 日志,pi-memory 直接把决策写进结构化文件,可检索、可恢复、可追溯。
进阶选项是搭一个 QMD 语义数据库,把历史对话向量化,然后用 memory search "我之前提过的部署偏好" 这种语义查询拉回来——比纯文本搜索准一个量级,适合用了几个月后想回查具体偏好的场景。
注意点:
memory forget命令删除的内容不是真删,而是先放在recovery/。如果要彻底清理,记得也把 recovery 目录清掉。
5. ask-user-question:Human-in-the-loop,从「自由发挥」到「结构化确认」
Agentic Coding 最怕的不是「Agent 不够强」,而是「Agent 太强不问了」——它自己脑补你的需求、自己选技术栈、自己写完全部代码,最后交付一个完全不是你想要的东西。ask-user-question 这个插件就是给 Pi 装上「每次重大决策必须问用户」的能力。
安装同样一行:
1 | pi install npm ask-user-question |
它的特点是多题问卷形式——Agent 一次抛多个问题,每个问题独立选择题(单选/多选/确认),你可以在 Submit 之前用左右箭头切换修改,确认无误再统一提交。这比传统那种「Agent 一次问一个、用户一次答一个」的串行交互效率高很多。
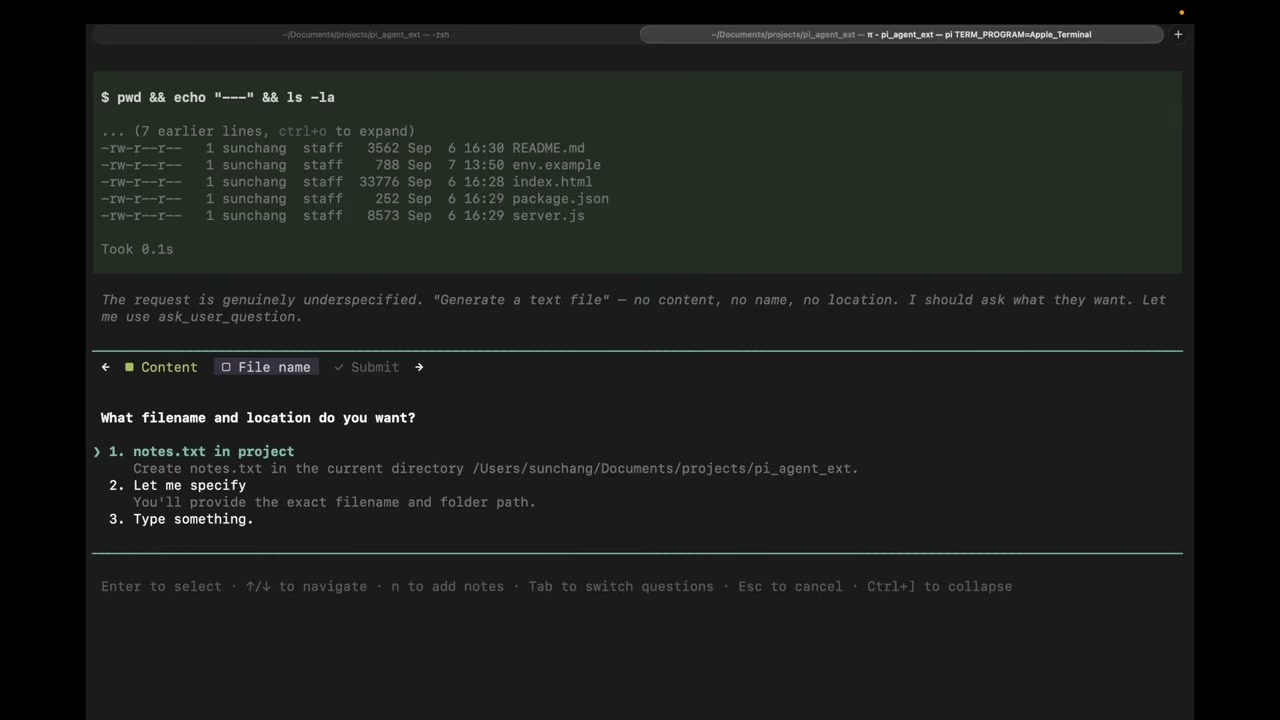
实测里我让它「帮我生成一个文本文件」(故意没说内容、没说名字),它立刻触发 ask-user-question,弹出两个问题:内容、文件名——完全是结构化选择题,用户做填空就行。
把这条线打在小目标里,工程意义是把「确认成本」降到最低——传统交互每次确认要打字,ask-user-question 让你「点一下」就完成,而且支持一次性把所有不确定项都列出来。在端到端的复杂任务里,这一条能省掉大量反复修改的来回。
6. pi-web-access:联网信息获取,从 URL 到视频元数据
调研类任务(查文档、查论文、抓网页、抓视频信息)离不开联网能力。pi-web-access 就是把这块能力装进 Pi——它支持多种渠道:
- OpenAI / Gemini 等大模型 API 的联网能力
- Brave Search 等第三方搜索 API
- URL 直接 fetch(自动补协议)
- 本地文件(PDF / 文本 / Markdown)
- 视频元数据(配合 ffmpeg / yt-dlp,可分析视频文件信息)
实测里最简单的用法是直接说 fetch sina.com,它会自动补全协议头(https://),访问新浪首页,然后默认做信息归类整合,而不是返回一堆 raw HTML。你也可以设置成「原始数据模式」拿未经处理的内容。
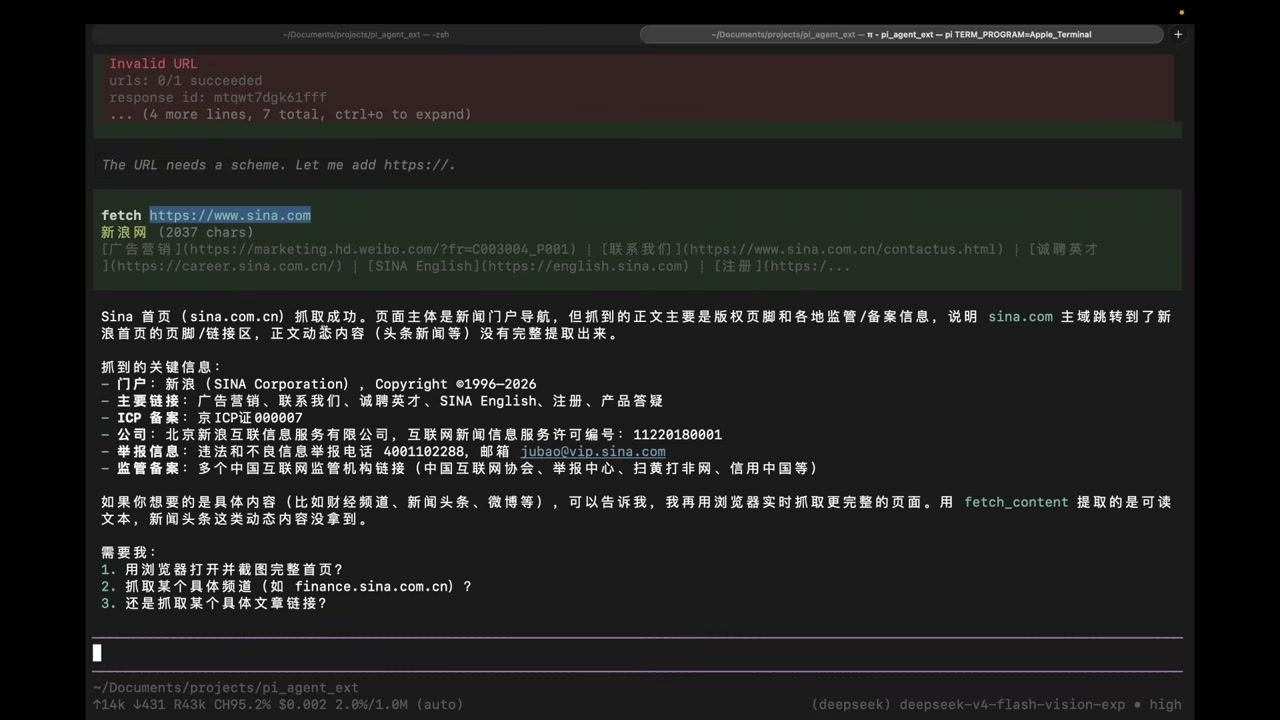
把这条线打在小目标里,它的工程价值是「调研结果的结构化」——传统做法是 Agent 抓完给你一大堆 HTML,你还要自己提炼;pi-web-access 直接给你的是「按主题分好类的摘要」,后续基于这个摘要做决策、生成报告,效率提升一档。
配置提示:不同渠道需要在 Pi Agent 的 settings 里配置对应的 API key,OpenAI / Gemini / Brave 三家至少配一家,否则只能用 URL 直接 fetch。
7. pi-agent-browser-native:浏览器自动化,把 Web App 测试拉进工作流
pi-web-access 处理的是「拿数据」,但Web App 的功能验证、截图、UI 测试这些「需要真实浏览器」的操作,它做不了——这块由 pi-agent-browser-native 负责。
它和 pi-web-access 的关键区别是:它会真的在后台打开一个浏览器,访问页面、截图、执行 JS 脚本。这意味着它可以:
- 测试 Web App 的功能(填表、点按钮、跑流程)
- 抓 Web App 的截图(用于回归测试、视觉对比)
- 验证前端脚本是否有运行时错误(只有浏览器才能跑出
Uncaught SyntaxError)
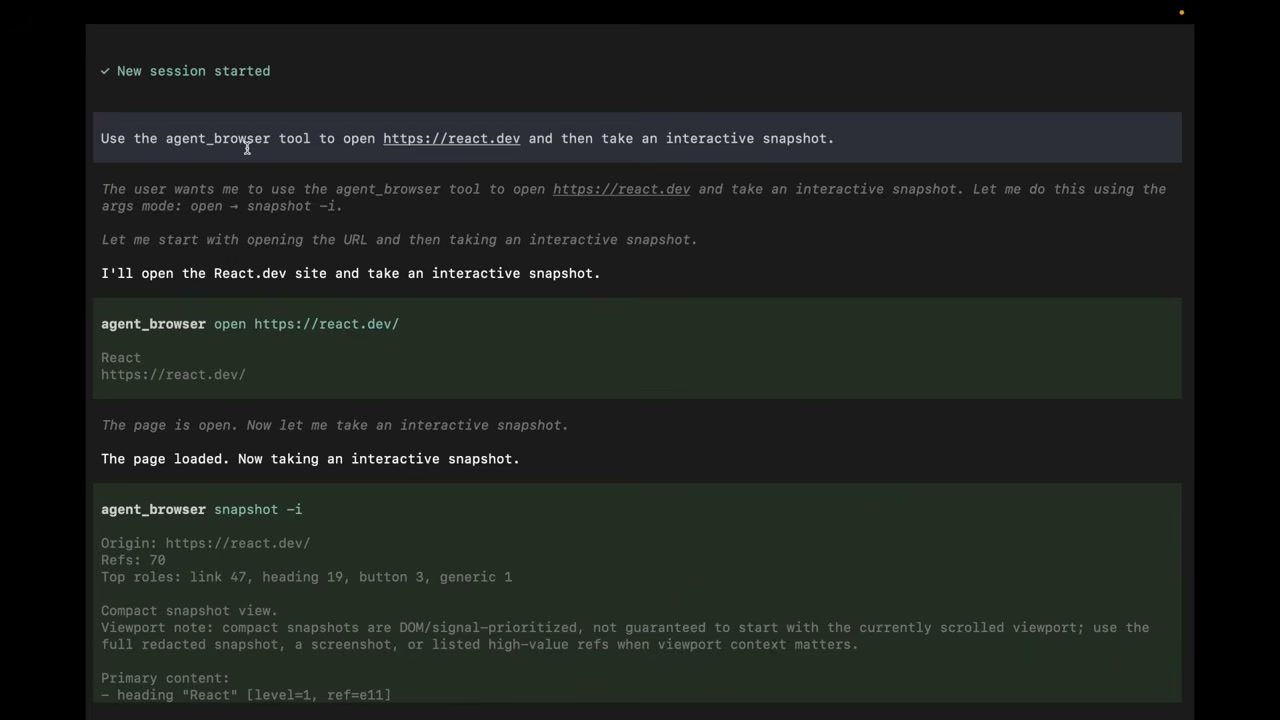
实测用法很简单,在 Pi 里直接说「访问 https://example.com」,它会自动调起浏览器工具,后台打开、截图、返回结果。把这条命令写进 Agent 的工作流说明里,后续 Agent 就能自动用它去验证 Web App。
把这条线打在小目标里,工程意义是把「Web App 的功能验证」从「手工打开浏览器、点来点去」降级为「Agent 自己跑」。在端到端的多 Agent 任务里,这通常作为最后一步——Worker 写完代码,Master Agent 用浏览器验证、截图、汇报,形成闭环。
8. pi-arcade-games:等待 Agent 时的「摸鱼神器」
最后这个不是核心功能,但是实测里用得非常多——Agent 处理长任务时,你不能干等着,需要一个能立刻打开、立刻关掉的小游戏。
pi-arcade-games 在 Pi Agent 环境下提供了大概 17 款终端游戏(贪吃蛇、俄罗斯方块、2048、Space Invaders 等),中文英文都有,而且支持自己安装更多。
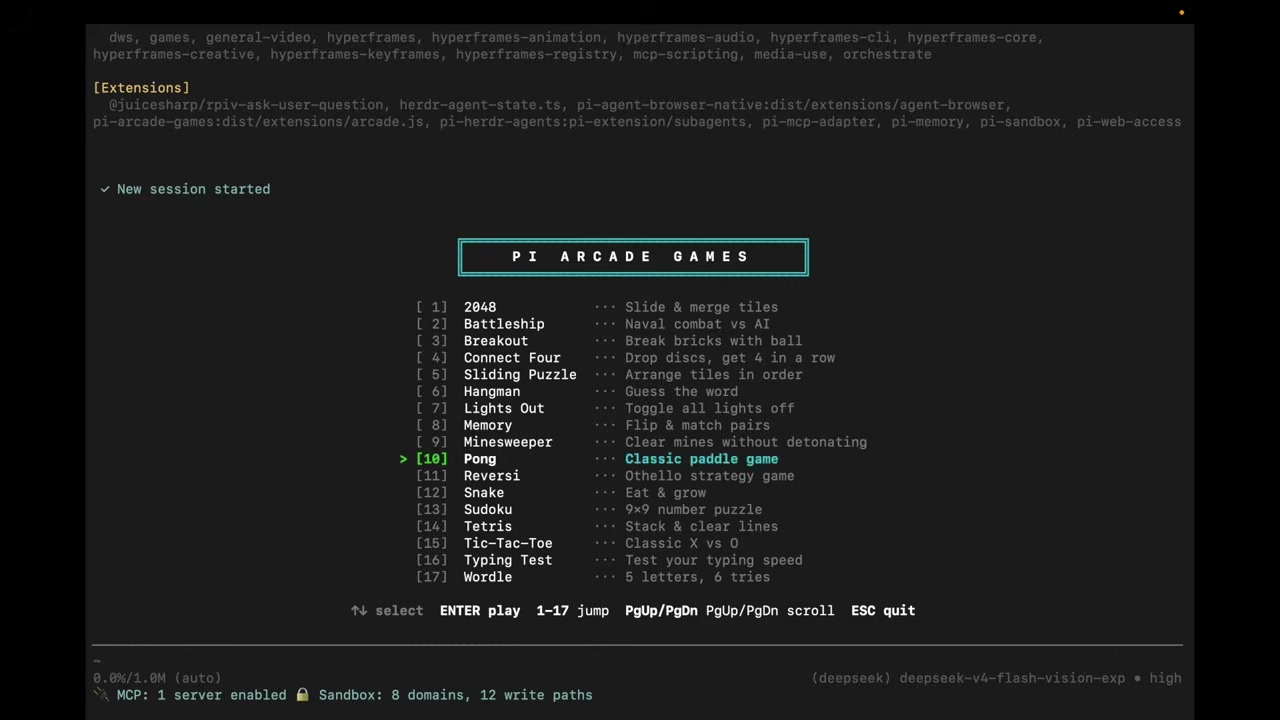
启动方式是一条斜杠命令:
1 | /game |
然后选择游戏,按 Enter 开玩,按 ESC 退出回主界面——完全不影响 Agent 的后台运行。
把这条线打在小目标里,严格意义不是工程亮点,但是「长工作流可持续跑」的关键。在 Agent 处理 10 分钟以上的任务时(比如下面实战里的端到端开发),能随时开一局贪吃蛇等结果,体验提升非常显著。
9. 综合实战:用多 Agent 团队开发一个个人财务 Web App
下面用一个真实的端到端任务,把前面 7 个插件串起来——目标是在已有的「个人记账 Web App」基础上,新增一个「个人理财」Tab。
9.1 项目目录的 .pi/ 配置
在项目根目录新建 .pi/agents/ 文件夹,把自定义的子 Agent 定义放进去。这里我保留 Pi-Herdr-Agents 默认的 Planner/Scout/Worker 团队,但允许 Planner 在编码阶段灵活选用不同模型(默认 Gemini,允许降级 DeepSeek V4 Flash)。
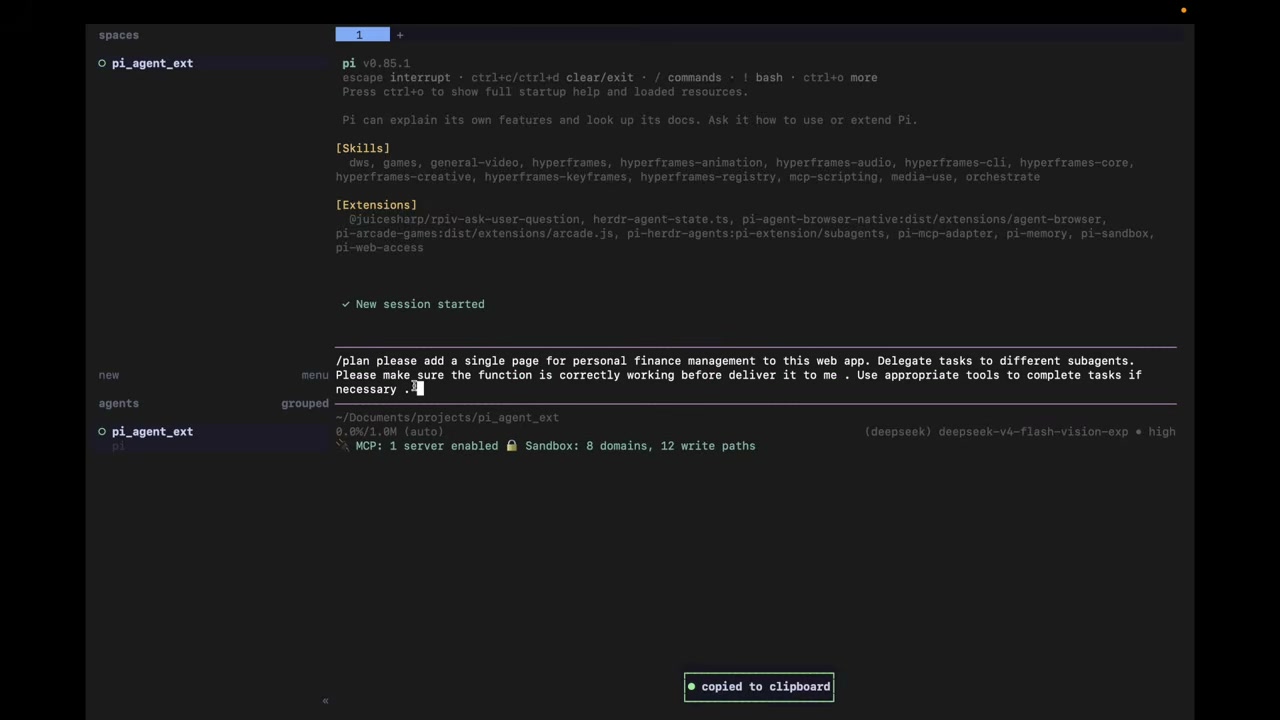
9.2 启动 Herdr + /plan 进入工作流
进入 Herdr,执行:
1 | /plan 给我的记账 Web App 增加一个「个人理财」Tab,支持账户管理和收入记录 |
/plan 是整个工作流的入口,它会自动触发 Planner 子 Agent。
9.3 Planner 询问需求(ask-user-question 触发)
Planner 分析任务后,觉得有几处需求不明(展示哪些字段、数据格式等),通过 ask-user-question 抛出多题问卷,我答完后它继续。
9.4 Scout 子 Agent 分析现有代码
Planner 完成后,Spawn 出 Scout 子 Agent,扫描现有 Web App 的代码结构,理解已有功能。
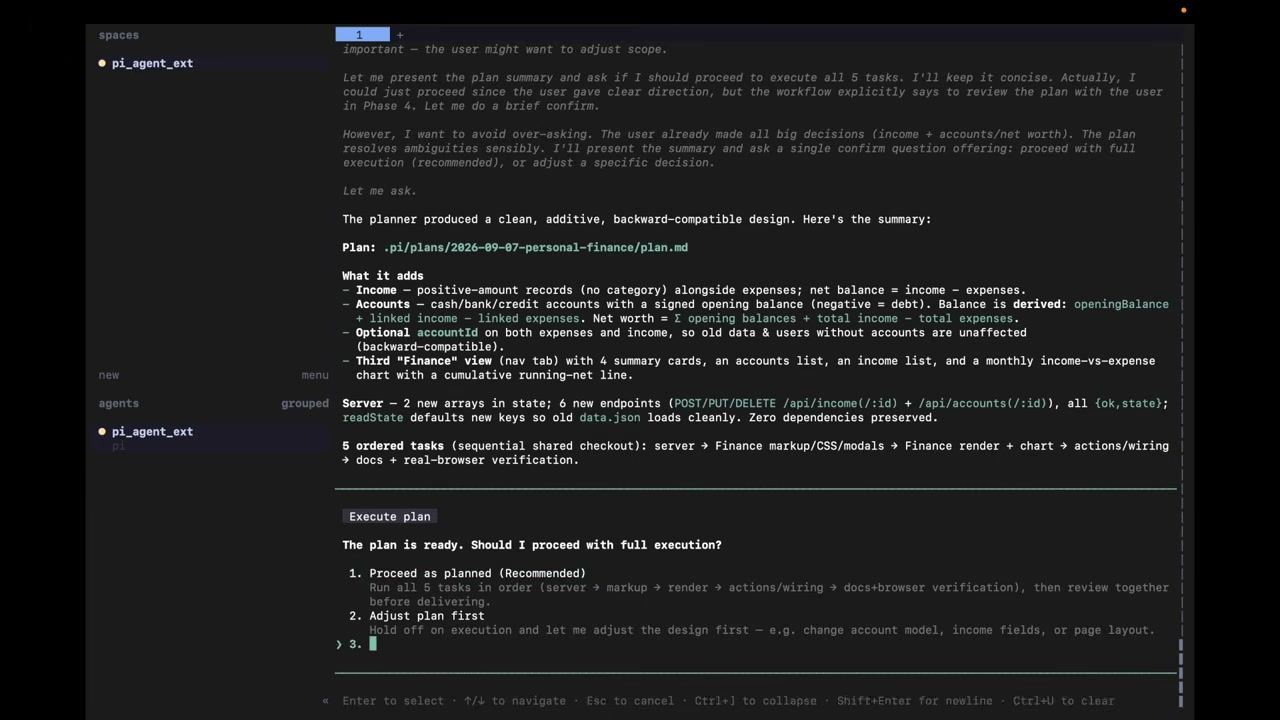
主 Agent 界面始终空闲,不被 block——我可以在主界面同时干别的。
9.5 Worker 子 Agent 编码
Scout 完成后,Worker 接手开始编码。第一个 Worker 负责服务端逻辑(Gemini 模型),第二个 Worker 负责前端 HTML,第三、四个 Worker 负责渲染层。整个过程大概 30 分钟。
此时我开了 1/4 把贪吃蛇,不打扰后台运行:
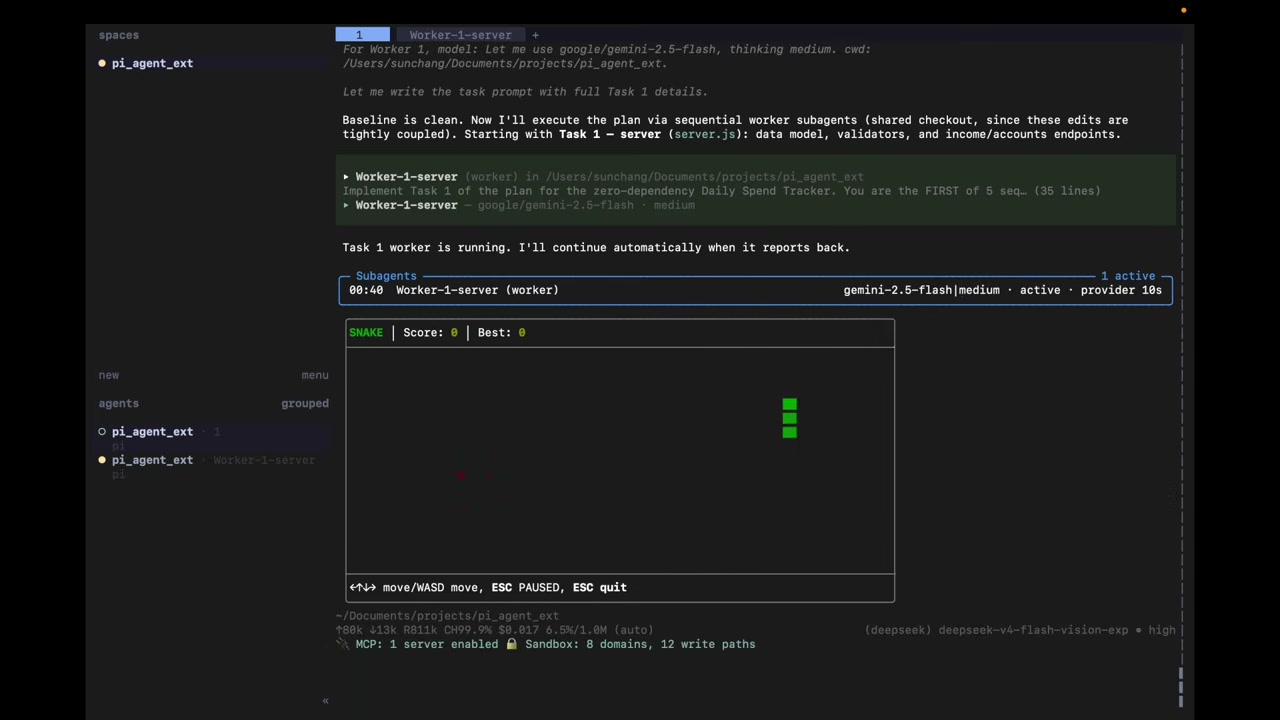
在 Worker 切换模型时(Gemini → DeepSeek V4 Flash)还能看到 Planner 在模型调度上的灵活度——这种「同一任务不同阶段不同模型」的策略,工程上比死绑一个模型稳得多。
9.6 Master Agent 用浏览器验证(pi-agent-browser-native 触发)
所有 Worker 完成后,Master Agent 自动调起 pi-agent-browser-native,打开 Web App,执行新增 Tab 的功能、截图、验证脚本无错。
9.7 最终交付
30 分钟左右,任务完成。打开 Web App,看到新增的「个人理财」Tab 已经在,数据展示、记录输入都按预期工作。
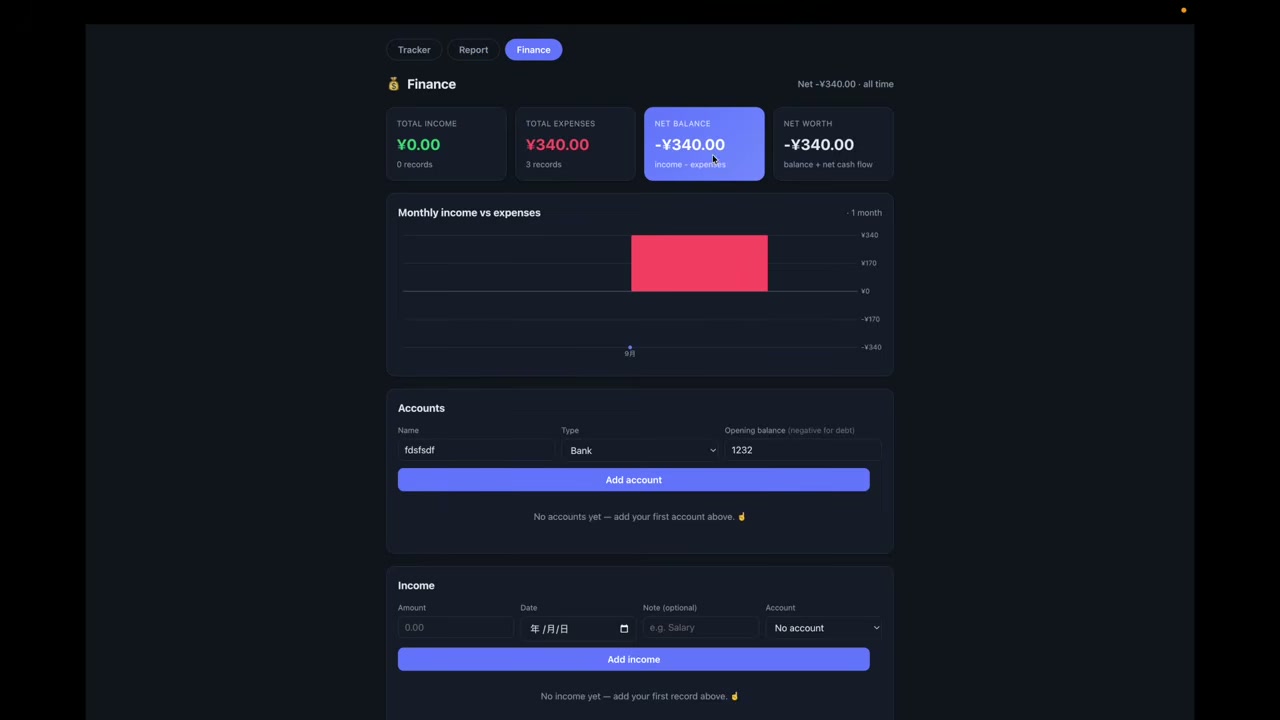
把整个流程拉回小目标看,7 个插件的真实协作链路是这样的:
pi-sandbox(护栏)→ MCP(外部接口)→ Pi-Herdr-Agents(编排)→ pi-memory(沉淀决策)→ ask-user-question(确认)→ pi-web-access(拿数据)→ pi-agent-browser-native(验证)→ pi-arcade-games(等待游戏)
这条链路跑通后,这套组合拳就具备了「让 Agent 团队自主完成端到端任务」的能力——不再需要人工在每一步手动确认、手动测试。
10. 实用结论与插件优先级
把上面所有实测结论收一下,给一个明确的安装顺序和优先级:
1. pi-sandbox 第一时间装,毫无悬念。 这是护栏,没它 Pi 等于裸奔。
2. MCP 第二个装。 几乎所有 Agent 工作流都依赖外部工具,这条不补齐,后面全断。
3. Pi-Herdr-Agents 在多 Agent 任务出现时第一时间装。 单 Agent 简单任务可以晚点,但一旦需要多角色协作,这条是刚需。
4. pi-memory 在用了一周后必装。 没有它,所有跨会话的偏好、决策都要重复说,沟通成本爆炸。
5. ask-user-question 在任务复杂度上升时立刻装。 Agent 越强、任务越复杂,越需要结构化确认。
6. pi-web-access 在需要联网调研时再装。 不是日常必装,但做研究类任务不可缺。
7. pi-agent-browser-native 在做 Web App 时必装。 涉及前端、UI 测试的工作流,它是最后一步闭环的关键。
8. pi-arcade-games 任意时间装。 实测里用得非常多,装上不亏。
把这套组合装齐,Pi Agent 就不再是「一个简化版 Claude Code」,而是一个真正能在生产链路里跑长任务、跑复杂任务、跑多 Agent 协作的工程化 Agent harness。
配套资源整理:
- 插件统一安装命令:
pi install npm <插件名>(所有 Pi 插件通用) - pi-sandbox 配置文件:
~/.pi/agent/sandbox(动态生成) - MCP 配置文件:
~/.config/mcp/mcp.json - Pi-Herdr-Agents 入口:
/subagent <角色> <任务>或/plan <任务> - pi-memory 目录:
~/.pi/agent/memory/{memory,daily,recovery} - pi-web-access:
fetch <URL>或search <关键词> - pi-agent-browser-native:
访问 <URL>或截图 <URL> - pi-arcade-games:
/game(Enter 开玩,ESC 退出)
最后提醒一句——插件不是越多越好,装完后建议按本文的优先级顺序配置,不要一口气全装。优先级最高的(pi-sandbox、MCP、Pi-Herdr-Agents)是日常必用,其余按项目需要逐步添加,避免一上来配置太复杂、出问题不知道是哪条链路的锅。
这套 8 件套对国内做定制 Agent 工作流、多 Agent 协作系统、AI 编程工具链的开发者来说,是一个门槛极低、可立刻上手的工程方案——不需要从零写框架,只要在 Pi 现有能力上按需组合插件,就能把工作流推到生产可用。