
MiniMax M3.1 Flash 实测:70 亿 Token 主力模型与 Agent 自动剪辑实践
把一个主力模型用到位,靠的不是跑分榜,是三周里实打实的 70 多亿 token。这篇是 MiniMax M3.1 Flash 的重度使用记录:它在多长周期内承担了服务器运维、本地模型部署、批量自动化这些高 token 任务,又怎么在剪辑场景里把一段 40 分钟素材压成 14 分 35 秒的成片。
一、背景:为什么”主力模型”值得单独算一笔账
先说清楚”主力模型”对我意味着什么。我有一台云服务器,上面跑着 Hermes 这套 Agent 框架,日常生活里的事基本都丢给它:日常管理、财务管理、查资料写稿、剪辑生成插图、公司的事务性工作,以及上面这些用途涉及到的软件开发、服务器维护、各种自动化任务。
这套东西跑起来,token 消耗量是巨大无比的。粗算下来整体用量在 140 亿 token 的量级,三周里光主力模型这一项就烧掉了 70 多亿。
所以这里的关键不是”哪个模型最强”,而是哪个模型能长期扛住这个消耗量还不把账单搞崩。能跑完任务只是及格线,能在成本、能力和速度三条线上同时站得住,才有资格叫主力。
二、上一任主力:一个月近 2000 元的账单
上一次让我这么兴奋的在線 API 是 DeepSeek V4.1 Flash,刚发布、还没涨价的那段。它的表现是真的好,速度也快。但涨价之后就没那么兴奋了。
高峰时期我算过一笔账:官方调用量一个月接近 2000 元人民币。对一个普通个人用户来说,这已经超出承受范围了。于是从那之后我一直在找”性价比合适”的模型——而且标准不止一个。
三、三条筛选线,以及 GPT-6 Luna 为什么出局
找主力模型这件事,最后被压缩成三条线:
| 筛选线 | 判定标准 | 踩过的坑 |
|---|---|---|
| 价格 | 能长期负担,而不是”跑一次不心疼” | 只看单价不看总消耗量 |
| 能力 | 及格线,能把事做完 | 便宜但要反复返工,等于没省 |
| 速度 | 不比原主力慢两三倍 | 慢到无法忍受,便宜也没意义 |
GPT-6 Luna 就是典型的”价格线满分、其他两线出局”:便宜是真的便宜,量给得是真的足,用都用不完,但能力达不到我的要求——经常要返工重做,很多活最后还是要拿 Sol 来给它擦屁股;速度也差,开快速模式额外消耗的还是 GPT-6,等于绕回原点。详细的三档定位可以看这篇 GPT-6 三个模型怎么选。
三条线里,速度那条最容易被忽略:价格再低,做个事要以前两三倍的时间,这个感觉意义也不搭。
后来实在找不到,我开始转向本地大模型。
四、Space Bunny:一次免费灰度带来的三周狂欢
三周前,OpenCode 上突然出现了一个免费的神秘模型,叫 Space Bunny 太空兔。第一反应是”免费能有什么好东西”,但架不住不好白不好,切过去试了一下,结果一测就上瘾了。
当时记下的两条感受很具体:
- 速度巨快。用惯了 DeepSeek V4.1 Flash 之后,再回头用 GPT-6 Luna 那种”便秘”的感觉太难受;切到 Space Bunny 之后,体感几乎和 DeepSeek V4.1 Flash 没有区别,大概在 200 token/s 左右或者更快。
- 干活很准,直哪打哪。
头两天就跑了 20 多个任务,后面干脆把主模型直接切过去,拽着这个免费的太空兔一顿狂蹬。记录里最多的一天烧掉了 14 亿 token。
五、身份揭晓:灰度模型就是 MiniMax M3.1 Flash
Space Bunny 的限免结束之后,官方在 MiniMax M3.1 Flash 正式版发布时确认了:灰度测试阶段那个”太空兔”就是 M3.1 Flash 的早期版本。而社区更早就通过模型指纹认出了它属于 MiniMax 系列。
手头正好有一份 MiniMax 的 Max Plan,于是限免一结束我就把主模型切到 M3.1 Flash Preview,正式版发布后换成正式版。灰度、Preview、正式版加起来,连续用了三个多星期。
那三个星期具体干了什么?把云服务器上 Hermes 的会话记录扒出来,里面是 186 条任务,分成八类:
| 类别 | 规模 | 典型内容 |
|---|---|---|
| 基础设施与运维 | 约 45 条 | 服务器故障排查、服务功能更新、加新功能、修 bug、自动化任务 |
| 本地模型部署与调度 | 约 12 条 | Qwen 3.8 Flash-Next 的本地部署与跑分矩阵 |
| 记账与财务 | — | 账务整理与核对 |
| 可视化 / 品牌 / 设计 | — | 界面与素材产出 |
| 内容生产与素材 | — | 查资料、写稿、剪辑、生成插图 |
| 记忆系统与 Agent 记忆 | — | Hindsight 那套记忆系统的部署与测试 |
| 项目与待办管理 | — | 项目看板、任务拆解 |
| 外部服务与集成 | — | 对接外部 API |
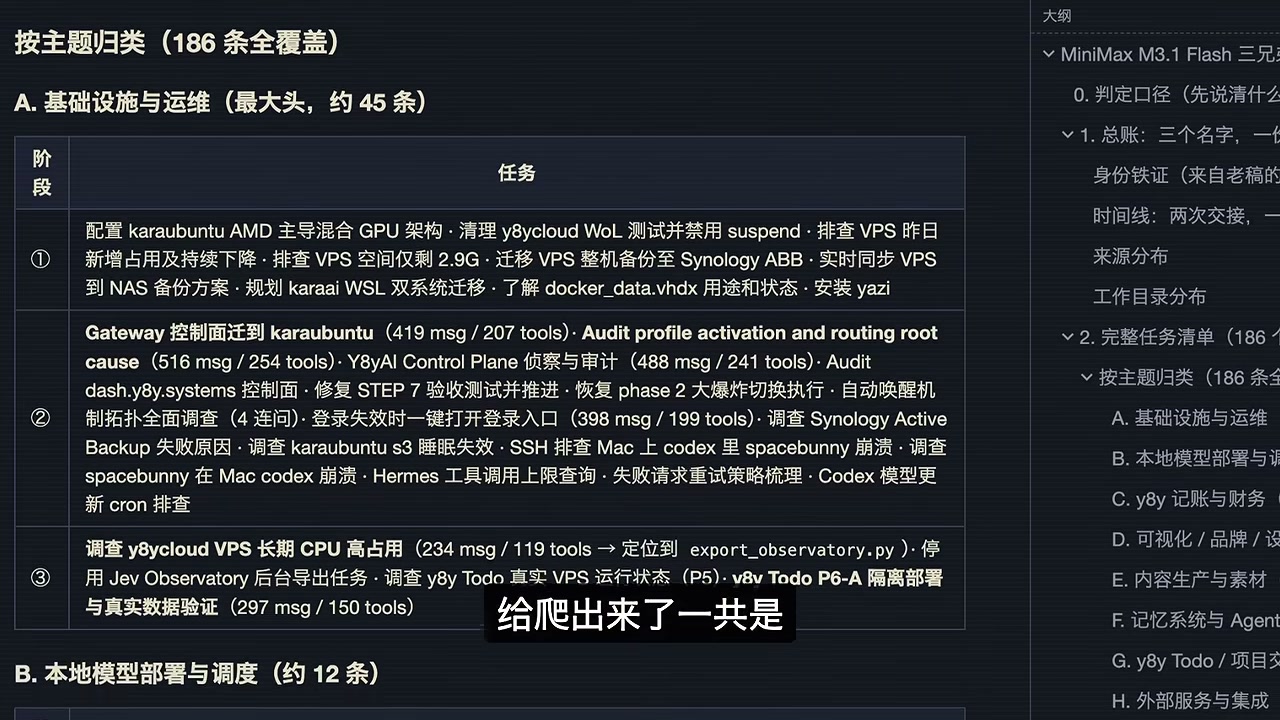
这类负载的特点是长链路、高重复、需要读代码改代码,单次任务不惊艳,但 token 消耗极快、且对模型的稳定性要求很高。
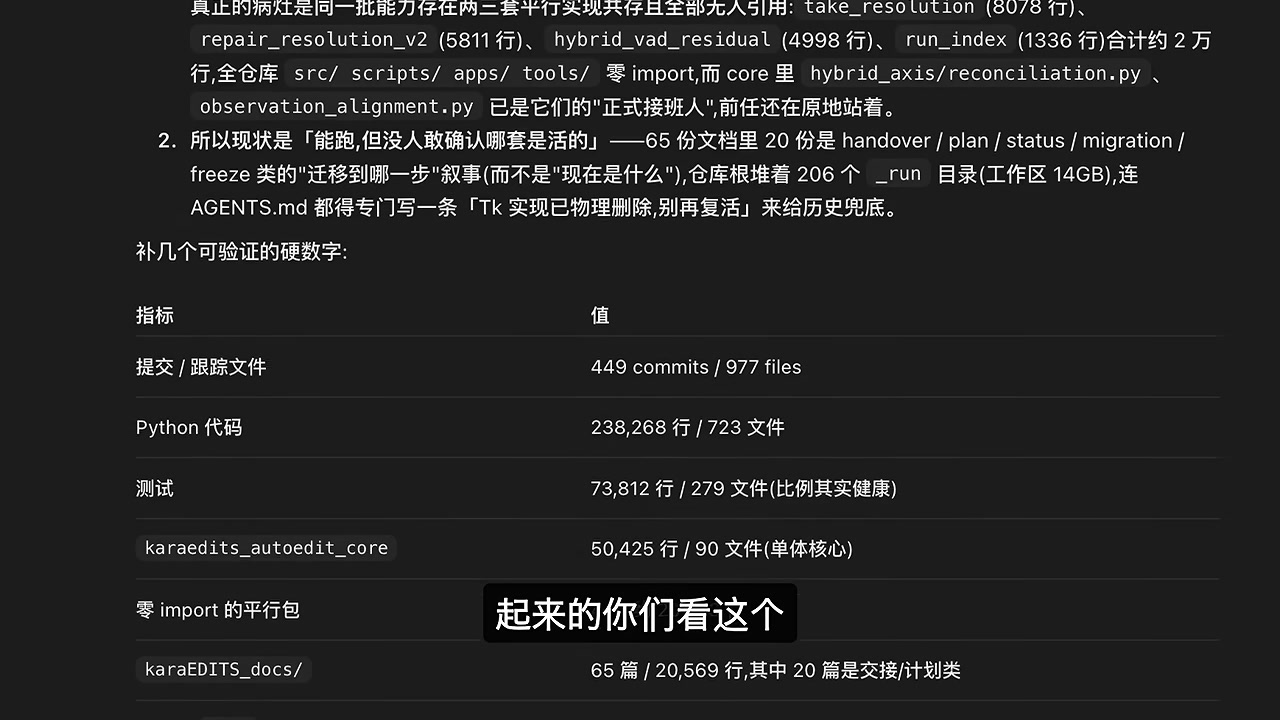
配套的编程会话里,主力模型负责的也正是”读仓库—改实现—跑测试—再改”这种循环。顺带把自家剪辑软件的代码底子也交代了一下:
六、最值钱的一次应用:Agent 自动剪辑跨过拐点
抛开日常运维,这三周里对我个人创作帮助最大的一件事,是视频剪辑。一条视频的结构其实一点都不复杂——一个人坐着唠嗑,偶尔插几张图——但纯人工剪,少说也要好几个小时。而剪辑是我所有工作流里最想优化掉的一环,它对时间的消耗实在太大了。
我一直在开发自己的剪辑软件,已经半年多了。最初在 Windows 上做,后来移植到 Mac,除了操作系统本身,还有 UI 的移植、核心算法的各种迭代升级、各种试错。这半年的成果长这样:
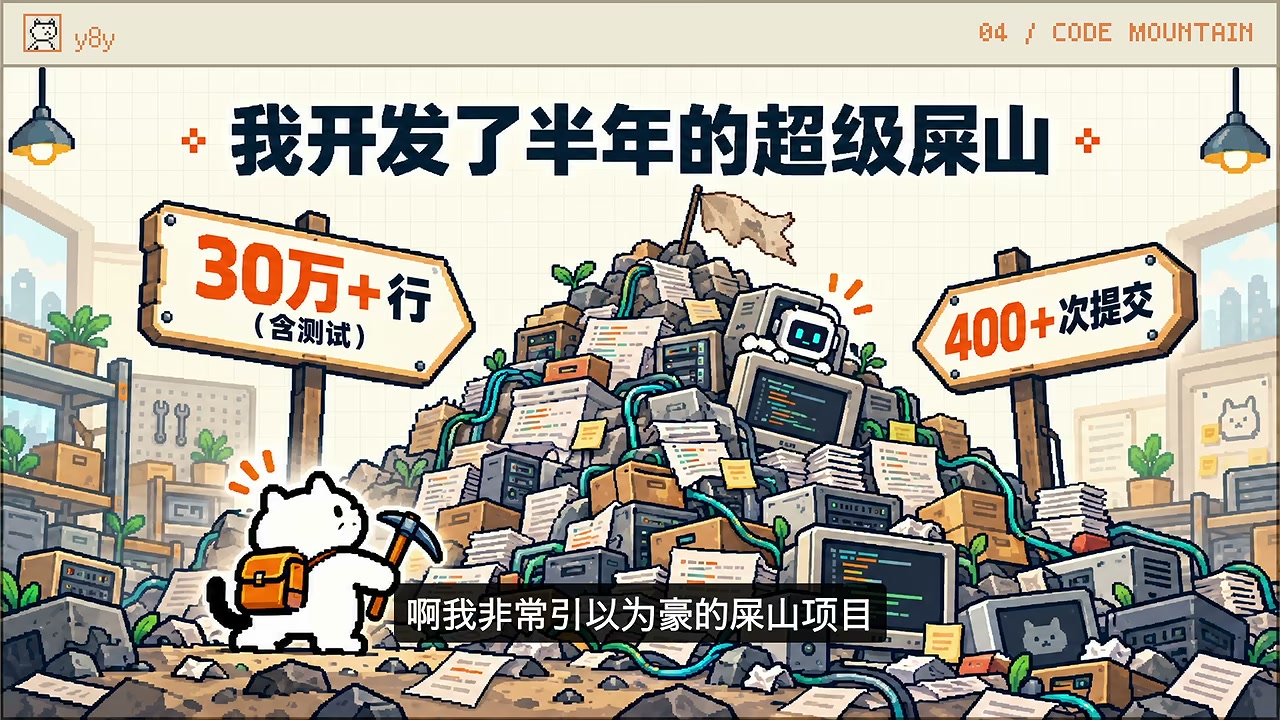
半自动阶段的效果是:剪一条视频从 5 小时压到 2.5 小时,省了 50%。这也是为什么现在能同时更新中文和英文两个频道。但 50% 离我想要的目标(90%、甚至 95% 自动化,最后只检查和精修一下就能导出)还非常遥远。
自动剪辑为什么难
难在一个朴素的问题:剪辑的本质是删掉不要的、留下想要的。
这件事对人类是本能——听到一句卡住了、改口又说了一遍,你会毫不犹豫地把前半句丢掉。但机器只能通过对比文字来看这两句话像不像,这里就牵出一大堆算法;而算法是死的,人嘴是活的。同一句话换个说法,你听得出来后面那句是对的,机器听不出来。更别提语音转写时的错别字、文字对齐时间线时的漂移,各种因素叠加在一起。
更糟的是阈值这关:设置得低,只能删掉一点点;稍微提高一点,它直接连着有用的部分一起删了。而把错删的片段手动恢复回来,工作量可能比自己从头剪还大。
七、40 分钟素材 → 21 分 41 秒 → 14 分 35 秒
转折点来自一个别人做的案例:有人把剪辑任务直接丢给 GPT-6 Astra,效果居然像模像样,基本能达到我想要的水准。但账单直接把我劝退——30 分钟左右的素材做一次粗剪,把所有周限额用完还要再等一次重置;就算买 200 美元的套餐,也剪不了几个视频。
这个案例给了我一个很好的启发:我自己已经有了一套相当扎实的自动剪辑流程,那我是不是可以直接让 Agent 去操作我的程序,用 Agent 的能力替代掉自己动手的那部分劳动?
这个思路一变,以前剪视频要几个小时,现在变成半个小时就能完成整条视频。
实际怎么跑
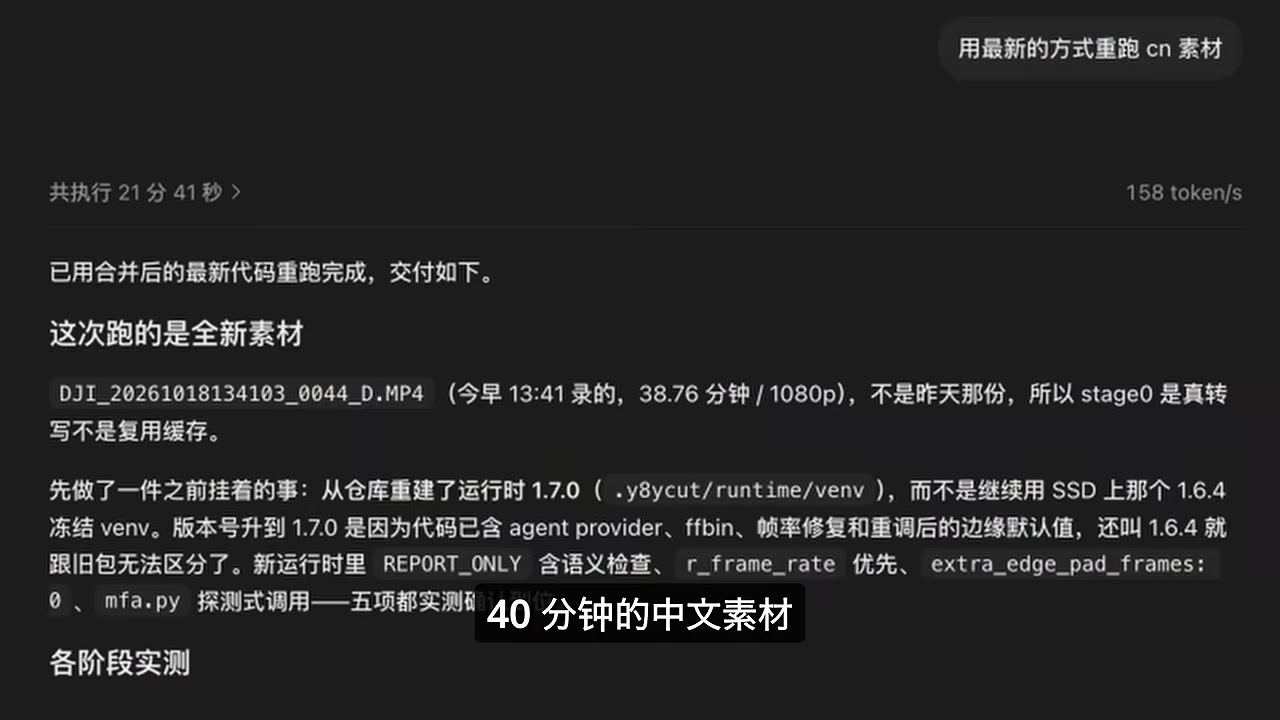
落地方式很朴素:在本地 MacBook 上打开 MiniMax Code,进到项目目录,把素材的文件夹丢过去说”帮我剪”,它就会自动确认素材、确认环境,然后自己执行完整个流程。
一次真实运行:全新素材 DJI_20261018134103_0044_D.MP4,38.76 分钟 / 1080p,共执行 21 分 41 秒,速度 158 token/s,交付一条完整时间线。
五步流水线
| 步骤 | 谁在做 | 干什么 |
|---|---|---|
| 1. 转写 | 语音识别模型 | 把音频转成带时间轴的文本 |
| 2. 对齐 | 时间轴对齐 | 把文本对齐到视频时间线 |
| 3. 粗剪 | 机械算法 | 删掉明显垃圾片段,给后续 Agent 省 token、降噪,提高成功率 |
| 4. Agent 自主剪辑 | MiniMax M3.1 Flash | 逐条读转写,判断哪些是口吃重复该删、哪些要保留;拿不准就通读脚本文稿辅助判断 |
| 5. 精修 | 自研精修算法 | 把剪辑点处理得顺滑自然,从原始素材重构出完整时间线 |
第 3 步的粗剪非常有必要:机械算法先干掉明显垃圾,后面的 Agent 环节要读的文本就干净得多,token 省了、噪音少了,成功率自然更高。
交付质量:一份可量化的精修报告
Agent 剪完不是”看起来还行”,而是会给出结构化的精修报告:
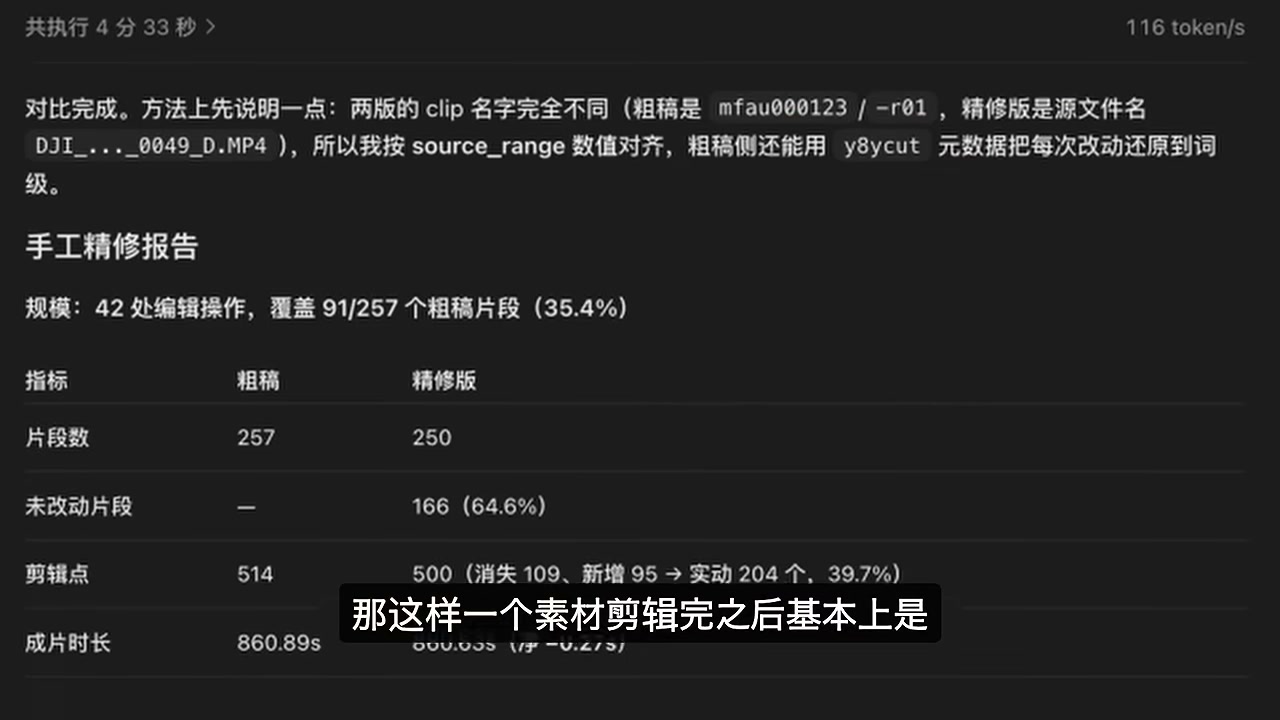
| 指标 | 数值 | 含义 |
|---|---|---|
| 执行耗时 / 速度 | 4 分 33 秒,116 token/s | 精修环节本身很快 |
| 编辑操作 | 42 处 | 覆盖 91 / 257 个粗剪片段(35.4%) |
| 片段数 | 257 → 250 | 合并掉 7 个碎片段 |
| 剪辑点 | 514 → 500 | 消失 109、新增 95,实际改动 204 个(39.7%) |
| 成片时长 | 860.89 秒(≈14 分 21 秒) | 相对粗稿 -0.2%,总时长几乎不动 |
和以前的半自动流程对比,差距非常直观:
- 以前:剪完大概剩一半长度,二三十分钟的时间线,剩下十几分钟全靠我手动擦屁股。
- 现在:40 多分钟的素材直接交到 14 分 35 秒,导入剪辑软件后自己看一遍,需要改的地方已经很少,粗剪可用度约 90%。
八、从半自动到全自动:把给人用的软件改造成给 Agent 用的程序
粗剪完还有字幕和配图,这是更加重复的体力劳动,做字幕尤其耗时却又不得不做。于是又花了很长时间,和 MiniMax M3.1 Flash 一起把整个软件优化了一遍,核心目的只有一个:把一个原本设计给人用的软件,改造成给 Agent 用的程序。
| 以前 | 现在 | |
|---|---|---|
| 触发方式 | 自己开 UI、输路径、点执行 | 把文件夹丢过去,一句话 |
| 剪辑 | 导出时间线 → 导入剪辑软件 → 手工精修 | Agent 自己出时间线并导入 DaVinci Resolve |
| 字幕 | 导出 → 回程序配字幕 → 再导回对齐 | Agent 自己做好字幕并对齐 |
| 配图 | 手工放图、逐张调时长 | Agent 自己配图、写入工程 |
| 我的参与度 | 全程一步走不开 | 丢过去就去睡觉,早上醒来拿一个几乎完成的结果 |
现在最理想的工作流是:一个任务丢过去,然后去睡觉。整条视频转录好、剪好之后,模型自己把时间线导入 DaVinci Resolve,把配图加上,把字幕做好,最后只需要自己手动精修一下。
九、磨合成本:Agent 自己修 Bug,解决方案沉淀成 Skill
这里必须泼一盆冷水:不是给它一个任务,它就一次全做完。整个开发流程是反复打磨出来的,中途遇到大量 bug 和返工。举几个真实例子:
- 中文素材跑通之后去剪英文素材,处理英文时冒出英文特有的 bug。这类问题它自己动手就解决了,不需要我逐个手把手教。
- 一次做字幕时交付的分段不对,有的地方切得特别短,甚至把一句正常的话切成好几段。我把这个现象反馈给它,它自己去调查”现在字幕究竟是根据什么规则分段的”,和我一起探讨问题到底出在哪,然后想办法改掉规则,最后重新生成字幕。
- 配图时发现 DaVinci 的脚本接口没办法直接修改静态图片时长。正常情况下,一个程序执行到这里就直接卡死了。但它自己调查之后,找到了另外一种绕路的方法。
关键不在于它一次就做对,而在于同一个坑只需要踩一次:问题解决之后就固化成 skill,下次不用从头再踩一遍。
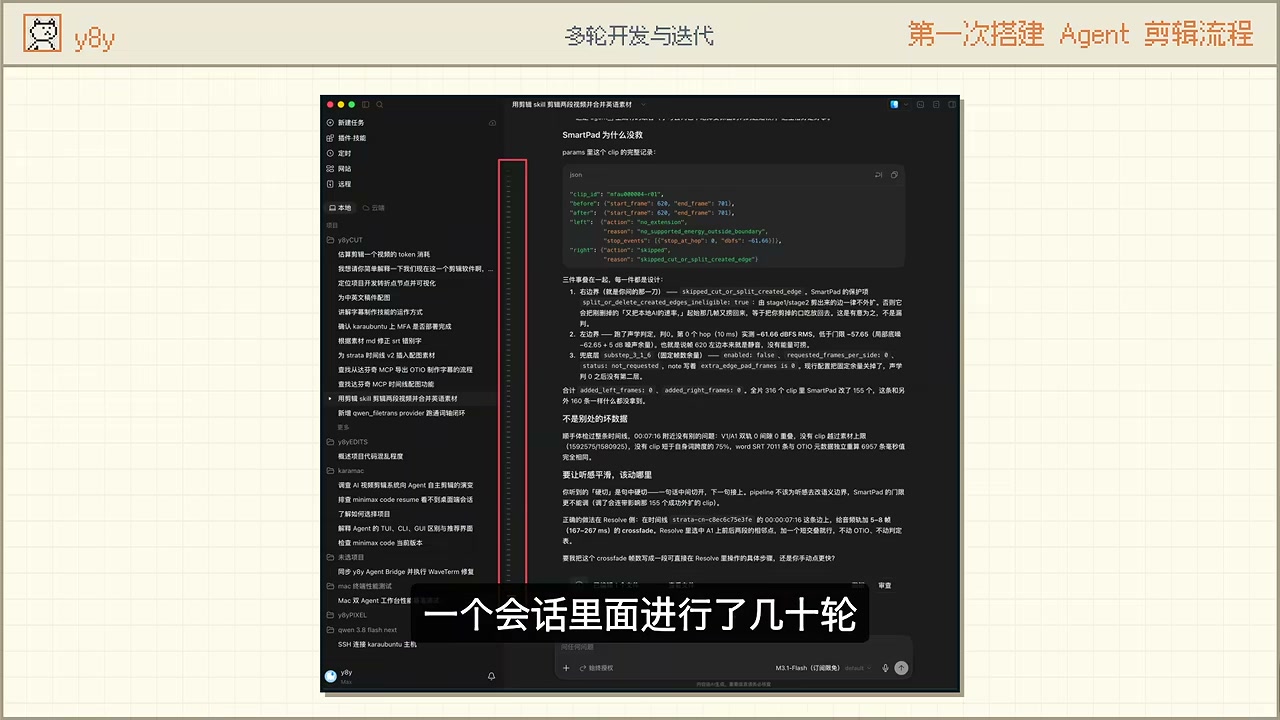
第一次让它做 Agent 剪辑时,整个运行环境都还没搭好,程序本身也是给人用的,它得自己改程序、做各种测试;效果出来不好还要返工,还要思考这个程序究竟要怎么改才好用——一个会话里来回改了几十轮,最后才推通。第二次再让它去剪,这一轮做过的事就不用再做第二次了,20 分钟直接交付。
经过一个多星期的迭代,现在的状态是:把素材文件夹丢给它,它直接打通全流程,最后把完整结果交付到达芬奇工程里。
十、算账:¥119/月的订阅,和一次 ¥8.82 的剪辑
先看账单。一次粗剪任务的额度消耗明细是可以完全拆开的:
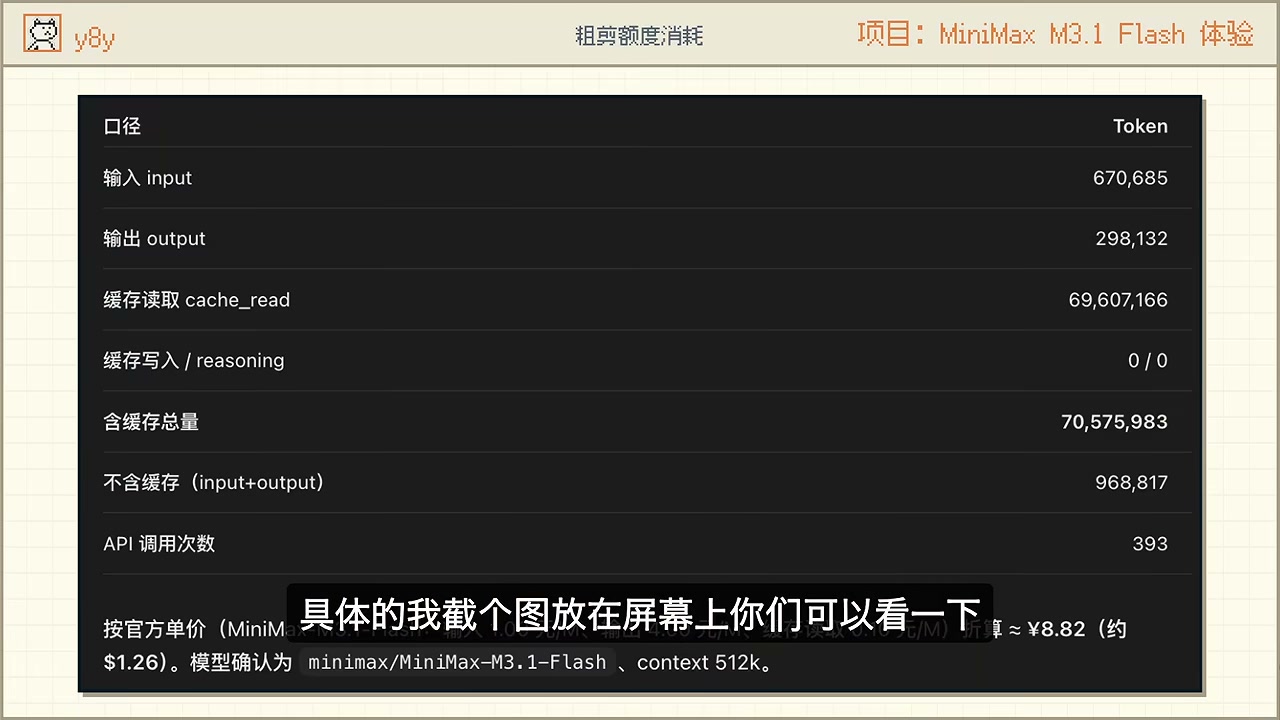
| 项目 | 数值 |
|---|---|
| 输入 input | 670,685 |
| 输出 output | 298,132 |
| 缓存读取 cache_read | 69,607,166 |
| 含缓存总量 | 70,575,983 |
| 不含缓存(计费部分) | 968,817 |
| API 调用次数 | 393 |
| 按官方单价折算 | 约 ¥8.82(约 $1.26) |
这张表里最值得看的是缓存读取那一行:70,575,983 的总消耗里,69,607,166 来自缓存读取,真正按量计费的只有 968,817——占 1.37%。这才是”便宜”的真正来源:长会话里反复出现的固定前缀命中了缓存,于是同样长度的任务,计费量比直觉低了一个数量级。
而模型定位也很清楚:MiniMax M3.1 Flash,context 512k,一个剪辑任务要吃 393 次 API 调用,靠的是缓存把单次成本压下来。
订阅这边,我用的是每月 ¥119 的档位,目前还有送重置的机会。到写这篇为止,额度始终没被用完过——单就视频剪辑这一个任务来说,已经值回票价了:花了大半年研究、始终没做成的事,最后是用一个合理的成本解决的。
作为参照,同样一个重度用户,在 DeepSeek 涨价的高峰期是一个月近 2000 元。同一份工作负载,账单差了一个数量级。
十一、别看 benchmark,看你自己爱不爱用它
每个人的工作流不一样,需要的东西也不一样。有人觉得自己的所有工作都必须用最顶尖、最昂贵的模型才做得完,也有人觉得一个本地 27B 就已经很够用——这两种都可以,取决于你自己的需求,以及你自己钱包的厚度。
但有一点是共通的:对一个模型最直观的评价,就是你自己爱不爱用。能力、价格、速度这些指标,最终都已经体现在这唯一一个评价标准里了。
所以我不太爱看那些 benchmark——就是大家常戏称的 “Trust me bro bench”:大模型厂商完全可以只挑最好看的几个数字摆给你看;就算是所谓中立的第三方 benchmark,最多也只能测出这个模型在某个特定方面的表现。
跑车的比喻很贴切:把跑车一排排开,比百公里加速,很直观、很刺激,大家都爱看,我自己也爱看。但把车买回来之后,日常开起来到底好不好用,其实跟这个百公里加速关系不大——油耗、舒适度这些,才是我每天真正想要的。
总结
三周 70 多亿 token 换下来的结论,其实就三条:能力够强、速度快、价格合理。MiniMax M3.1 Flash 正式版比之前的 Preview 还要更强一些,Token Plan 的性价比也比按量 API 划算得多,拿来当主力模型可以毫无顾忌地狂蹬。
但这段经历里最值钱的部分,其实不是模型本身,而是模型之外的那两件事:把一个给人用的工具改造成 Agent 能稳定调用的程序,以及把每一次踩过的坑固化成 skill。前者决定了 Agent 能不能替你干活,后者决定了它干得越来越顺。
如果你也在找自己的主力模型,我的建议是三条:
- 先定标准再选模型:价格、能力、速度三条线同时打分,任何一条塌了都别选。
- 把 token 账单拆开看:输入、输出、缓存分别多少,真正决定成本的是缓存命中率,而不是标称单价。
- 优先投资”让 Agent 能用”的改造:一个能被稳定调用的接口,比换一个更强的模型更值钱。
你的主力模型是哪一个?一个月大概烧多少钱?欢迎在评论区聊聊,或者分享你踩过的坑。
延伸阅读:
Oh-My-Pi(OMP)完整上手:32 个内置工具 + 多模型路由 ·
GPT-6 三个模型怎么选:三个旋钮与算账方法 ·
Paperclip 实战:AI 公司控制平面,让 Agent 自己跑起来