MINIMAX H3 武打视频生成工作流:12G 显存跑开源视频模型的工程拆解
最近在做 AI 视频生成的本地化对比时,发现 MiniMaxH3 这套开源工作流在「高动态武打场景」这条赛道上做得相当深入——它把模型、显存优化、提示词模板和部署路径打包成了一个几乎”开箱即用”的工程方案。从模型文件名 minimax_h3_hybrid_52x_hdv_xl_... 推测,MiniMax 是其作者所在的模型家族命名空间,H3 则是面向武打场景的具体工作流版本;它的目标是用尽可能低的门槛生成古代武侠、奇幻打斗这种传统实拍成本极高的画面。
下面把我连日蹲点测试和对照实验里摸出来的工程要点,按模型定位、工程亮点、提示词结构、部署路径与适用边界五个维度整理成一篇笔记。
它定调的方向:专攻「高动态画面」的视频模型
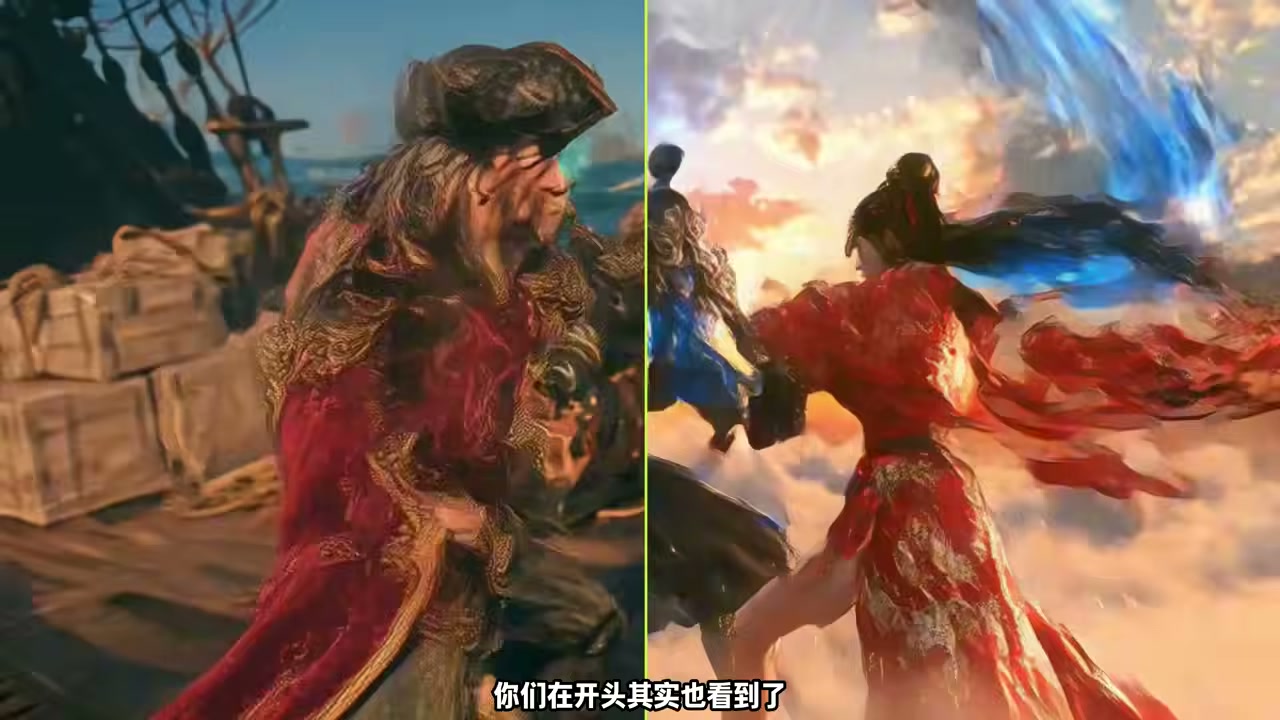
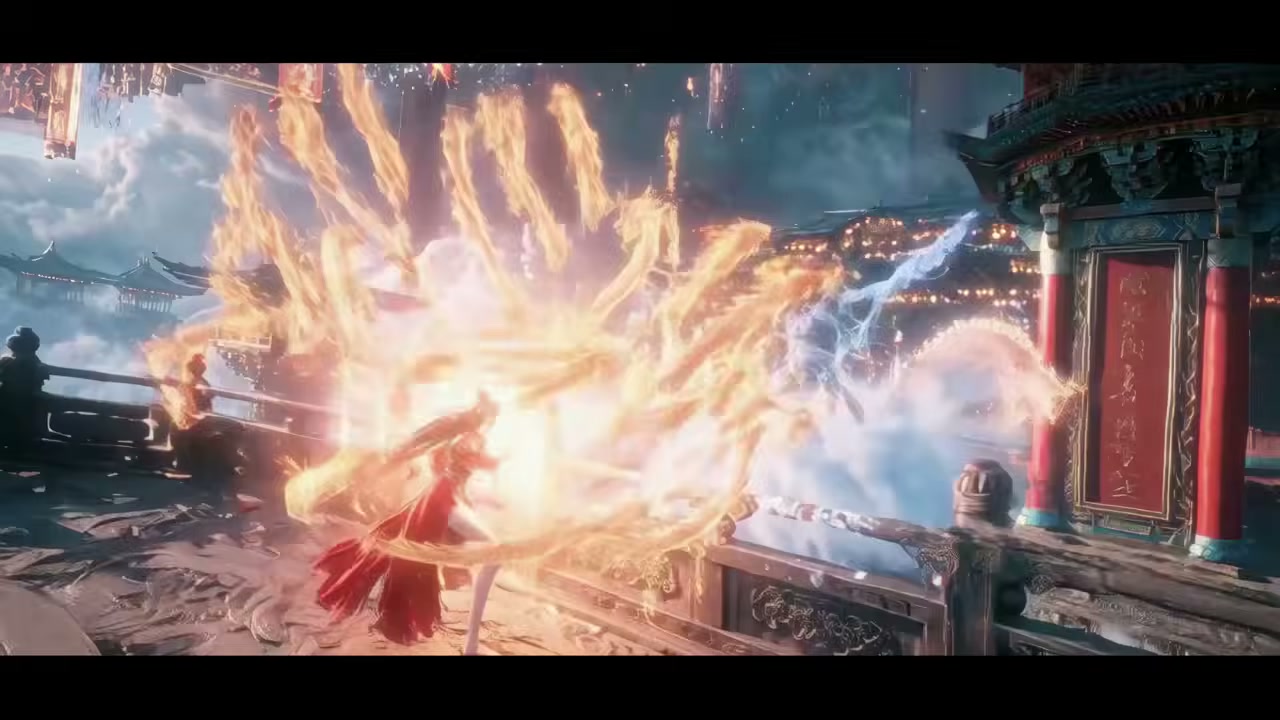
MiniMaxH3 在模型名字里就把产品定位写清楚了:H3 不是「更通用的视频生成模型」,而是「更便宜地做高动态(High-motion)、高视觉(Hi-vision)画面」的一组工程方案。和 Wan 2.5、Veo 4、Kling 这些通用视频生成模型不同,它没有追求在所有场景都达到 SOTA,而是把优化资源集中在两类画面上——古代武侠打斗、奇幻/仙侠战斗。前者讲究人物动作密度、兵器轨迹、表情与服装动态,后者讲究粒子特效、光剑、光环、爆炸冲击波等。
把这套定位打在小目标阅读里,价值在于:它把”通用视频生成模型”那种”什么都能做、什么都不算突出”的尴尬,转化成了”特定类型做出来很扎实的”工程深度。对插件制、长视频创作者来说,这种「垂直模型 + 配套工作流」的思路其实比通用大模型更实用——你不需要每个场景都 SOTA,你只需要在某个特定类型上稳定可用。
模型侧的几个关键节点名字就体现了这套思路:MiniMaxH3TModel(文本编码)、MiniMaxH3VideoAE(视频自编码)、MiniMaxH3LearnedResizer3D(3D 学习的下采样器),名字带 MiniMax 前缀的是 MiniMax 系列,带 H3 后缀的是本套工程专属。这种”模型拆片 + 命名规范化”的风格,很值得在做自定义工作流时借鉴——节点命名清楚,后续切换 cue 时更省事。
显存门槛:12GB 可跑,稀疏注意力是关键工程亮点
MiniMaxH3 最值得关注的工程亮点是「稀疏注意力(Sparse Attention)」机制的深度集成。在 ComfyUI 的工作流中,作者直接把稀疏注意力以插件形式封装为 comfyui-minimax-h3-audioT8 这个独立包,把稀疏注意力做成了”加载即可用,卸载也无副作用”的模块。
把稀疏注意力打在小目标里看,它的本质是改变 AI 推理时的注意力预算——分块注意力(Chunked Attention)把长序列切成多个块,每块只计算块内注意力,而不是全序列两两对比;低 VRAM 注意力则进一步把块级 KV 缓存卸载到内存或 NVMe SSD,把显存占用从”必须装得下全序列”降到”只要装得下一块”。工程上,这种切块 + 卸载的组合可以把显存需求压到通用方案的 1/3 到 1/4。
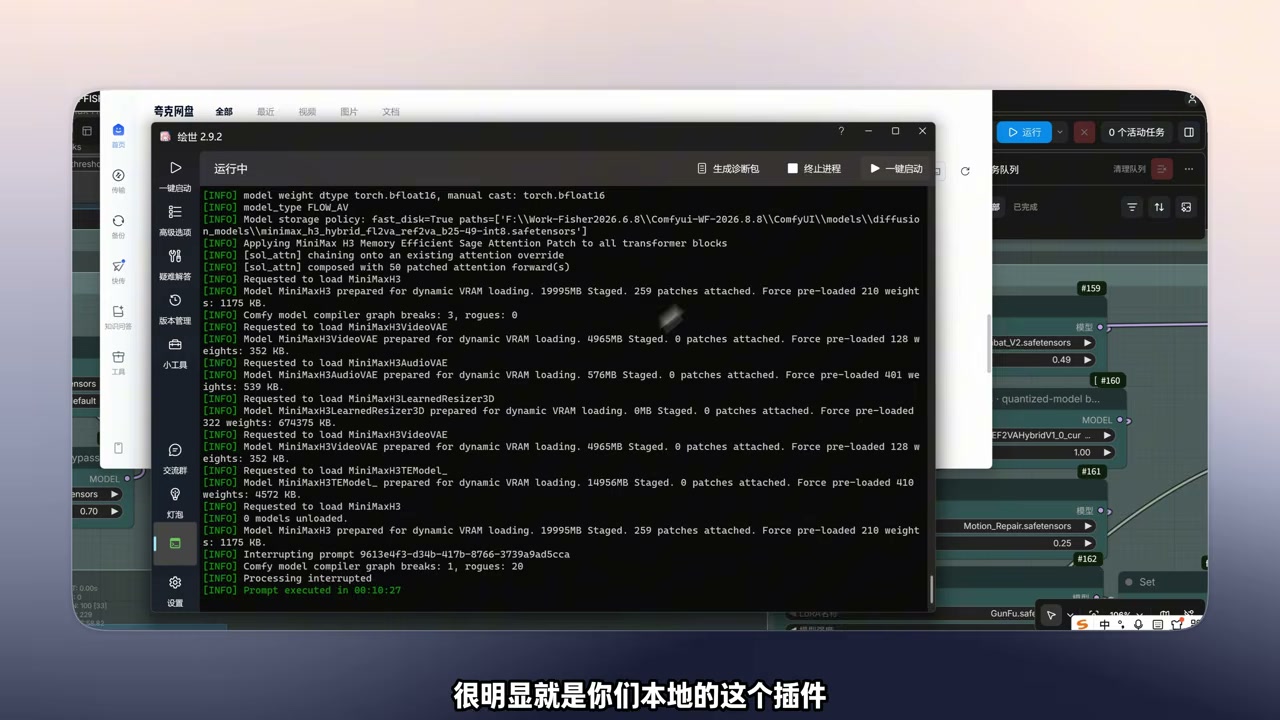
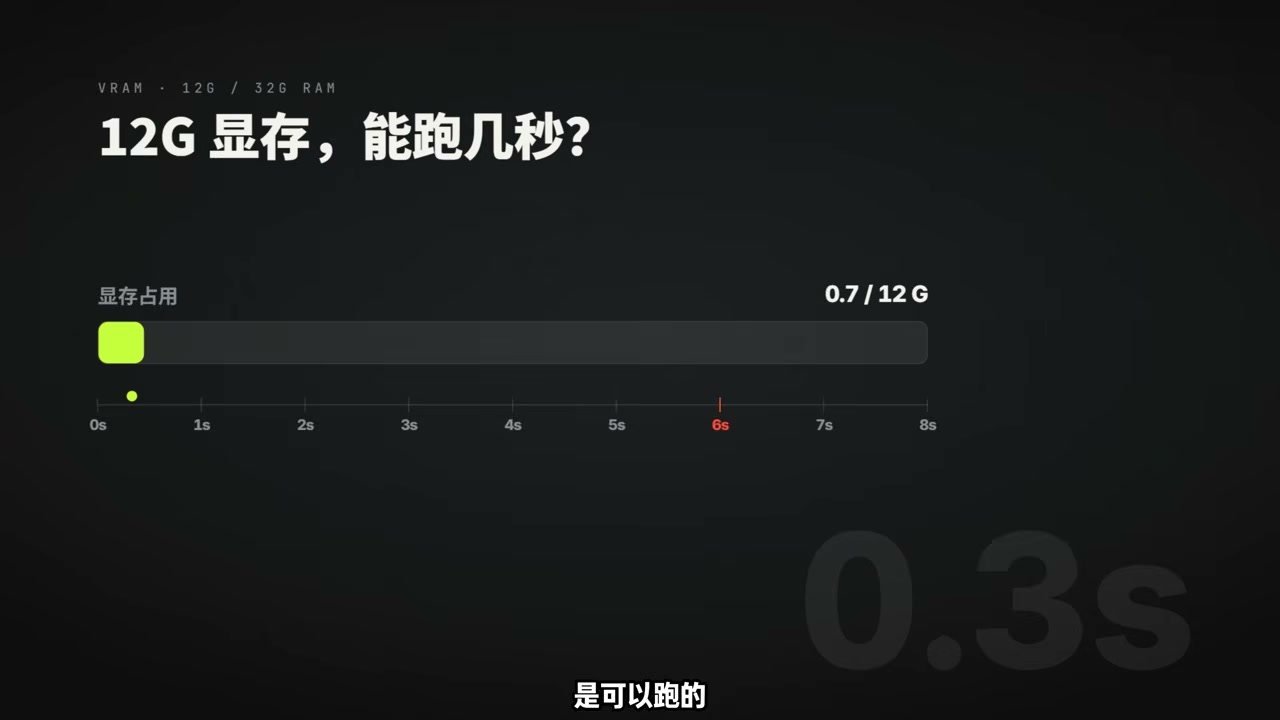
从加载日志可以看到模型加载细节:MiniMaxH3 主模型 19995MB、MiniMaxH3VideoAE 4965MB、MiniMaxH3LearnedResizer3D 0MB(动态加载)、MiniMaxH3TEModel 14956MB。所有支持动态 VRAM 加载,Force pre-load 状态下占用也只在 210MB-770MB 之间,其它部分按 stage 分批加载。这种”动态加载 + 稀疏注意力”的组合,是这套工作流能跑 12GB 的核心工程逻辑。
如果对”低显存跑大模型”这条线感兴趣,可以参考我之前拆解过的 AirLLM 分层流式 那套方案,两条路线各有侧重——AirLLM 走”逐层减参数”路线,MINIMAX H3 走”分块减注意力”路线,工程哲学本质上殊途同归。
5 段式提示词结构:把”动作分解”内化到模板里
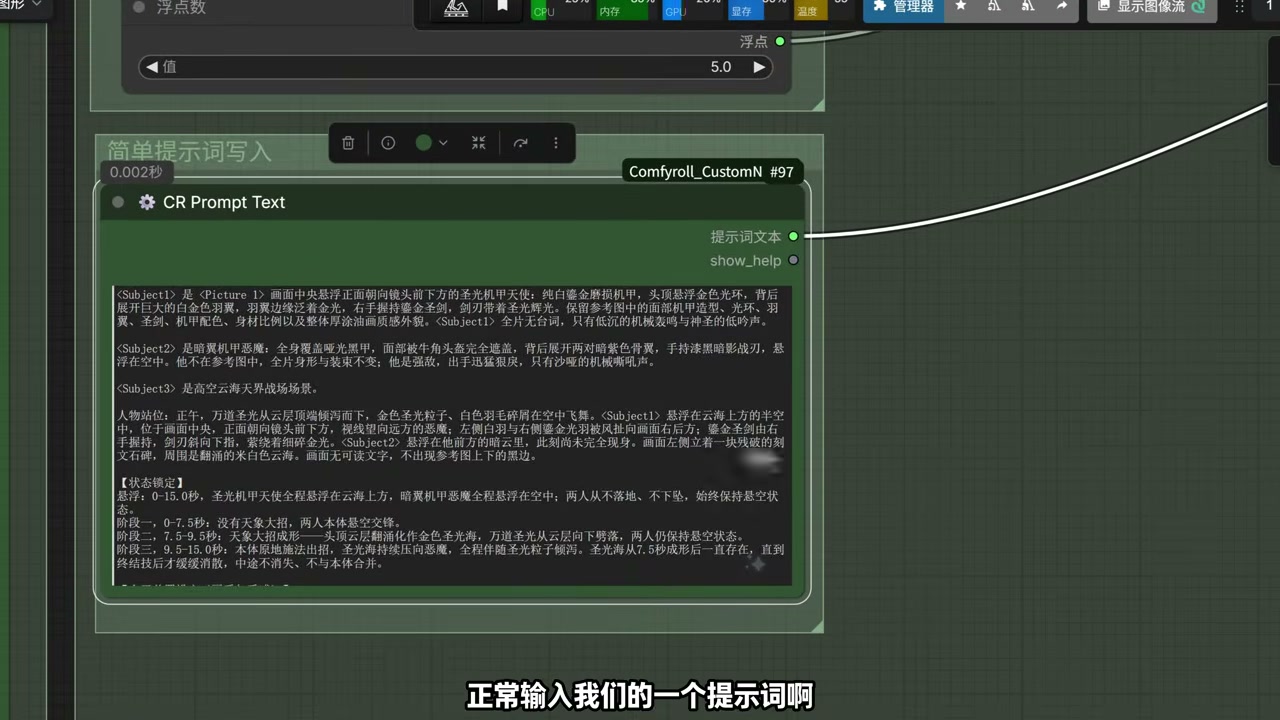
MiniMaxH3 在提示词设计上的最大亮点,是把武打场景的提示词拆成了 5 段固定结构:<Subject1> 是主角 1(人物描写)、<Subject2> 是主角 2(对手描写)、人物站位(初始姿态)、人物朝相(运动姿态)、状态锁定(运动分解)。这套结构本质上把”武打分镜”这个抽象的编剧概念,转化成了”提示词模板填空”的可重复流程。
把这套提示词结构打在小目标里,会发现它的工程意义——它把原本依赖运气的”序列建模稳定性”问题,转化成了”分块状态稳定性”问题。提示词中明确写”阶段一、阶段二、阶段三…”的分解,等于在文本层就把视频切成了多个”子镜头”,每个子镜头都有自己的起点和终点,镜头间的过渡由模型自己填补。这比通用视频生成模型那种”给一段描述、生成完整动作”的方式,在分镜可控性上要细一个量级。
这套思路对国内做定制剧本生成、动漫自动分镜、短视频批量化的工程师来说,其实是一个可复用的工程模式——不需要从头造一个模型,只要设计好类似的”子镜头切片”模板,把运镜、人物站位、状态变化拆成可填空的字段,就能在通用模型上跑出更稳定的批量结果。
部署路径:本地整合包 / 云端 / 画布三套选择
MiniMaxH3 的部署路径被设计成了三条并行的路线,各自对应不同的用户场景:
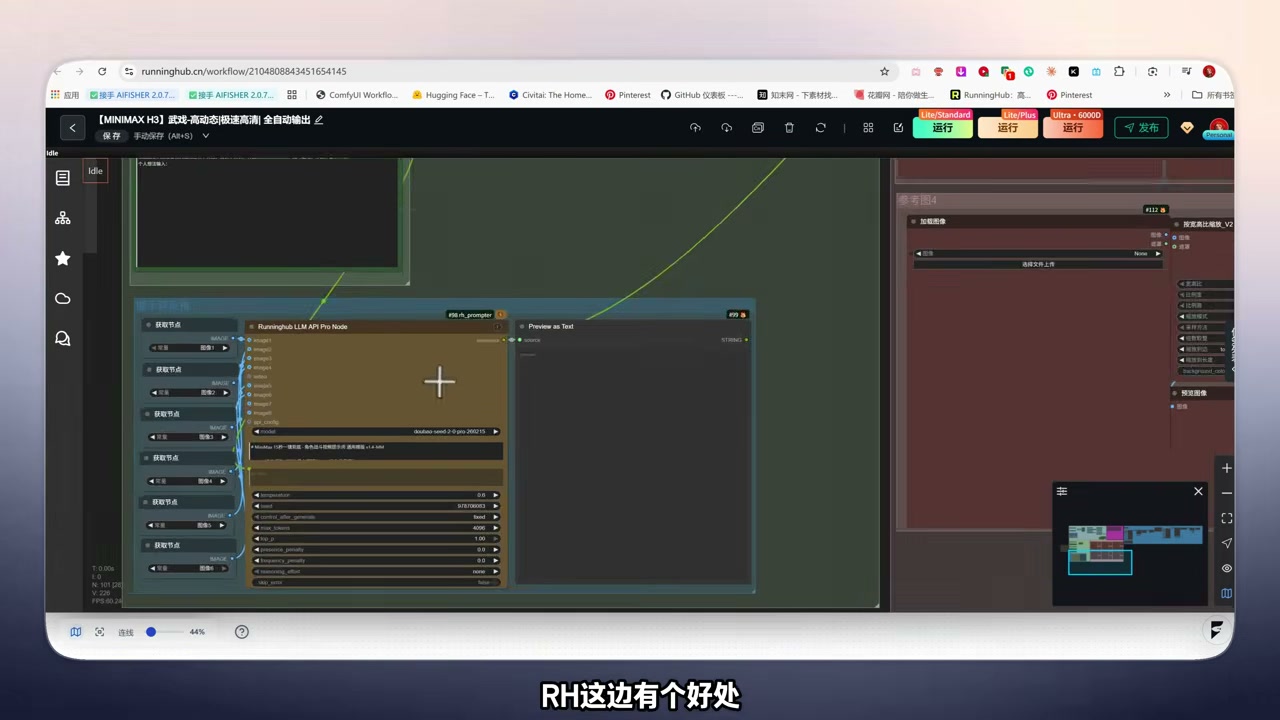
云端整合包(适合零基础用户):RunningHub 提供了云端版本,免配置、免下载,在浏览器里即可运行。对想要快速体验、不愿意折腾本地环境的用户很友好,代价是要付云端算力费用。
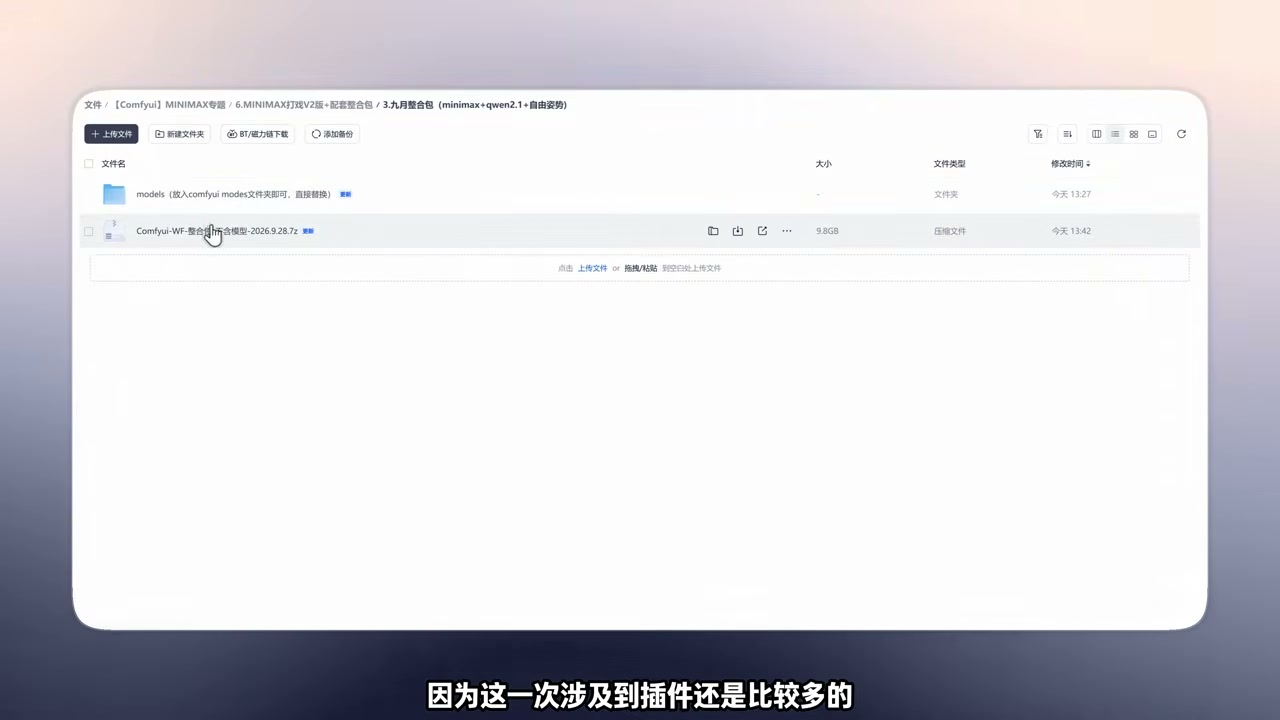
本地整合包(适合有算力的玩家):作者提供 9.8GB 的 ComfyUI 整合包,纯净版 + 对应模型全部打包,直接下载解压就能跑。所有涉及到的插件(包括稀疏注意力模型、低 VRAM 注意力、LightX2V FL2V Turbo、Patch Sol-Arith 等十几个)都已预装且冲突回避。对有 12GB+ 显存的本地机器玩家,这是最省事的路径。
画布平台(适合多工具协作):AIFisher 无限画布(work-fisher.com 的产品)把 MiniMaxH3 模板化成了可拼装的画布节点,可以在画布里和其他模型、API、工具自由组合。对想把它纳入自己工作流管道的团队,这是最灵活的方案。
这三条路径同时存在的工程逻辑在于:它把”模型本身”和”使用路径”解耦了。同一个模型,在 MiniMaxH3 整合包里是开箱即用的玩具,在 AIFisher 画布里是可拼装的零件,在 RunningHub 上是即开即用的服务。这种”一处开源、多处部署”的思路,是开源模型真正进入工作流管道的关键路径。
适用边界:这个工作流不适合做所有类型的视频
把它和我的实际测试结果放在一起看,有几个边界需要提醒:
- 不适合做日常 vlog、产品展示、口播类视频:这些类型用通用模型如 Veo 4、Kling 已经够好,稀疏注意力 + 分块切片这些优化在这个场景是过度工程。
- 不适合做短于 3 秒的快速镜头:这套工作流的”分块状态锁定”是为切片结构服务的,镜头短于 3 秒时反而不如通用模型的”一段描述”更稳定。
- 适合做的:古代武侠打斗、奇幻战斗、空战粒子特效、连续技镜头、剑光轨迹——这些”动作密集 + 持续性镜头”的画面,是 MiniMaxH3 真正发挥的场景。
- 硬件底线:12GB 是”可以跑”的下限,体验舒适线在 16GB+。低于 12GB 时稀疏注意力仍然能压,但生成时间会显著拉长,序列化的时间占用会接近小时级。
把这套判断拉回到资源推荐路径上:如果你的工作流需要”批量产出古代武侠、奇幻战斗”这类画面,且本地有 12GB+ 显存的工作站,那么这套 MiniMaxH3 是目前开源方案里比较成熟的选择。如果你的场景偏向日常 vlog、产品图解、广告短片,则通用模型会更划算。
对想要从零开始本地部署 AI 工具的开发者,可以参考我之前写的 Pi Agent 零基础入门,那篇详细讲了 Mac 上从装包到写第一条 Agent 任务的工作流搭建,两者在”本地部署 + 工作流编排”的思路上一脉相承。
把今天整理的工程要点拆为几条实用结论:
1. 12GB 显存跑开源视频模型,稀疏注意力机制是关键工程。把分块注意力 + 低 VRAM 卸载组合后,显存需求能从通用方案的几十 GB 压到 12GB,这对个人玩家和小型工作室意义重大。
2. 提示词的 5 段式结构(Subject1/Subject2/人物站位/人物朝相/状态锁定)是可复用的工程模式。把”分镜”内化到模板里,等于在文本层把视频切成子镜头,可控性比”给一段文字”更稳。
3. 部署路径的多样化是开源模型的成熟标志。同一套模型,本地整合包、云端整合包、画布平台三套并跑,是开源 AI 工具真正进入生产链路的工程逻辑。
这套工作流对国内做定制剧本生成、短视频批量化、动漫自动分镜的工程师来说,是一个不错的学习样本——不需要造一个新模型,只要在提示词层、显存层、部署层做好工程优化,就能把开源模型推到生产可用。
配套资源整理:
- 云端版本:RunningHub 工作流页面(浏览器即可用)
- 本地版本:Hugging Face 上 Work-Fisher/MiniMax-H3-Wuxia-Fight-Workflow(全套工作流 + 模型)
- 整合包:9.8GB ComfyUI 纯净版 + 配套模型(已预装稀疏注意力、瓦片注意力、LightX2V 等十几个插件)
- 画布平台:AIFisher 无限画布(work-fisher.com,提供 MiniMaxH3 模板节点)
最后再次强调——这套方案定位明确,不适合做所有类型的视频。它的工程价值在于”在高动态武打场景这条赛道上,用最低门槛做到接近实拍的质量”。