Kimi K3.1 Pro 深度实测:API 与订阅两本账,到底哪本更贵
Kimi K3.1 Pro 发布当天,社区就分成了两派:一派说这是今年性价比最高的大模型,单任务成本只有 Claude Opus 5.5 的七分之一;另一派说配额十分钟就没了,简直是抢钱。
两派都没算错,因为他们算的根本不是同一笔账。这篇把 Kimi K3.1 Pro 的 API 账单和订阅账单分开算,顺便回答三个最该问的选型问题:你用 API 还是订阅?这个活值得它想那么久吗?这是它擅长的领域吗?
一、两个把配额烧光的真实案例
先看争议的源头,两个流传很广的使用记录:
| 用法 | 结果 |
|---|---|
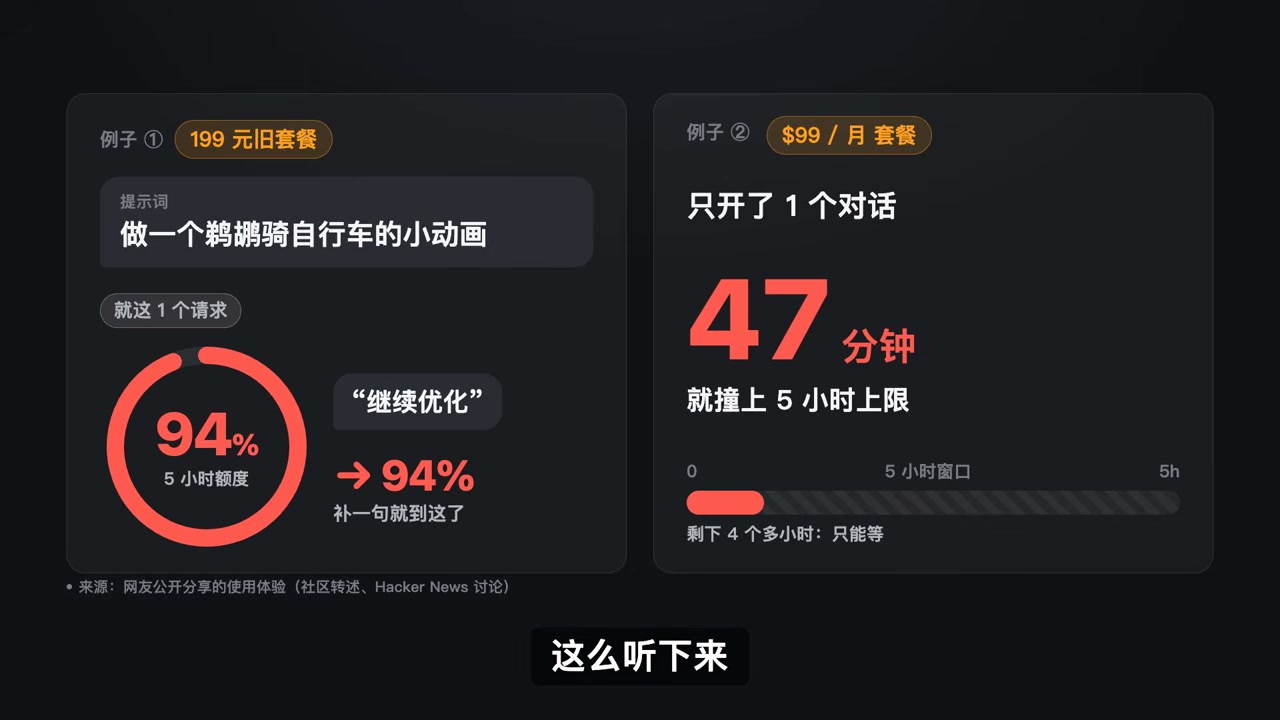
| 国内 ¥199/月 旧套餐,提示「做一个鹅鹅鹅骑自行车的小动画」 | 一次请求吃掉 66% 的 5 小时配额;补一句「继续优化」直接到 94% |
| 海外 $99/月 套餐,只开了一个对话 | 47 分钟撞上 5 小时上限,剩下 4 个多小时只能干等 |
两个案例共同点不是「模型慢」,而是额度是按时间窗口切的,而模型每次都在全力思考。Kimi Code 的会员规则写得很直白:滚动 5 小时用量限额对所有套餐都在(新套餐 Plus 及以上取消了周限额,旧的 Andante 及以上同时保留周限额),并且所有会员功能还共享同一个月度额度池。
先记住这个机制,后面所有的数字都靠它来解释。
二、先把两本账拆开:API 不是订阅
这是最容易被混淆的一点。Kimi 的 API 文档里写得很明确:API 采用按需付费模式,与会员订阅计划是分开的,两回事。
- API:只为你实际消耗的 token 付费,没有窗口期,没有隐藏上限,单价公开。
- 订阅:每月固定金额,平台发一份额度。额度是按用量扣的,而且把某个功能用满,会影响同一额度池里的其他功能。
同一个模型,走这两条路,成本结构完全不同。所以「Kimi K3.1 Pro 到底贵不贵」这个问题,必须分两问。
三、它到底有多强:65.7 分,但别急着信榜单
先把基本盘摆出来:K3.1 Pro 是 K3 的后训练升级版,总参数 2.8T,MoE 架构,每个 token 实际激活约 104B,上下文 1M tokens。这些数字来自 Kimi 官方技术博客。
官方高光成绩来自 Terminal-Bench 4.0(官方榜单)—— 要求模型在终端里读文件、输命令,从头到尾完成一项真实任务:
| 模型 | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66.4 |
| Kimi K3.1 Pro(官方) | 65.7 |
| Artificial Analysis 复测 | 67 |
| GPT-6 Astra | 58.2 |
同一个模型为什么会出现 65.7 和 67 两个数字?因为 harness(套在模型外面那层工具和流程)。Kimi 自测用的是 Claude Code,Artificial Analysis 用的是自家那套评测框架——社区里管这叫「安全带」。同一辆车,换一身安全带,差一两分完全正常。
所以看榜单的第一反应应该是:谁测的、怎么测的,而不是直接抄分数。
四、基准分数是上限,不是你的结果
榜单有个众所周知的毛病:它测的是「最优情况」。
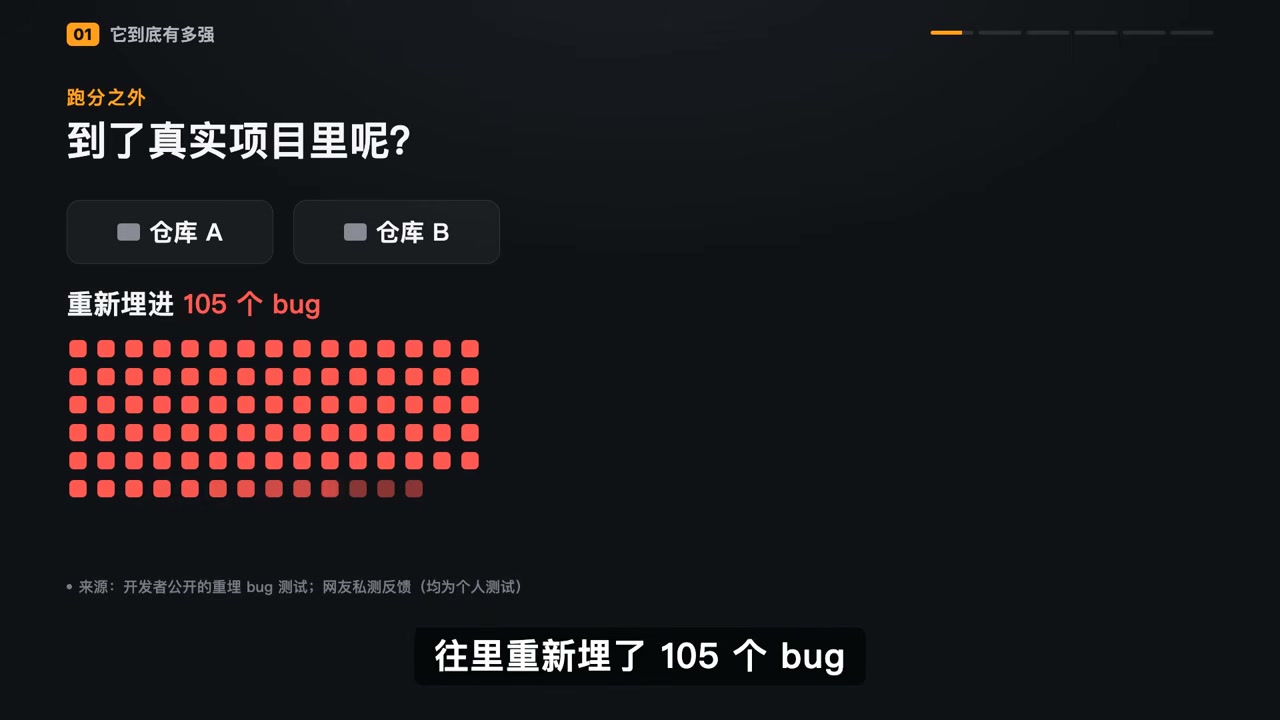
有开发者做了个更接近日常的实验:在两个真实代码库里植入 105 个漏洞,让模型自己去发现并修复。K3.1 Pro 修好的数量少于 Claude Opus 5.5;也有人反馈把它用到自己项目里时,同样感觉不如 Opus 和 GPT-6 Astra。样本量不大,不能下定论,但它提醒了一件事:
基准测试结果只是上限,不是你最终能拿到的结果。
还有一个更能说明问题的短板:在 Terminal-Bench Science 0.1(科学类终端任务)上,K3.1 Pro 只有 38.1 分,而 GPT-6 Astra 是 68.1 分。它的强项是工程实现和长程代理,不是科学推理。
五、API 这本账:单价降了三分之一,账单却不一定降
先看价格表(Kimi API 定价页,2026-10-24 抓取):
| 模型 | 输入 | 输出 | 缓存输入 | 5 分钟写入 | 1 小时写入 |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 / MTok | $10.00 / MTok | $0.20 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed |
$4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
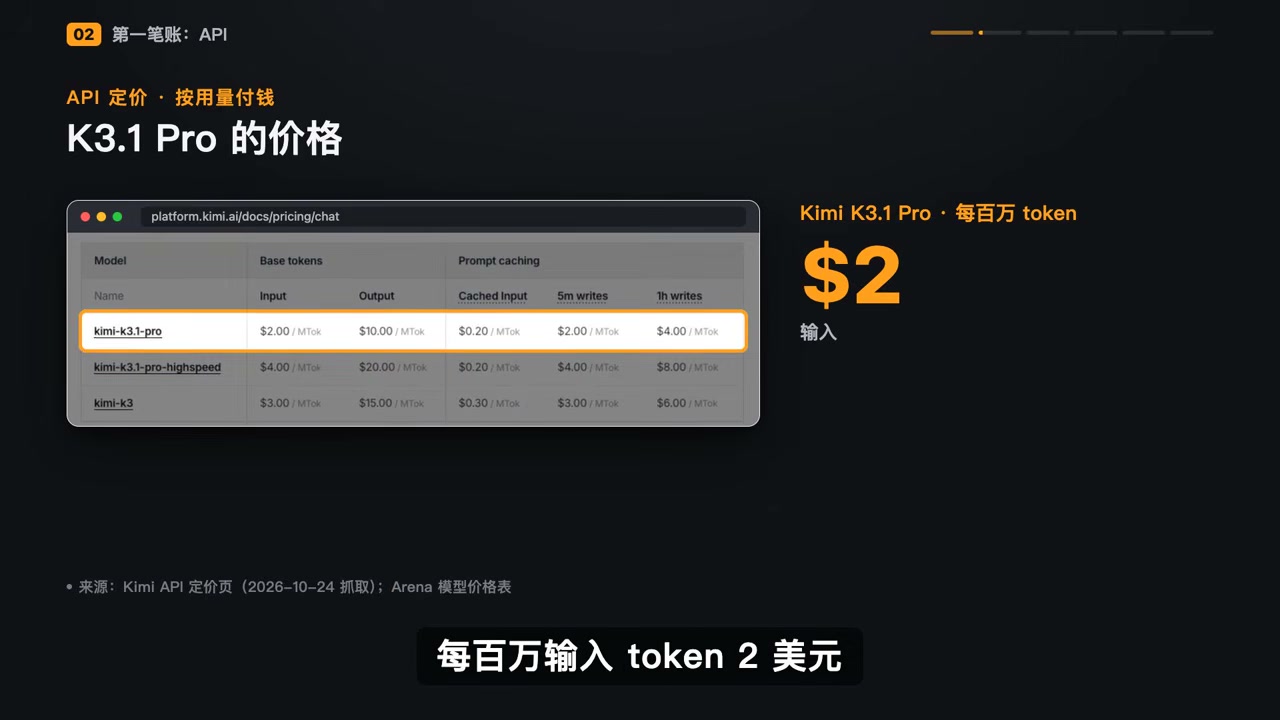
K3.1 Pro 相对上一代 K3,输入和输出各降三分之一,和 Opus 5.5、GPT-6 Astra 处在同一价位,大约是 Opus 5.5 的一半。但单价低 ≠ 账单低,因为账单是「单价 × token 数量」,而这个模型有个明显毛病:啰嗦。
Artificial Analysis 的模型页上直接给了标注:
- 跑完整套 Intelligence Index 测试,K3.1 Pro 吐了 150M token,同榜中位数是 87M,多了约七成;
- AA 在页面上直接写了一句 “very verbose”;
- 相比 K3,每个任务的输出 token 又多了 14%。
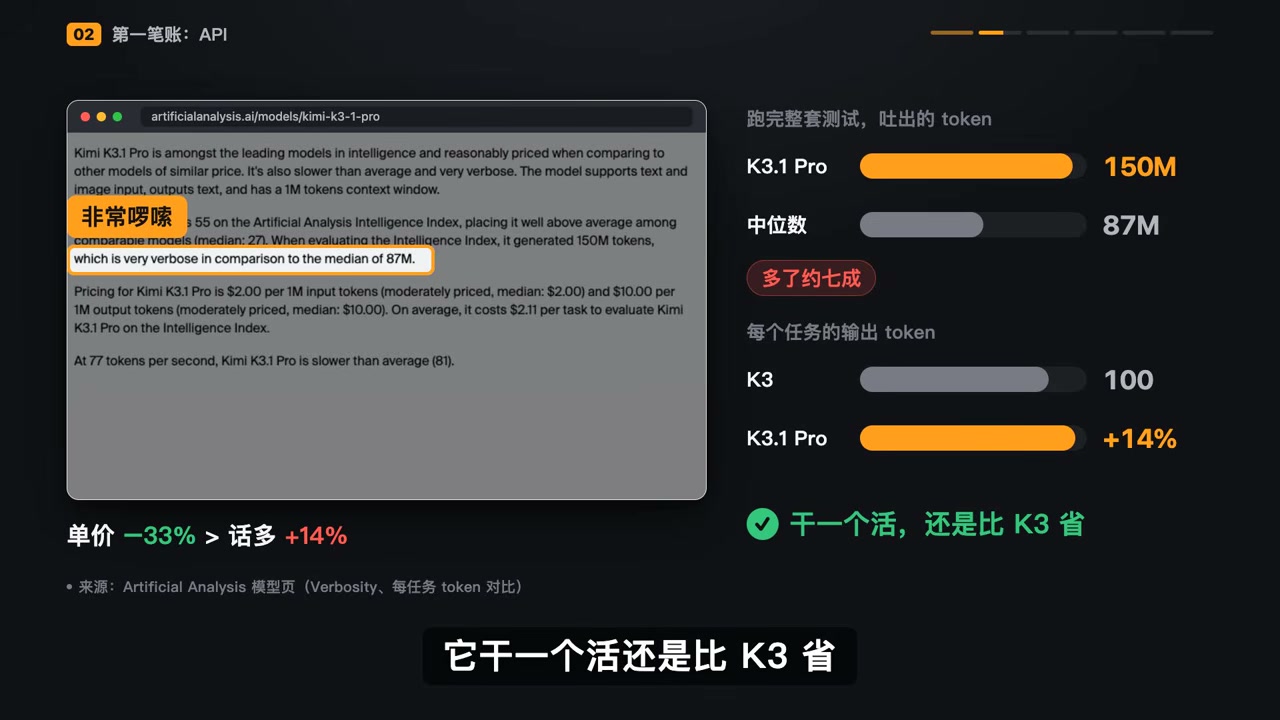
好消息是:单价降的 33% > 话多出来的 14%,所以单任务成本仍然比 K3 更便宜。落到具体数字:
- Kimi 官方图(Terminal-Bench 4.0):K3.1 Pro ≈$5/任务,Claude Opus 5.5 ≈$14/任务;
- Arena 排行榜(Kimi K3.1 Pro $1.23 vs Claude Opus 5.5 $8.86):差不多 七分之一。
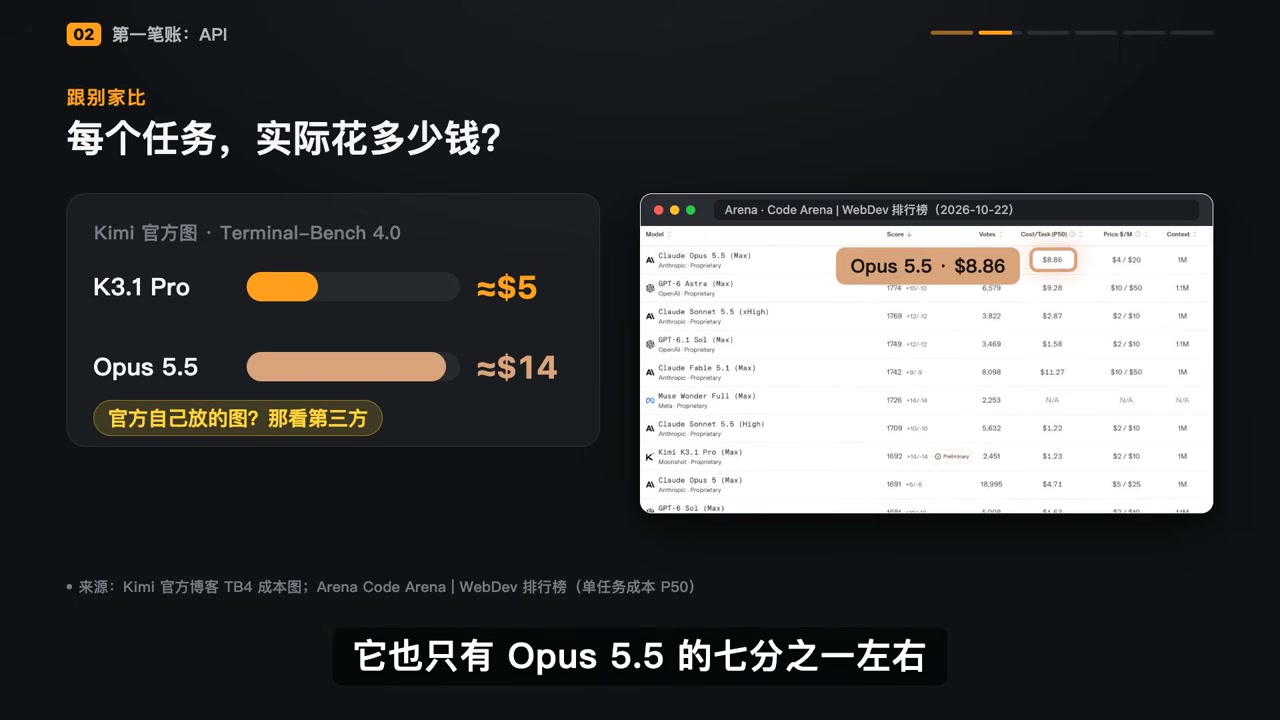
从 API 价格看,这个定价和它的能力是匹配的。
六、订阅这本账:默认 max 思考,配额是不透明的
订阅侧的逻辑完全不同,核心在三条规则:
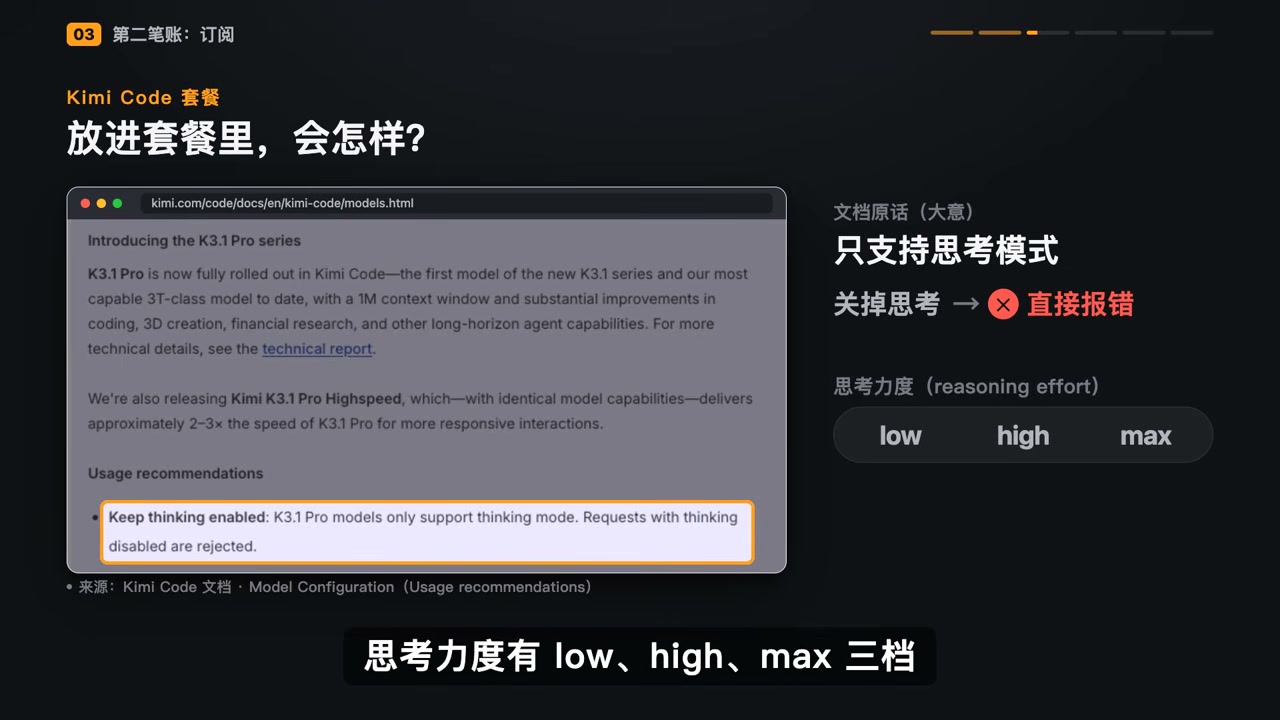
- K3.1 Pro 强制思考模式。 Kimi Code 文档原文:Keep thinking enabled — K3.1 Pro models only support thinking mode. Requests with thinking disabled are rejected. 想关掉思考,请求直接报错。
- 思考强度三档:
low/high/max,不填默认max。 - 思考本身烧 token,并且从你的额度池里扣。
把一个本身就啰嗦、默认又开满思考强度的模型,塞进一个配额不透明的套餐里,会发生什么?社区反馈给出了几个样本:
| 套餐档位 | 结果 |
|---|---|
| $39/月 | 一次测试就吃掉 11.6% 的月度额度 |
| $19/月 | 一项任务之后,5 小时窗口的配额直接用光 |
发布当天,开发者 Simon Willison 照例测了它的「保留节目」:让模型画一只鹅鹅鹅骑自行车。他走的是 API,而且主动把思考强度调到了 low。
同一个提示:在订阅里默认 max,在 API 里可以设 low。一只鹅鹅鹅,两种想法,两种账单。
用自助餐来类比最贴切:订阅是自助餐,价格按普通人的食量定;K3.1 Pro 是那位胃口极大的客人;餐厅供应能力有限,而在这家店里被限制的,恰恰是你。
所以「有人说它便宜得离谱,有人说它贵得离谱」根本不矛盾——大家算的不是同一件事。
七、Highspeed:贵一倍,只买到 20% 的提速
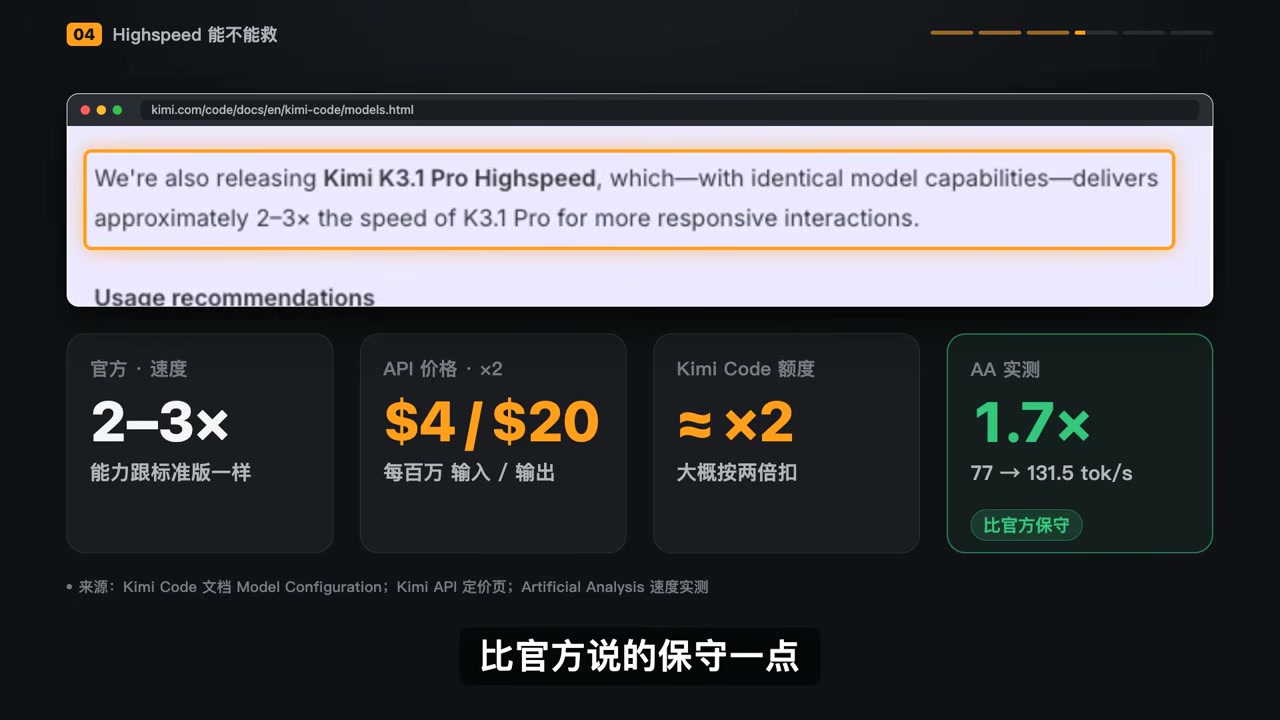
官方给的 Highspeed 卖点是:功能与标准版完全相同,速度快 2~3 倍,API 价格翻倍($4/$20),在 Cursor 里用量大约也是两倍。
实测下来的速度大约是官方宣称的 1.7 倍,比官方说法保守一些。但真正的问题不在这里,Cursor 文档里那一句才是关键:高速模式只加快模型输出速度,不影响工具调用和脚本执行。
因为 AI 写代码不只是「打字」,它还要读文件、跑命令、等测试结果。开发团队公开分享过一次比例:打字快 3 倍,整个任务只快约 20%。
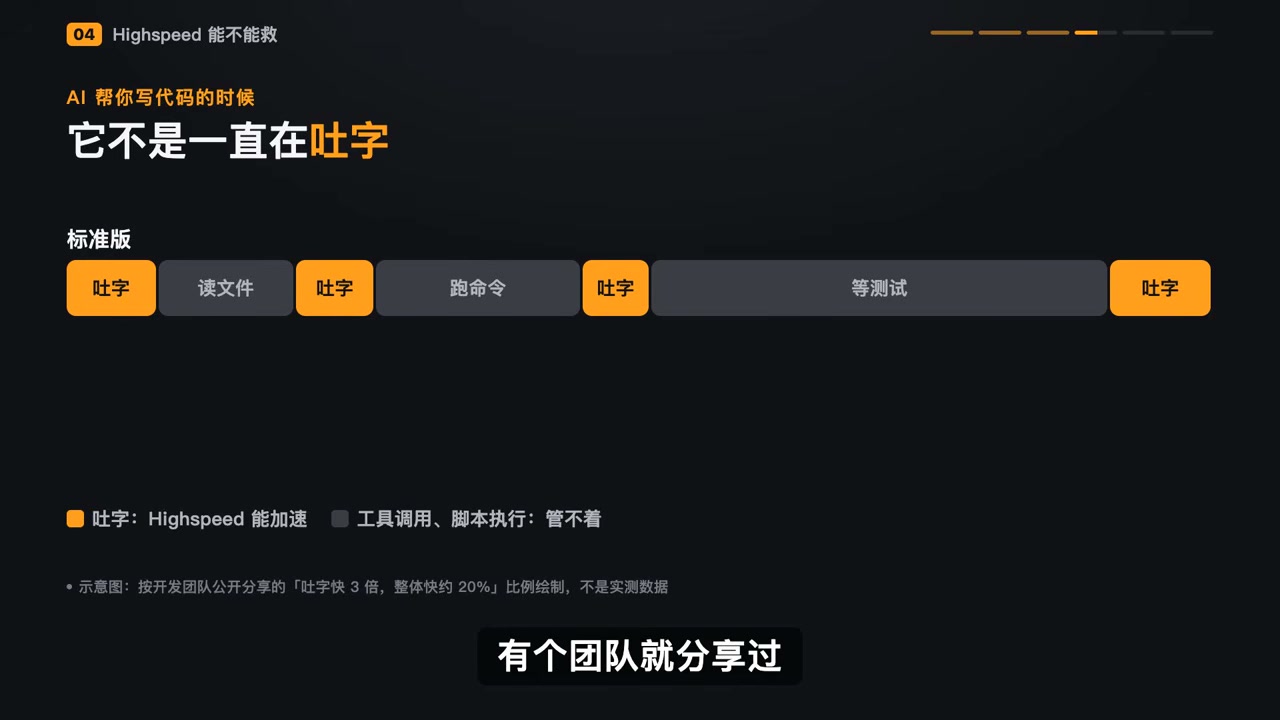
这就像把汽车引擎提速 3 倍,但路上全是红绿灯,总行程时间不会变成原来的三分之一。
高速版真正买到的是「盯着屏幕等响应」的那几秒。 如果你来回聊天、一点点改页面,体感提升明显;如果你把任务丢给 AI 然后去干别的,多花的那一倍的钱,大部分浪费在等红绿灯上了。
八、三个选型问题
问题一:你用的是 API 还是订阅?
- 用 API:在同档模型里这是性价比极高的选择,按量付费,不必赌配额,还能自己控制
reasoning_effort。 - 用订阅:先买一个月而不是年包,跑一个你最高频的任务,看看额度掉了多少,再决定要不要长期付费。别因为榜单分数漂亮就冲年付。
问题二:这个活,值得它想那么久吗?
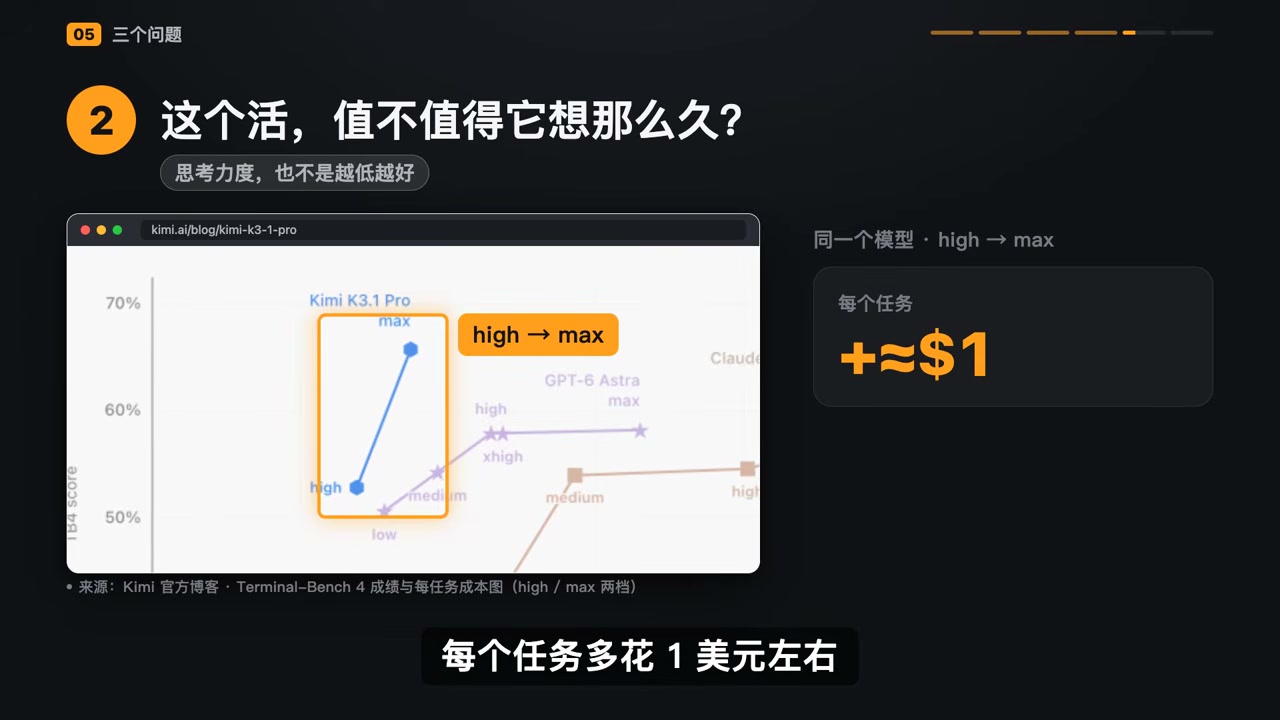
官方图上,K3.1 Pro 从 high 提到 max,每个任务多花约 $1,分数从约 53 升到 65.7。
- 对棘手的代理任务(多步、跨文件、需要反复自检):值得。
- 只是想改一行文本,或者问一个概念:不值得,纯属烧钱。
- 思考强度也不是越低越好,
low在官方图上掉到 50 分上下,high才是大多数场景的平衡点。 - Cursor 里至少可以把思考强度手动调低,别让它一直满档跑。
问题三:这是它擅长的活吗?
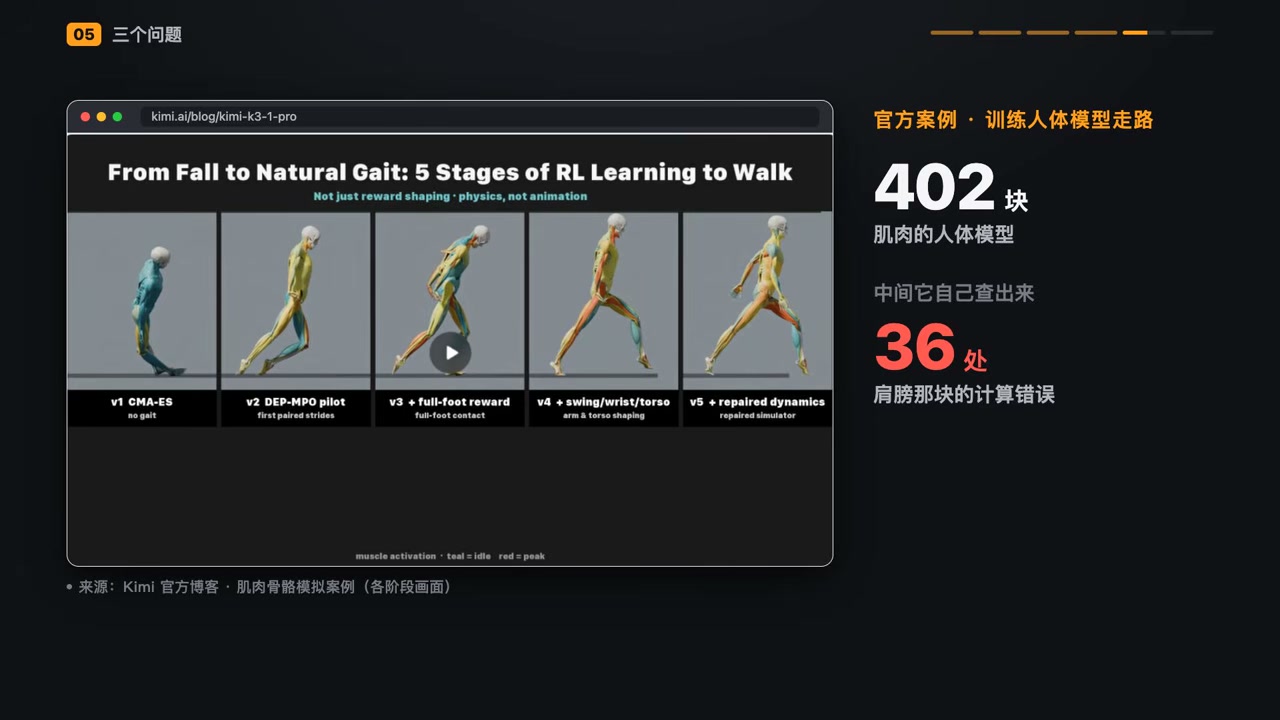
擅长:需要自我反思和反复检查的漫长复杂任务。官方案例是训练一个含 402 块肌肉的人体模型走路,过程中它自己查出肩部力矩臂计算里的 36 处错误,最终把模拟人物从「几秒内倒地」变成交替步法连续走 11 秒以上。
不擅长:中等难度的科学任务(38.1 vs 68.1),甚至基础的多模态常识——有人拿图问「埋在土里的人们安全带都系好了吗」,它也答错。
如果这些任务需要的时间都一样长,那你就是花更多的钱,只换到一个平庸的答案。
九、权重将至,但别想着在家跑
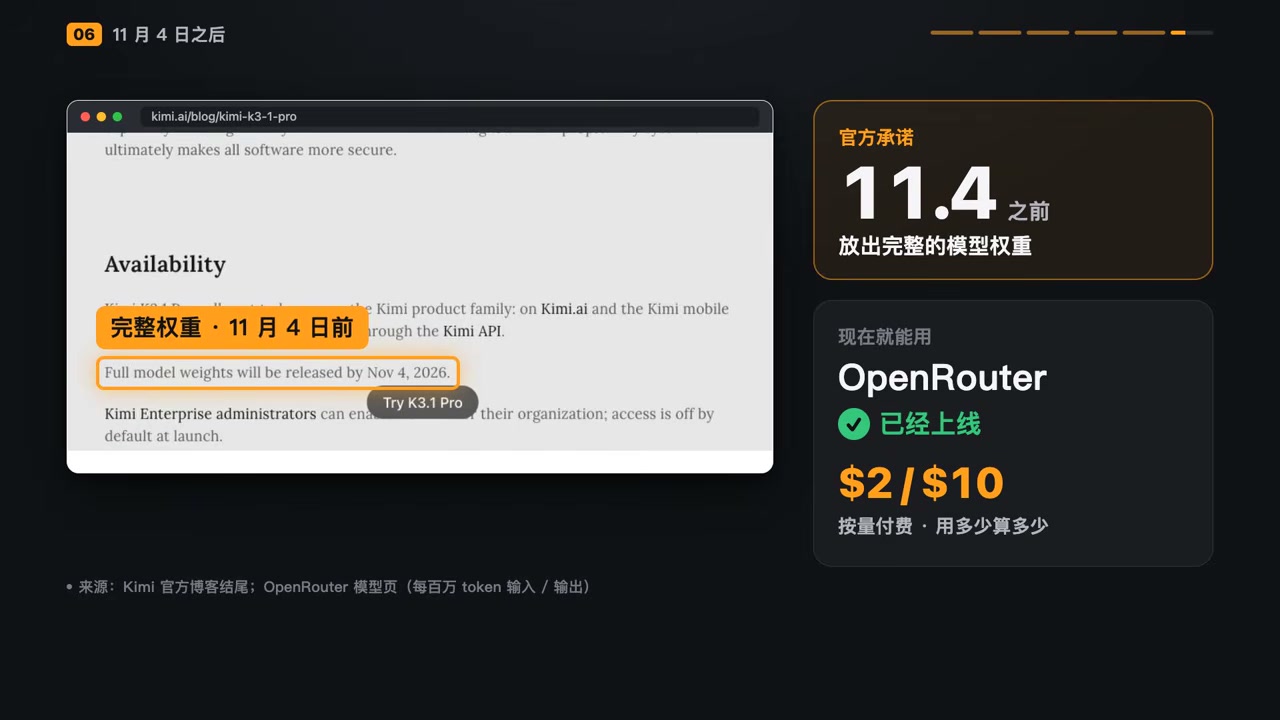
- 官方承诺 11 月 4 日之前公布完整权重;
- 现在已经在 OpenRouter 上线,$2/$10 按量付费,只为你用掉的部分买单;
- 所以「与其买 Kimi 订阅,不如在 OpenRouter 上按需付费」这个建议确实成立;
- 但千万别想着在家跑它:即使压到 4bit,权重仍然约 1.5TB。有人开玩笑说花 12 万美元买硬件在家跑,速度慢得像是在用 Claude Sonnet 3.5。真要折腾本地跑,先用一条命令判断你的电脑最适合跑哪个模型筛一遍,别直接下一个 1.5TB 的教训。
总结
以前看一个新模型,我们通常只盯两个数字:分数,和每百万 token 的价格。
现在要多看第三个:你打算怎么付钱。
API 还是订阅?这个活值得它想那么久吗?这是它擅长的领域吗?先把这三个问题答完,再看榜单分数——只有到那时,这些分数对你来说才真正有意义。
回到开头那配额消失的案例:这不完全是模型本身的错。是把一个「思考能力极强」的模型,放进了按隐藏配额收费、并且默认拉满思考强度的计划里。
如果你正在挑模型,不妨把强模型用来做设计和任务分解,把编码执行这种体力活交给便宜模型——让聪明的模型思考,让便宜模型跑腿,这比纠结「哪个模型最强」实用得多。想更系统地对比各家模型,可以看看 GPT-6 三个模型怎么选;想深入了解任务编排工具,WorkBuddy 教程里有一整套按活选模型的方法;对本地部署 2.8T 级 MoE 感兴趣的话,AirLLM 分层流式方案那篇可以一起看。
你更倾向于用 API 按量付费,还是订阅套餐?欢迎在评论区聊聊你的实际用量和踩坑情况。