
DeepSeek 开源 DeepInfer:一卡日入 900 美元
一张显卡,一个小时,DeepSeek 能挣 38 美元——折算下来一天 900 多美元。这个数字不是营销稿里的话,而是 DeepSeek 在 2026 年 10 月 20 日开源推理框架 DeepInfer 时,写进官方部署文档里的原话。
这件事真正值得拆的不是「900 美元」有多诱人,而是它背后那套以前从没人看过的中间层:模型训练完只是一堆权重文件,怎么把请求排队、凑批、分到几百张卡上算、再把结果送回去,同时把每个 token 的成本压到能赚钱。这一层现在连同配套的部署问答一起被完整交了出来。
一、38 美元是怎么算出来的
官方部署 Q&A 里那段原文是这么写的:
A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing).
翻译过来:单个集群目前每天服务 155 万亿 token,整体收入折合每张 GPU 每小时 38 美元(按闲时价格计算)。
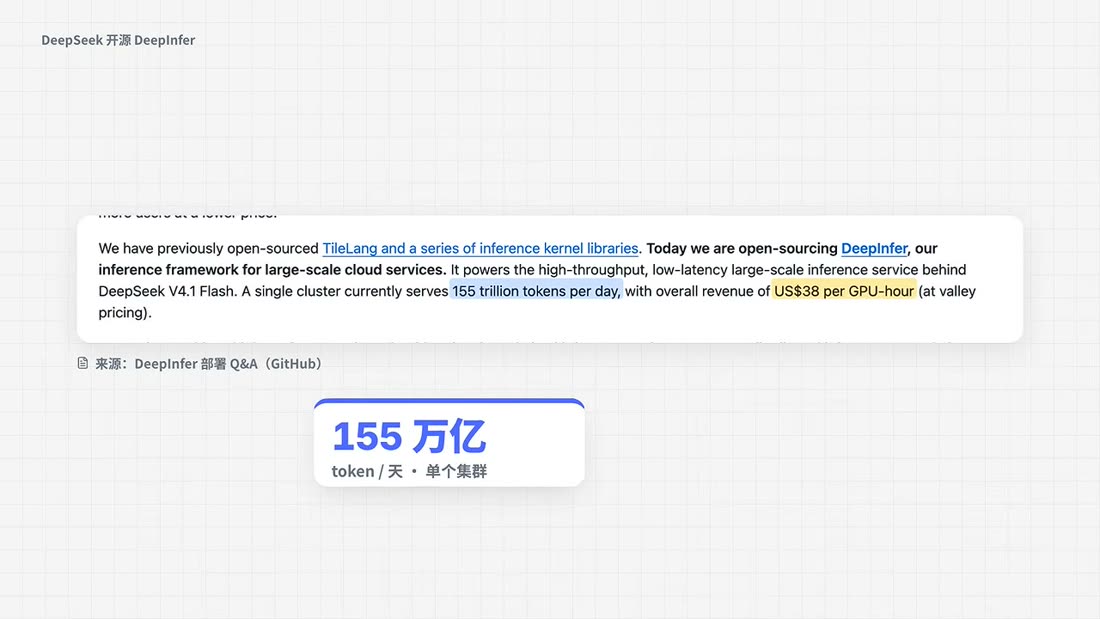
155 万亿是个什么概念?除以一天的 86400 秒,平均每秒约 18 亿个 token 从这套系统里流过去。而且这还只是一个集群,不是 DeepSeek 的全部产能。
但这里有两个必须泼的冷水:
第一,这是收入,不是利润。 官方没有公布成本,也没有说这样的集群一共有几个。「一张卡日入 900 美元」是真的,「到底赚了多少」目前无从得知。
第二,38 美元是按闲时价格算的。 这也意味着这个数字偏保守——高峰时段同样产出的收入更高。下一节具体看价格。
二、DeepInfer 到底在跑什么
先把概念说清楚。模型训练完只是一堆权重文件,要让几千万人同时用它,中间还需要一层系统:它得把请求排好队,凑成一批,分到几百张卡上一起算,算完再把结果送回去。
更具体一点,比如你发了一个很长的问题,模型读过的内容会先存下来(这就是 KV 缓存),你下次接着问就不用从头再读一遍。这一层做得好不好,直接决定了每个 token 的成本。
按 DeepSeek 自己的形容,这是一个长期没被公众了解的中间层:用户不直接接触,但又非常重要。
官方给出的整体架构图长这样:
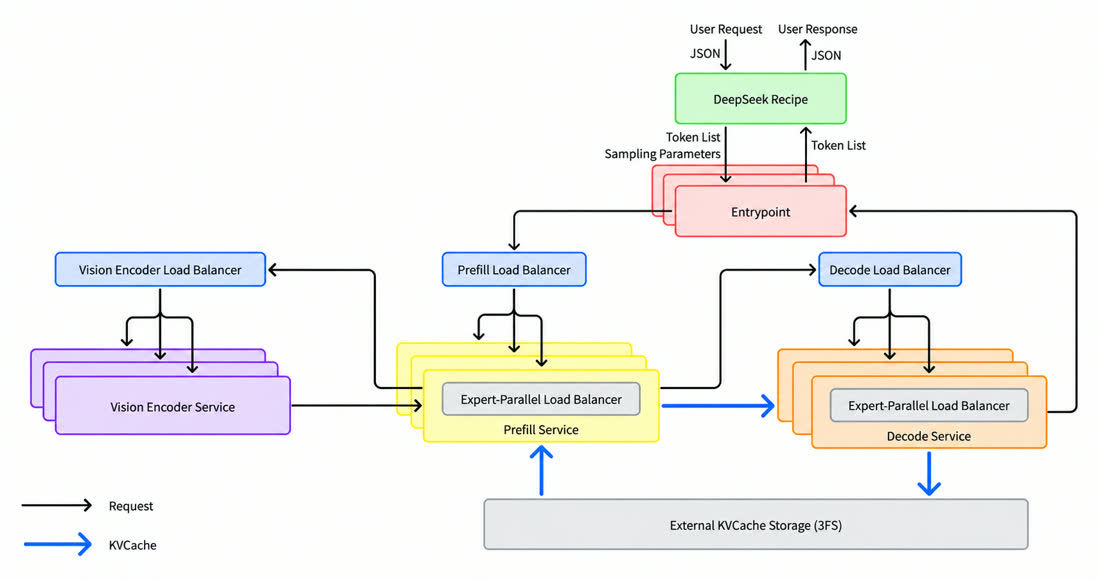
从上往下看:
- 最上层是 DeepSeek Recipe,请求进来先在这里变成 token
- 往下分成三路:看图片的视觉编码(VE)、读输入的预填充(Prefill)、写答案的解码(Decode)
- 每一路前面都有一个负载均衡器负责分活
- 最底下是专门存缓存的存储集群(3FS 分布式文件系统)
所以 DeepInfer 这个仓库里装的是:高性能算子、模型与采样运行时、并行策略(Attention DP / 均衡 CP、MoE EP + EPLB)、推测解码、异步调度、结构化输出这些引擎本体。仓库基于 vLLM 起步,同时借鉴了 SGLang 与 TensorRT-LLM,许可证 Apache-2.0,目前支持的目标模型是 DeepSeek-V4.1-Flash。
三、DeepSeek 把自己推翻了
这件事之所以耐人寻味,是因为一年半前 DeepSeek 亲口说过不开源。
2025 年 4 月,DeepSeek 写过一篇《The Path to Open-Sourcing the DeepSeek Inference Engine》,列了三条理由拒绝开源完整推理引擎:
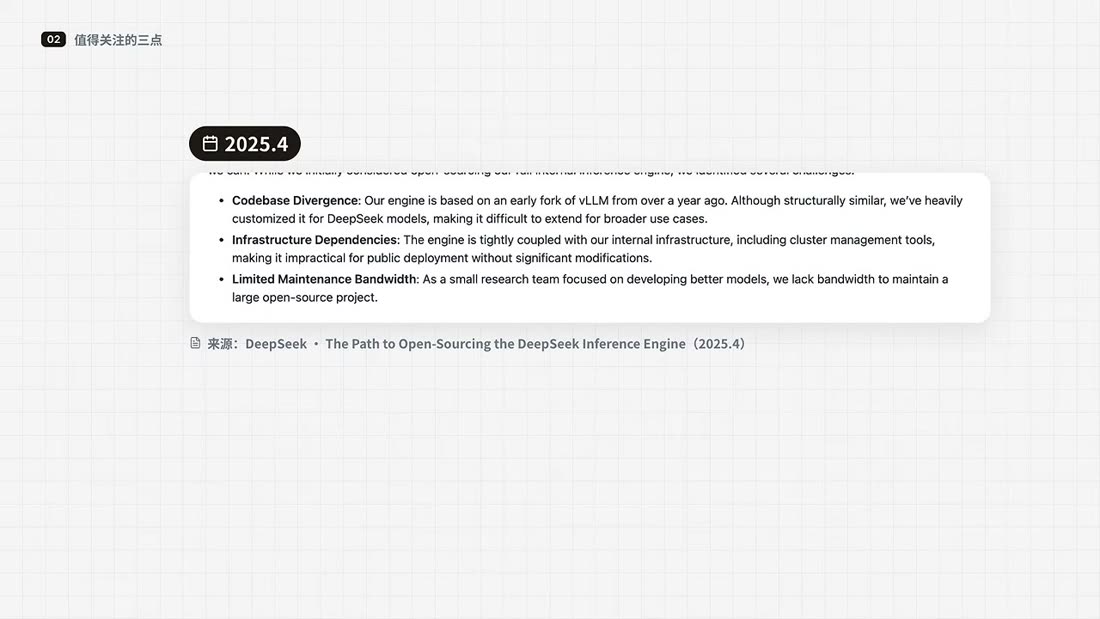
| 官方理由 | 原文要点 |
|---|---|
| Codebase Divergence | 代码是一年多前从 vLLM 早期版本分出来的,改得太深 |
| Infrastructure Dependencies | 和内部基础设施(包括集群管理工具)绑定得太紧 |
| Limited Maintenance Bandwidth | 我们是小型研究团队,没有精力维护一个大型开源项目 |
注意时间线里的一个反转:2025 年 4 月 DeepSeek 曾在 GitHub 预告要开源推理引擎,同年 5 月却改口——不直接开放内部完整代码库,改为把核心优化成果贡献给 vLLM、SGLang 这些开源项目。
一年半之后的 2026 年 10 月 20 日,引擎还是放了出来,而且这次是连同生产级的 token 编解码组件 deepseek-recipe 一起。后者的处理逻辑与官方 DeepSeek API 完全对齐,意味着第三方部署出来的 DeepSeek,接口行为跟官方一样。
结果就是:越来越多厂商用 DeepSeek 的标准方案,生态位越滚越大。 仓库公开一天多,star 就冲破 1.2 万,到写这篇文章时已经接近 1.5 万,fork 1400+,配套的 deepseek-recipe 也有 1700+ star。
四、账本:闲时价格 + 缓存命中
「一张卡一天 900 美元」背后是 API 的定价结构。DeepSeek 的 API 分高峰和空闲两个时段,空闲时段直接打五折:
- 高峰时段:工作日 01:00–04:00 与 06:00–10:00 UTC,即北京时间 09:00–12:00 和 14:00–18:00(中国法定节假日除外)
- 其余时间(含周末、节假日)全是闲时价
DeepSeek-V4.1-Flash(模型名 deepseek-flash)的官方价格:
| 每 100 万 token | 闲时 | 高峰 |
|---|---|---|
| 输入(缓存命中) | $0.003(约 ¥0.02) | $0.006(约 ¥0.04) |
| 输入(缓存未命中) | $0.15(约 ¥1) | $0.30(约 ¥2) |
| 输出 | $0.60(约 ¥4) | $1.20(约 ¥8) |
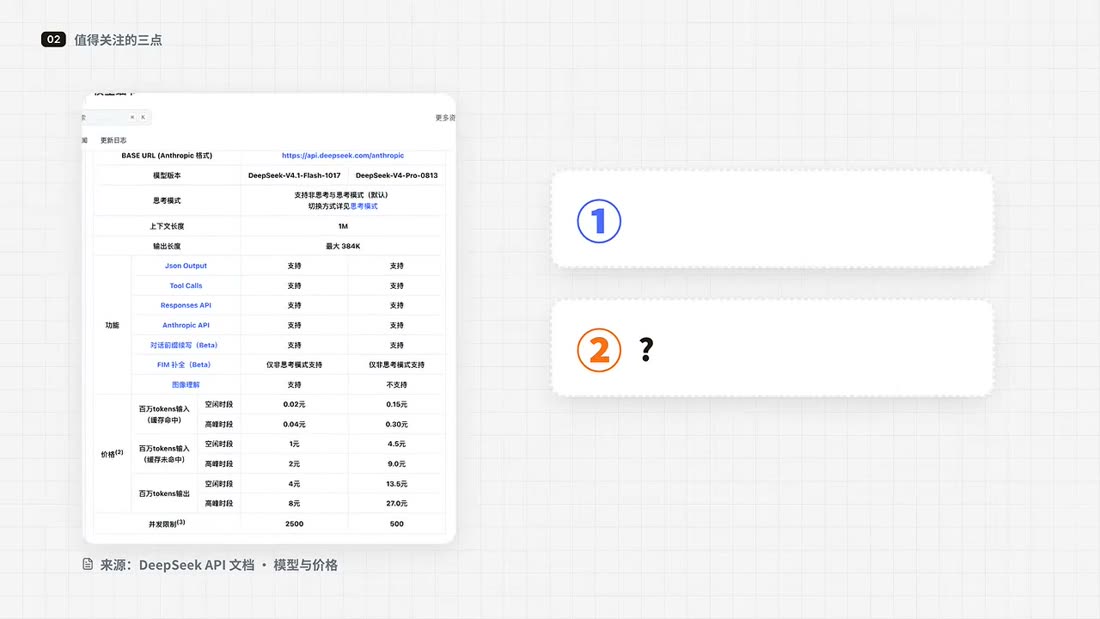
对照看两件事:
一、38 美元是按闲时价算的,也就是用「缓存命中输入 2 分钱、输出 4 块钱」这一档折算的,属于保守口径。
二、那 2 分钱完全靠缓存命中撑起来。 缓存未命中的输入要 ¥1,是命中价的 50 倍。整套系统的经济性,建立在「同一段上下文能被反复复用」这件事上——这也是为什么后文要花那么大力气讲缓存集群。
顺带一提,同一价目表上 DeepSeek-V4-Pro 的闲时价是缓存命中 $0.022、未命中 $0.66、输出 $1.98,并发上限 500;Flash 的并发上限是 2500。
五、昇腾 950 与 Blackwell 并列
这次开源最容易被忽略、但战略意味最重的一点,是它支持的硬件清单:
清单只有两行:
- NVIDIA SM100(也就是 Blackwell / B200 这一代)
- 华为昇腾 950(Ascend 950 NPU)
注意一个信号:市面上存量最大的 H100、H800 并不在名单里。 这不是兼容性问题——是这套系统按最新的 scale-up 域(超节点)设计的,EP64 起步的 Wide-EP 解码架构本来就要求新一代硬件。
对模型厂商来说,这意味着多了一条不被单家卡脖子的路;对国产算力生态来说,昇腾第一次和英伟达最新一代摆在同一个生产级推理框架的支持列表里。华为官方发布会上反复提到梁文锋团队的贡献,不是客套。
六、别急着欢呼:这次没开源的三样东西
「全面开源」这四个字要打个折扣。官方在 README 里明确列出了搭一个完整推理服务还需要、但这次没给的三样东西:
- KV 缓存系统——存模型读过的内容的那一套
- VE / Prefill / Decode 拆开部署的那一层(大部分引擎功能其实已经实现,只是编排层没放)
- 多个数据并行副本之间的负载均衡
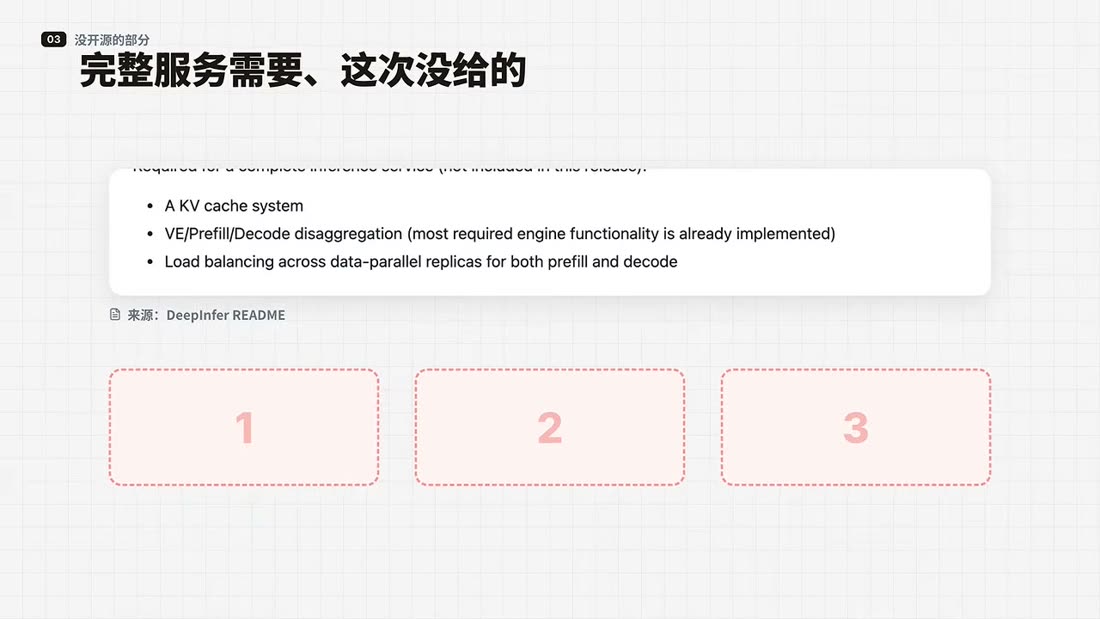
对照第二节那张架构图就很清楚:几个负载均衡器,加上最底下的存储集群,基本上都不在这次的代码里。 官方给的原因是这些组件和内部基础设施耦合太紧,这次只开源引擎,调度和缓存还留在自己家里。
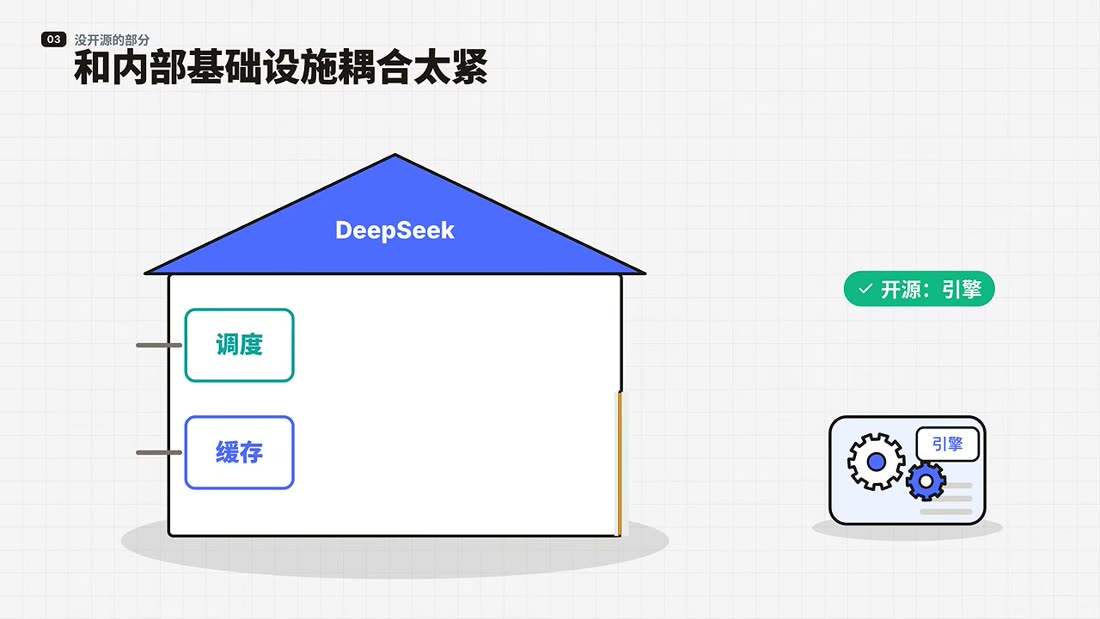
缓存这一块的分量其实很重,官方文档里的细节值得抄下来:
| 项目 | 数值 |
|---|---|
| 存储介质 | 3FS 分布式文件系统,10+2 纠删码,单组可容忍 2 个节点同时故障 |
| KV 缓存总容量 | 约 100 PiB SSD |
| 缓存保留期 | 聊天流量 7 天、Agent 流量 3 天(聊天流量的长尾命中率更高,按 3 天算会损失 0.5%–1% 命中率) |
| 存储与算力配比 | 约每张 GPU 14.4 TB 逻辑容量(物理容量更大) |
| 单台存储服务器 | 20 × 30.73 TB SSD,≥40 GB/s 读、5 GB/s 写,保留 24 小时数据 |
| 预填充上下文分档 | <16K / 16–64K / 64–256K / ≥256K 四档,按算力配额动态分配引擎 |
为什么缓存留存要按「天」算?因为同一段长上下文被反复问的概率极高,缓存留得越久,重算越少。那 2 分钱一位的缓存命中价,就是这么撑起来的。
七、门槛:128 张卡起步
这是最需要泼冷水的地方。官方 Q&A 里对「最小部署单元」的回答很直白:
1P + 1D is deployable… Since the recommended decode configuration is EP64 or above, the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode.
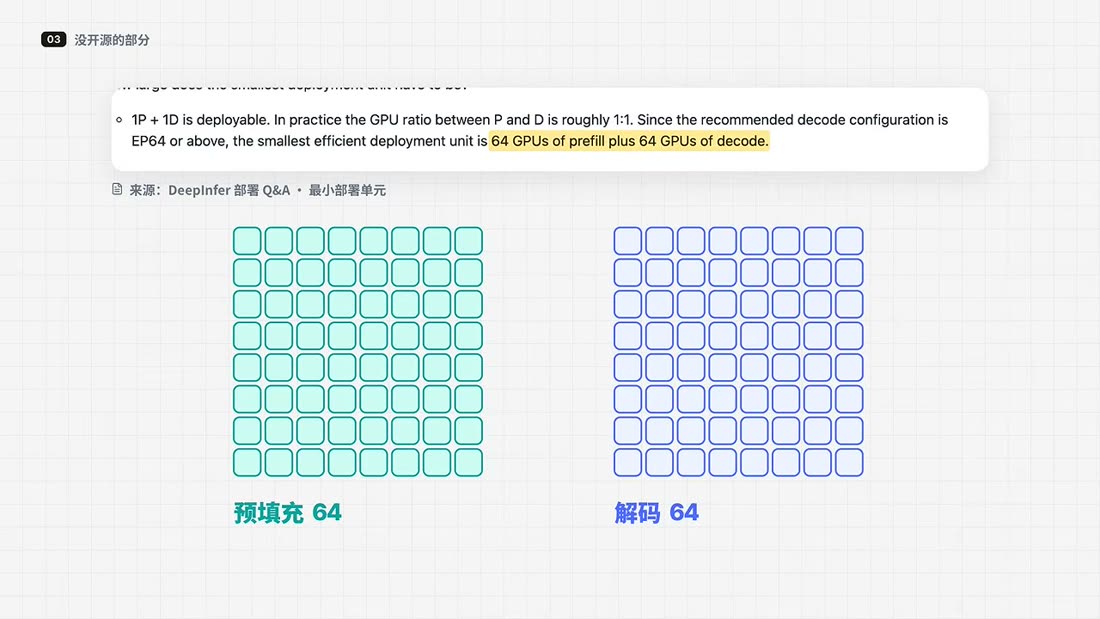
翻译:1 预填充 + 1 解码可以跑起来,但推荐解码配置是 EP64 起步,所以最小的高效部署单元是 64 张卡做预填充 + 64 张卡做解码。
128 张 Blackwell 级别的卡,起步就是一个小机房。所以:
- 手上只有一两张 4090 的个人开发者,跟它基本没关系。
- 想在自己电脑上跑 DeepSeek,用 vLLM、SGLang,或者找量化版本才是更现实的路子。具体怎么挑,可以看我之前写的 Strata 实测:64G 内存 + 16G 显卡本地跑 125B 千亿大模型 和 告别瞎蒙式下载本地大模型:一条命令告诉你的电脑最适合跑哪个。
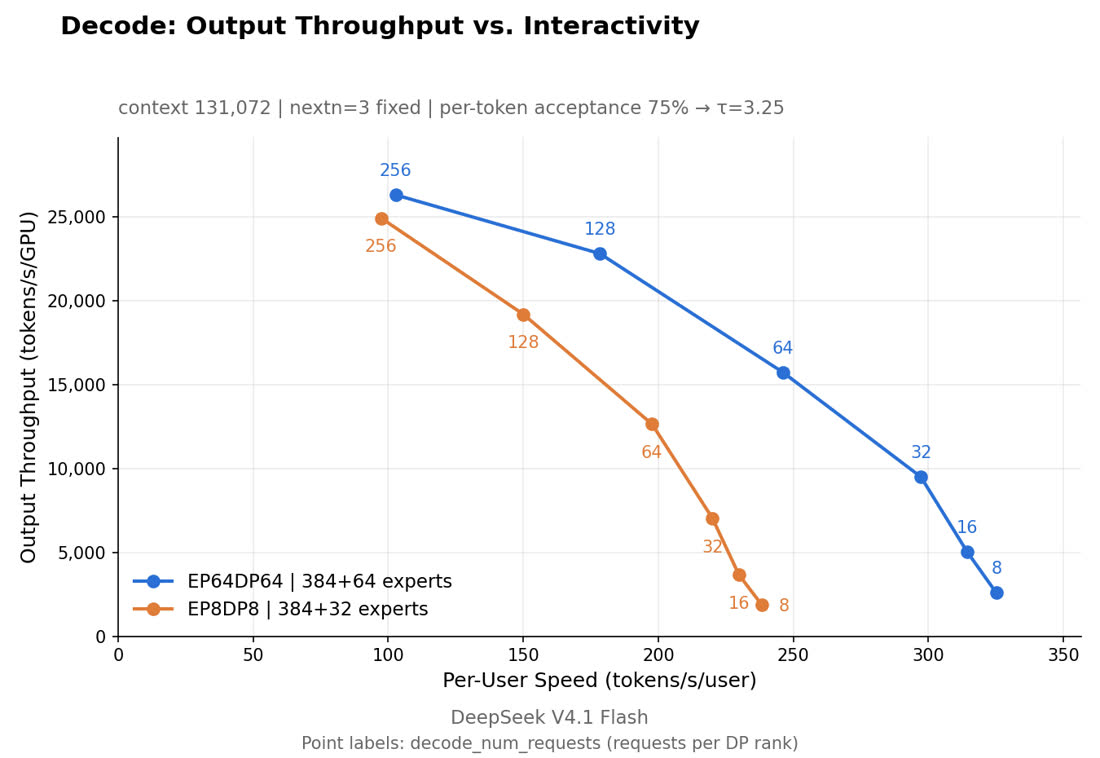
顺带把并行策略也摆出来,方便判断规模:
| 阶段 | 推荐并行配置 |
|---|---|
| 预填充(Prefill) | EP2–8 / DP2–8,用 HBM 允许的最小 EP/DP |
| 解码(Decode) | EP64–128 / DP64–128(Wide-EP),用显卡允许的最大 EP/DP |
| 视觉编码(VE) | 单卡一个实例即可,且推荐更便宜的卡 |
八、谁真正用得上
答案很明确:云厂商,以及需要私有化部署的大企业。
以前第三方部署 DeepSeek 模型,用的是 vLLM、SGLang 这些通用框架,DeepSeek 自己的优化只能拆成零散的组件、一点点贡献出去。现在整个引擎直接交到手里,再加上 DeepSeek Recipe 保证接口行为和官方一致,云厂商部署出来的 DeepSeek,效率会更接近官方。
这带来的直接推论是:第三方 DeepSeek API 的价格,估计还有往下走的空间。 部署门槛降下来,供给就会变多,价格战就是自然结果。
九、这次开源最有价值的,其实是那份部署问答
如果只带走一个结论,我的判断是:代码本身的稀缺性没有想象中高,那份配套的部署问答才是真正的稀缺资产。
因为它把平时各家云厂商压在箱底的经验,一条条写了出来:
- 并行怎么切(预填充 EP2–8、解码 EP64–128 的取舍)
- 专家怎么均衡(EPLB:预填充每卡 4 个冗余专家、100 步统计窗、每 1000 步重分配;解码每卡 1 个冗余专家,EP64 时每卡 7 个专家、1000 步窗、每 10000 步重分配)
- 缓存存在哪、留几天、怎么按 LRU 回收
- 坏了一张卡怎么办(大 EP 部署里一个实例是一整个通信域,单卡故障会导致整实例不可用,重启时按实际健康的卡数重新确定 EP 规模)
- 负载均衡能做到什么程度——目前约为完美均衡离线基准的 80%
里面最实用的一块是推测解码(DSpark)。做法是小模型一次猜 5 个 token,大模型负责验证;DeepSeek 给每个猜测打一个自信度,只验证值得验证的那几个。
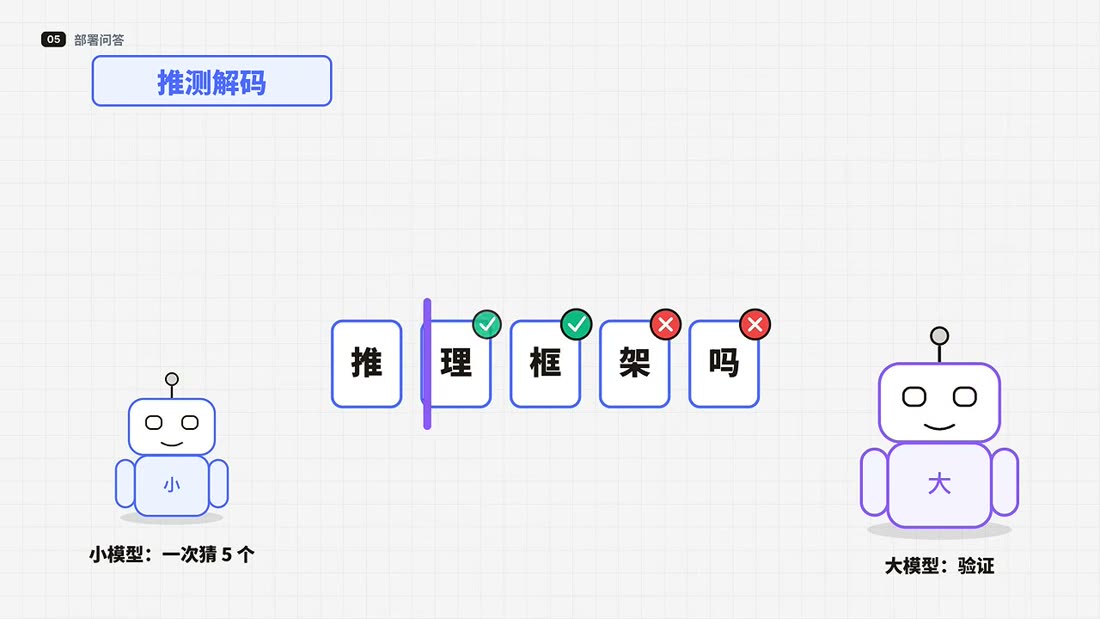
官方数据是:每步验证的 draft token 数从 5.00 降到 3.2–4.4,少了约三成;而平均接受长度几乎没变(3.29 vs 3.20);在生产工作点(约每卡 60 条并发序列)上,整体吞吐提升 4%–7%。
这种提升单独看确实不起眼。可放到一天 155 万亿 token 的规模上,省下来的就是实打实的电费和显卡。
十、我的三点判断
第一,DeepSeek 把定价权的一部分交给了第三方。 引擎 + Recipe + 部署问答三件套,等于把「接近官方的效率」变成了可复现的工程作业,而不是各家电商各凭经验调参。第三方 API 的价格还有下探空间。
第二,昇腾 950 进清单,比代码本身更有战略含义。 国产算力第一次拿到与英伟达最新一代同等的生产级推理框架支持位,而 H100/H800 被甩在门外,意味着这套系统的设计前提就是「新硬件 + 新超节点」,不是给存量卡做兼容。
第三,这是一份给专业读者的礼物,不是给个人开发者的。 128 卡门槛摆在那儿,手上一两张 4090 的朋友别被「一天 900 美元」带偏了。但如果你关心的是推理成本怎么降下来——缓存怎么设计、预填充怎么分档、负载均衡怎么切、推测解码怎么省算力——这份文档值得逐条读。顺带推荐一篇 4GB 显存跑 70B:拆解 AirLLM 的「分层流式」魔法,那是从个人玩家视角切入推理成本优化的另一个解法。
总结
DeepSeek 用一年半时间走完了一条「说不开源 → 换种方式贡献 → 干脆全开源」的完整曲线,最终交出来的不是一个模型,而是一条可复制的生产级推理流水线。
三个数字记住就够:155 万亿 token 每天、每卡每小时 38 美元、最小高效部署单元 128 张卡。第一个说明规模,第二个说明这套系统确实能赚钱,第三个说明谁玩得转。
真正值得存下来的,是它背后那套方法论:把每一个 token 的成本拆到缓存、分档、负载均衡、推测解码里去一点点抠。省下来的 4%–7% 吞吐,乘上每天 155 万亿 token 的规模,就是电费和显卡的差别。
仓库地址:github.com/deepseek-ai/DeepInfer(Apache-2.0)
部署问答原文:doc/inference_deployment_qa.md
官方 API 定价:api-docs.deepseek.com/quick_start/pricing
你现在用 DeepSeek API 还是本地自部署?第三方 API 的价格你觉得还能再降多少?评论区聊聊你的成本账,收藏这篇,等 DeepSeek 新模型上线时回来对照一下。