Agent Harness 真的死了吗:三组实测数据与数据飞轮
Agent Harness 是不是已经死了?这是 2026 年下半年编程圈吵得最凶的一个问题,也是很多人选型时踩坑的开端:有人据此把 Claude Code 的护栏全拆了,有人干脆换成一个只会读文件、写文件、改文件、跑命令的极简工具。
这篇把答案拆到能落地:先用三组公开实验说明 Harness 对成绩几乎没影响、对账单影响很大,再解释背后的数据飞轮,最后给出模型吃不掉的三件事和两条今天就能做的动作。结论可能和直觉相反——该变薄的不是你的工作方式,是模型外面那层花哨的说明书。
一、Agent Harness 到底是什么:模型外面那一层
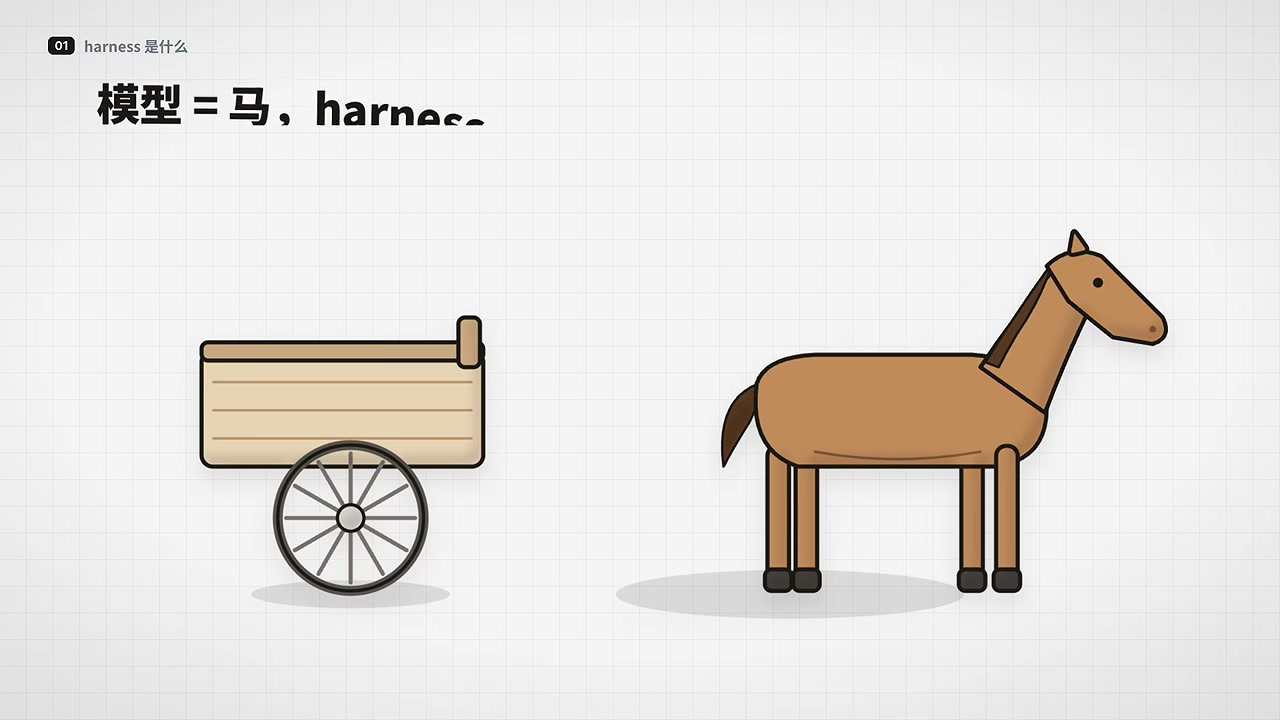
Harness 直译是「马具」——套在马身上的缰绳和车辕。马有力气,但不套上这一套东西,它拉不了车。放到 AI 里,模型就是那匹马,Harness 就是包在模型外面、让它能真正干活的那一层软件。
它管的事很杂:给什么提示词、能用哪些工具、记忆怎么存、对话太长怎么压缩、哪些事要拦住不让做、任务在哪台机器上跑、断了怎么接着跑。你天天用的 Claude Code、Codex、Cursor Agent,说白了都是一个模型加一套 Harness。模型可以换,外面这一层决定了它用起来顺不顺手。
更实用的拆法是分两层:
| 层 | 管什么 | 性质 |
|---|---|---|
| 运行时层(runtime) | 在哪执行、状态怎么存、中断后怎么恢复、沙箱与进程生命周期 | 传统软件工程,已经很成熟 |
| 上下文与编排层(context / orchestration) | 调哪个模型、给它看什么、工具定义、记忆压缩、行为干预、多 Agent 协作 | 「西部荒野」,没有定论 |
「Harness 已死」这场争论,吵的几乎全是第二层。第一层从头到尾没人否认。
二、三年换了三个名字,干的却是同一件事
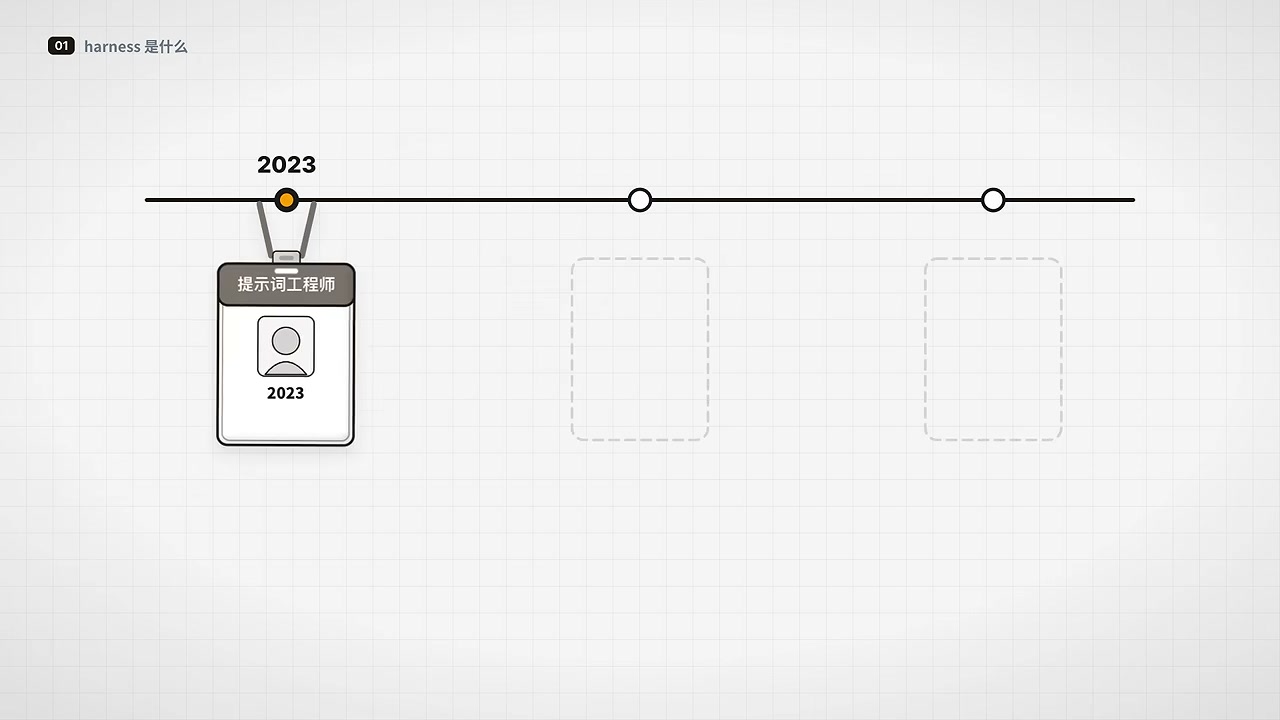
2023 年最火的职位叫提示词工程师;到 2025 年中变成了上下文工程师——负责在每次调用前把最合适的材料拼好塞给模型;2026 年初才落到 Harness 工程师这个词上。
每次改名都是范围的一次扩大:写好一条指令 → 挑选模型该看到的信息 → 设计模型所处的整个执行环境。名字换了,本质没变:模型外面那一层怎么搭才好用。
YC 总裁 Garry Tan 对这个方向下过一句很锋利的判断:
如果你的记忆随 Harness 一起死掉,说明你的 Harness 搭得太厚了。记忆是 Markdown,技能也是 Markdown,Harness 只是一个读这些文件的指挥者,并不拥有它们。
他的说法是「thin harness, fat skills」——薄 Harness,胖技能。这句话后来几乎成了整个讨论的 slogan。
三、「Harness 已死」的第一批证据:最懂它的人都在做减法
2026 年 1 月 14 日,Cursor 发布 Scaling long-running autonomous coding。 他们用一套长时运行的 harness(内部叫 Grind Swarm)编排大量 Agent 和机器,从零写出一个浏览器:跑了一周,1000 个文件,超过 100 万行代码,消耗的 token 以万亿计。
这就是 2026 年初的思路——模型不够强就用 Harness 补,几百个 Agent 分工协调,大力出奇迹。代价写在他们自己的博客里:这套演示非常贵,至少两次把 Cursor 自己的基础设施压垮。
然后风向就变了。
2026 年 4 月 30 日,Cursor 自己发了一篇文章讲怎么持续改进 Agent Harness(作者 Stefan Heule 与 Jediah Katz)。里面坦白得很直接:早期因为模型不会挑上下文,他们堆了大量护栏——每次编辑后强制把 lint 和类型错误塞回上下文、模型读得太少就重写它的文件读取、甚至限制单轮能调用的工具数量上限。文章里那句总结是:“That is mostly long gone.”(这些基本都没了。)
2026 年 7 月下旬,Claude Code 团队的 Thariq 发了一条帖子:为了适配新一代模型,他们把 Claude Code 的系统提示词删掉了大约 80%,新模型照样干得好。
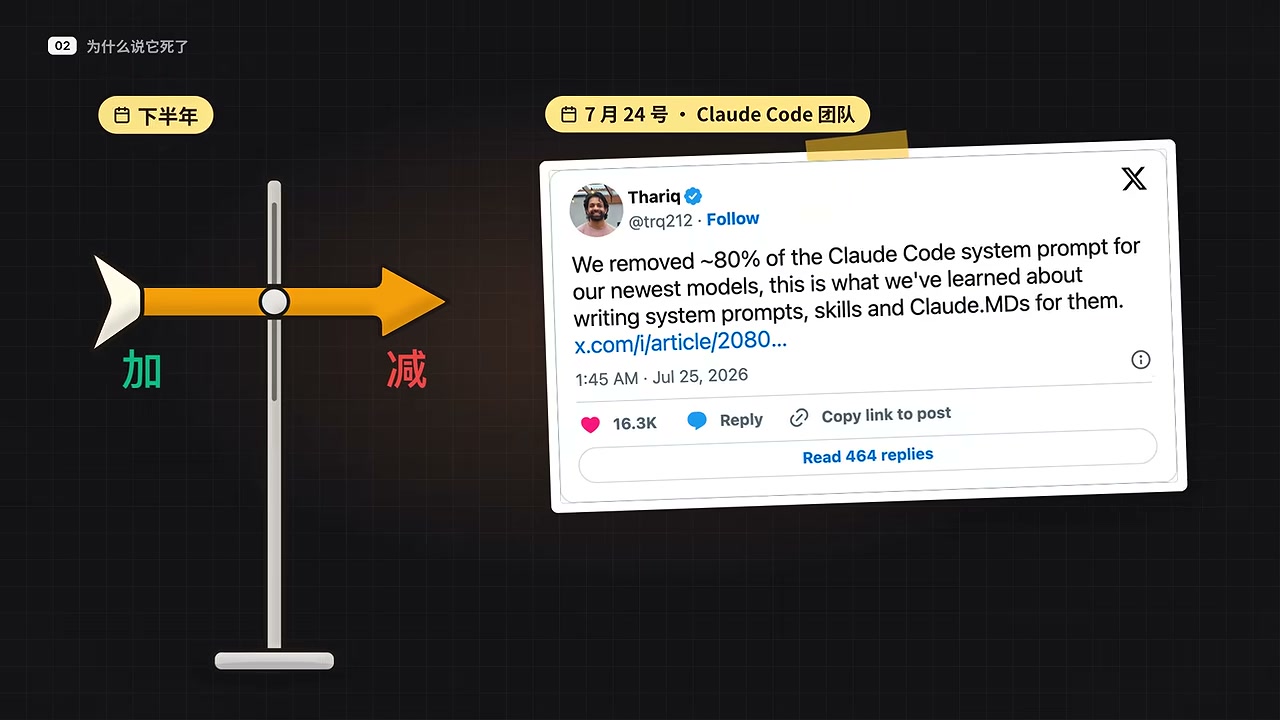
结论很清楚:Harness 已死不是一句空话,最懂 Harness 的那几家都在做减法。
四、第二组证据:HarnessTax 实测——21 组组合,分数几乎不动,钱差一倍
但「都在做减法」只是动机,得看数据。2026 年 9 月 16 日,UC Berkeley 和 Arena 团队放出了 HarnessTax 研究,问题很朴素:同一个模型换一个 Harness,能不能多做对几道题,或者少花点钱?
实验设计相当克制:7 个模型 × 3 个 Harness = 21 组组合,评测栈固定,只换 Harness,跑 SWE-bench Lite 和 Terminal-Bench 2.0 两套公开编程测试。三个 Harness 分别是 Claude Code、OpenAI 的 Codex CLI,以及开源的极简工具 Pi——Pi 的全部家当只有四个工具:读文件、写文件、改文件、跑命令。
结论有三条:
第一,换 Harness 对做对多少题影响很小。 SWE-bench Lite 上平均差异在 2 个百分点以内,Terminal-Bench 2.0 上在 5 个百分点以内。
第二,对花多少钱影响很大。 同一个模型下,Claude Code 的成本约为 Pi 的 2.0 倍、Codex 的 1.6 倍(SWE-bench Lite),在 Terminal-Bench 2.0 上约为 Pi 的 1.5 倍。
第三,最扎眼的一组数据是同一个最强 Claude 模型:
| Harness | 做对率 | 每次尝试成本 |
|---|---|---|
| Claude Code | 97.8% | $1.33 |
| Codex CLI | 96.7% | — |
| Pi | 96.7% | $0.67 |
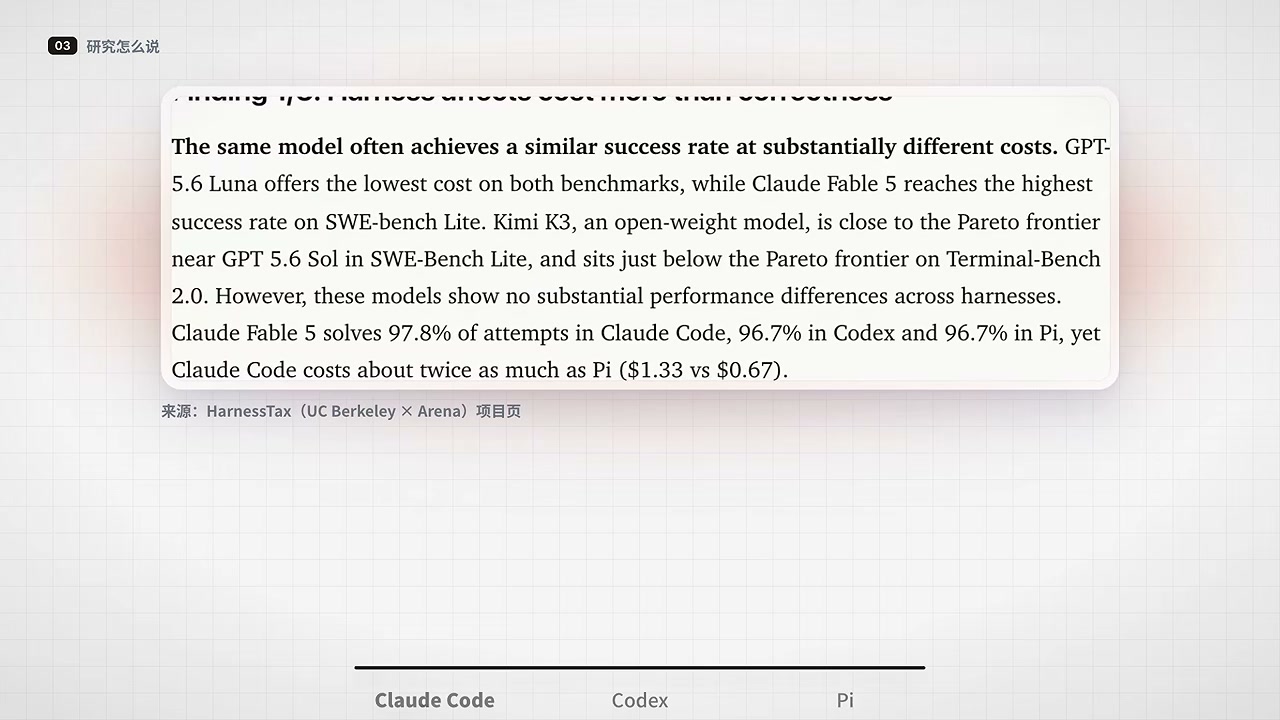
差了 1.1 个百分点,约等于每 90 道题多对一道;但贵了整整一倍。
钱贵在哪?机制就写在数据里:Claude Code 第一次调用模型时塞进去的内容,平均是 Pi 的 10 倍还多——更长的说明书,更多的工具定义。相当于还没开始干活,先读了十倍长的说明书。
Portkey 在今年 4 月那篇把开销量得更细:同一个任务,Pi 大约花 2,600 个输入 token,Codex 约 15,000,Claude Code 约 27,000;在 40 轮的长会话里,Claude Code 烧掉约 112 万输入 token,将近一半是 harness 自己吃掉的,跟你的任务无关。
这份额外开销有个名字:harness tax——Agent 花在「自己身上」而不是你的任务上的那部分成本。
五、第三组证据:EPFL 的 MLE 实验——精心搭的机器,打不过一个极简 Agent
第二项研究来自瑞士洛桑联邦理工(EPFL),2026 年 9 月 30 日挂到 arXiv:How Much of a Harness Does a Strong Agent Need for Autonomous ML Engineering?(Kirill Brilliantov、Alejandro Hernández-Cano、Emmanuel Abbé)。
它测的是让 AI 自己做机器学习工程(MLE)。这个方向的 Agent 外面往往套着一大堆机器:多 Agent 编排器、专门的检索子 Agent、一堆规则和护栏。
论文的结论是:在同等时间预算、同一个前沿模型骨干下,开源的 SOTA harness 相比「一个只会读、写、跑 bash 的极简 coding agent 单会话」没有任何优势——瓶颈在骨干模型,不在机器层。他们用一系列大规模消融实验论证,机械层在 coding agent 场景里是冗余的。
两个团队、两个完全不同的领域、同一结论。写代码和做机器学习工程这两格,飞轮都已经转完一圈。
不过也得说清楚反面。有研究指出,在长任务上只换 Harness 不换模型,Terminal-Bench 2 的 pass@1 能从 69.7% 变到 77.0%,还有 benchmark 报告脚手架本身能带来 15 个百分点的波动。两边不矛盾,区别在于测的是不同的距离:收敛结论比的是「几家主流 CLI 之间」,发散结论比的是「一个搭得好的 Harness」和「一个裸的、调歪的 Harness」。Cursor 自己的总结更直白:那些行为一旦变成模型的原生能力,当初打的补丁就不再值回它的复杂度。
六、数据飞轮:为什么「写代码」这一格已经转完一圈
上面那些减法背后是同一个机制,业内叫数据飞轮(data flywheel):
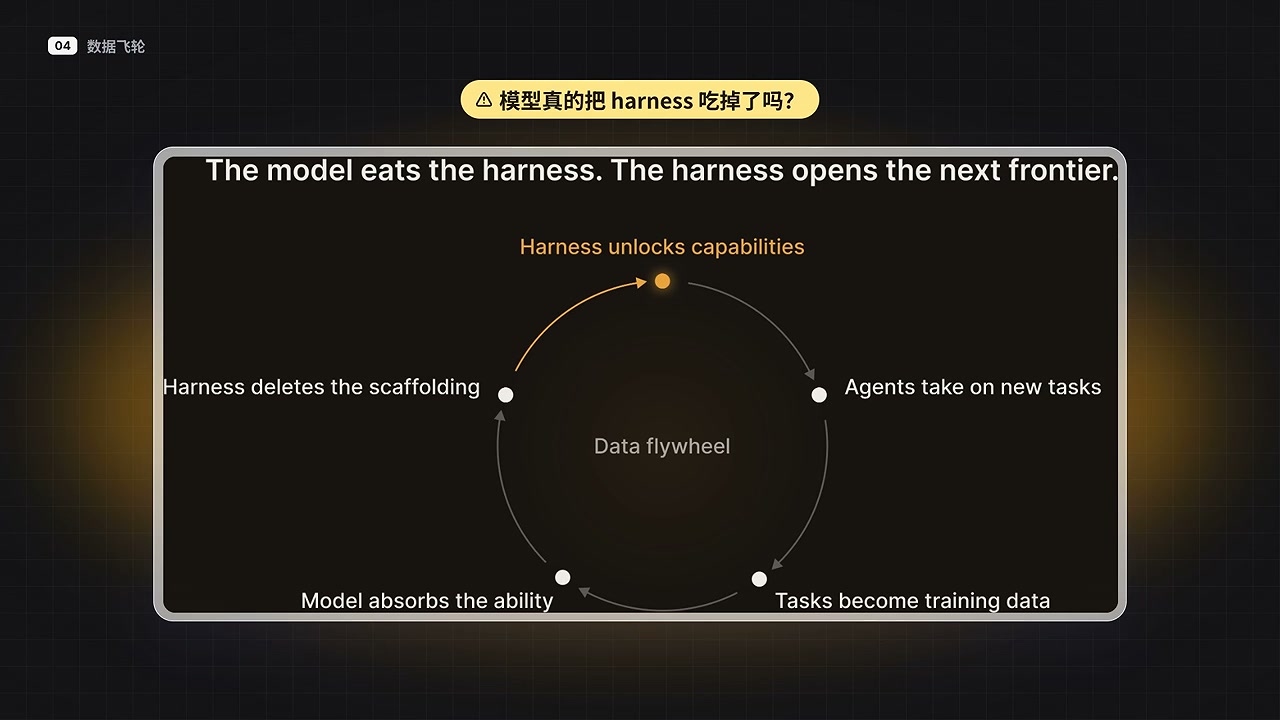
- Harness 先帮模型解锁能力。 模型自己做不到的事,靠提示词、工具、护栏先把它扶起来,让它能接下更难的活。
- Agent 接手新任务。 能做了,用的人就多了。
- 这些任务变成训练数据。 每天让 Agent 写代码的过程,都流向做模型的实验室。
- 模型把能力学进去。 怎么在陌生代码库里找东西、怎么连着干几小时不跑偏、改完代码怎么自己跑测试检查——以前都得在 Harness 里一条条教,现在模型自己就会了。
- Harness 把当初那些脚手架删掉。 然后飞轮回到第一步,去找下一个模型还不会的地方重新扶一遍。
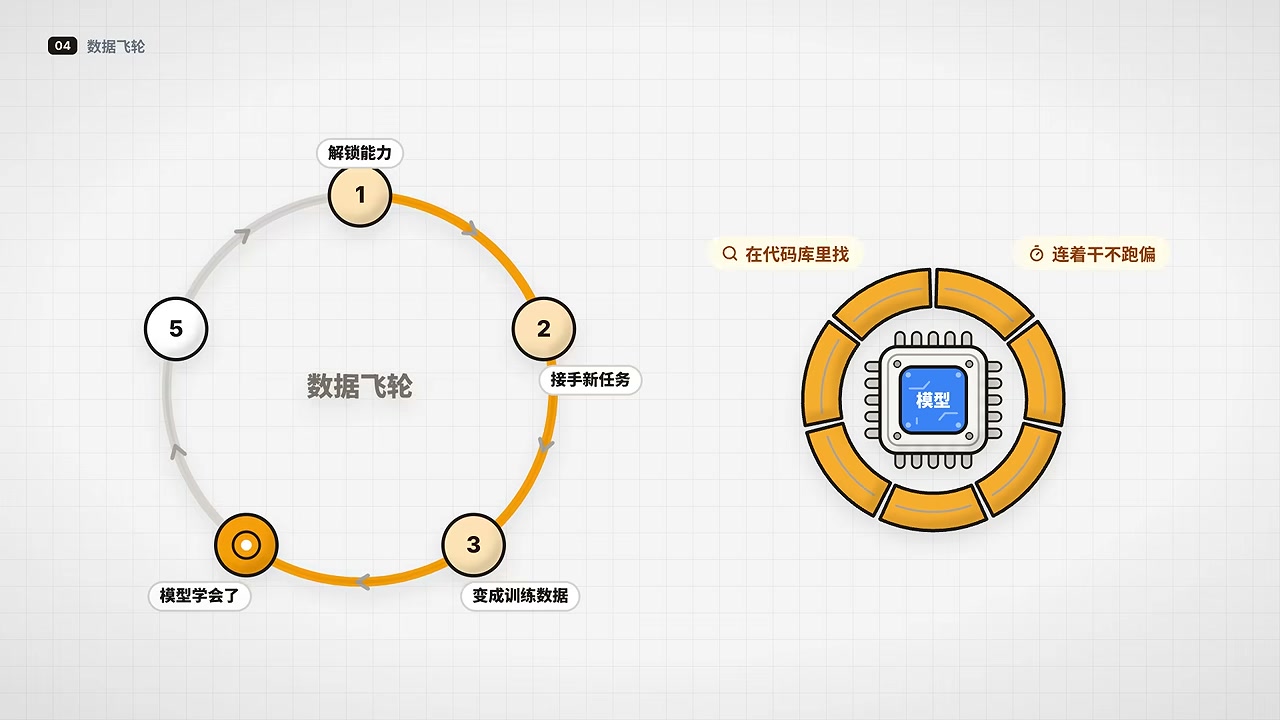
所以「写代码的 Harness 越来越薄」不是失败,是它的活干完了。Cursor 那位负责人自己的说法是:模型变聪明让 Coding Agent 的 Harness 经历了一段停滞期,现在飞轮又回到了起点。
顺带一提,这套机制解释了一个反直觉的现象:产品需求经常跑在模型能力前面,所以 Harness 会先变胖再变瘦——模型追上来了,脚手架就该退休。
七、同一个逻辑的反面:Grok Bot 为什么在往回加护栏
如果 Harness 真的只会越来越薄,那在它下面做出来的所有产品都该一起变简单。现实相反。
2026 年 8 月 11 日,SpaceXAI 发布 Grok Bot 早期测试版:AI 队友有自己的电脑,登录你的各种工具,像你一样去用,再把做完的活交回来。
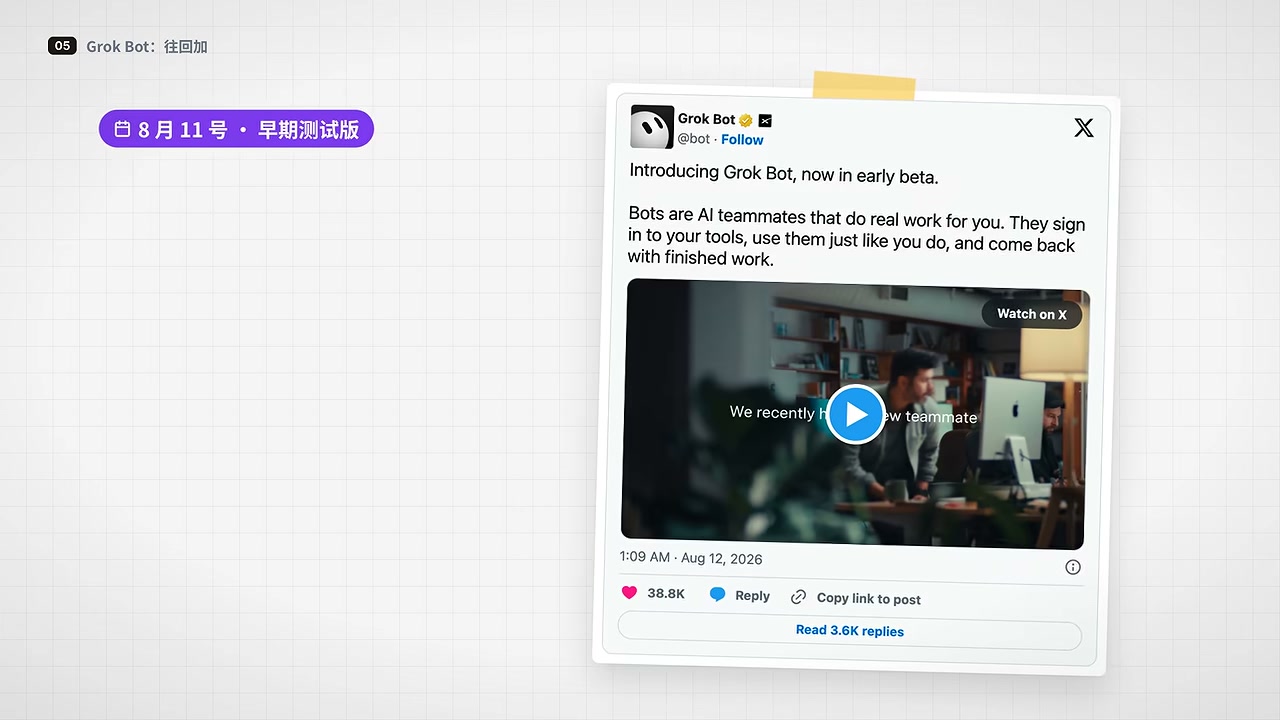
它干的不是写代码,是办公室里的各种活:做幻灯片、订机票、给同事发邮件。
正因为模型还没拿下这些新领域,他们在 Grok Bot 上做的事,和当年在 Cursor 上正好相反——一条条把提示词和护栏加回去:
- 网页上的流程怎么走:做 PPT、订机票这类任务,需要可靠地跟外部系统打交道。
- 多久跟你汇报一次进度:既让你知道它在干什么,又不至于一直打扰你。
- 什么时候自己直接做、什么时候先停下来问一句:给同事发邮件这种事,你希望它做,但得按你想的那样做。
- 记忆:系统要能慢慢学会你这个人怎么干活。
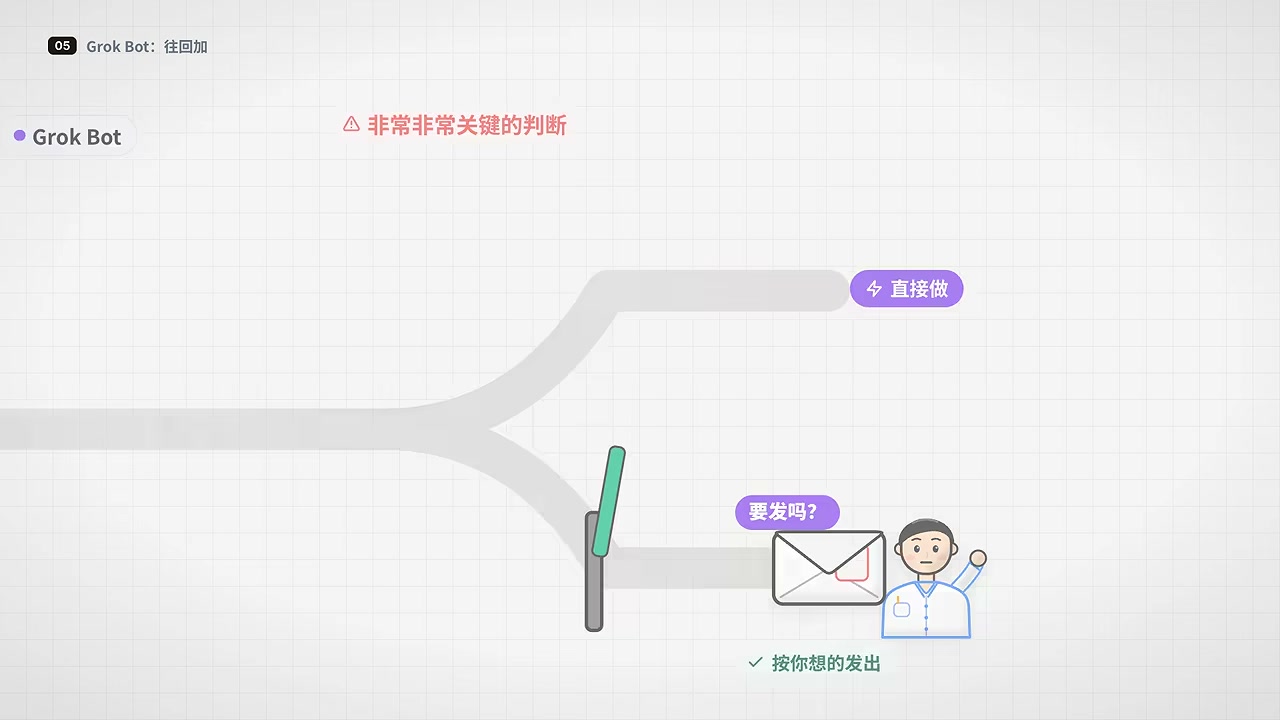
结构也不一样了:长期在线的协调者指挥一群干活的 Agent,不再是「一次请求一个聊天窗口」。打个比方,像请了一个很厉害的律师,直接跟你对接管大方向,具体的活分给手下一群助理。
所以 Harness 的价值是分领域的:飞轮到哪,哪儿的 Harness 就变薄;模型还没学会的地方,Harness 就在变厚。同一套逻辑,两个方向。
八、模型吃不掉的三件事
在 Grok Bot 这种新领域,Harness 还要继续加。但有三件事,无论模型多强都吃不掉——它们本来就属于模型外面那一层:
第一,在哪跑。 Agent 干一个任务,从几分钟变成了几小时、几天甚至更长。这种活不可能挂在你的笔记本上:你一合盖,电脑睡了,它也就断了。这需要云端的机器、状态的保存、断了能接着跑。这是基础设施,不是智能。 智能再强也没法让一个断电的进程继续活着,也变不出从没存下来的状态。SpaceXAI 的判断更直接:六个月内,90% 的 Agent 工作会跑在笔记本之外。
第二,能碰什么。 前面那个「一个 shell 加所有密钥」的极简 Harness,跑编程题确实不差。但你大概不会想把所有密钥塞进一个文件交给模型——就算你自己无所谓,你们公司管安全的人肯定有话讲。谁也不想某天早上醒来,发现 Agent 干了一件没法挽回的事。所以每个 Agent、每个人能动什么,得有人来划线,这件事只能在 Harness 里做。提示词能影响行为,但只有 Harness 能控制实际可用的凭据和动作。
第三,花多少钱。 成绩追平了,成本没有追平。Grok Bot 团队自己过去一个月一直在优化缓存命中率、Token 用量和模型搭配,成本和速度都降下来了,质量没掉。你越多地用 Agent 干活,这一层就越值钱。 一个小差异,Agent 偶尔跑一次时无所谓;当 Agent 接手日常工作的一大部分,它就变成实打实的产品和基础设施问题了。
这三件事跟模型聪不聪明没关系。分数可以收敛,运行时、权限和账单不会。
九、以后的 Harness 长什么样
方向很明确,大致两条。
方向一:从「拼模型调用」变成「拼 Agent」。 过去 Harness 是把一堆模型调用编排起来,以后编排的最小单元是一个 Agent,每个子 Agent 有自己的上下文、工具和执行循环,上层负责派活和生命周期。Cursor 内部有个例子很能说明这种架构:
有人在群里报了一个 bug → 自动分诊 → 拉起一个云端 Agent 去修 → 修完录一段修复前后的对比视频当证据 → 代码合并上线后,再拉起一个 Agent 盯着线上有没有出问题。
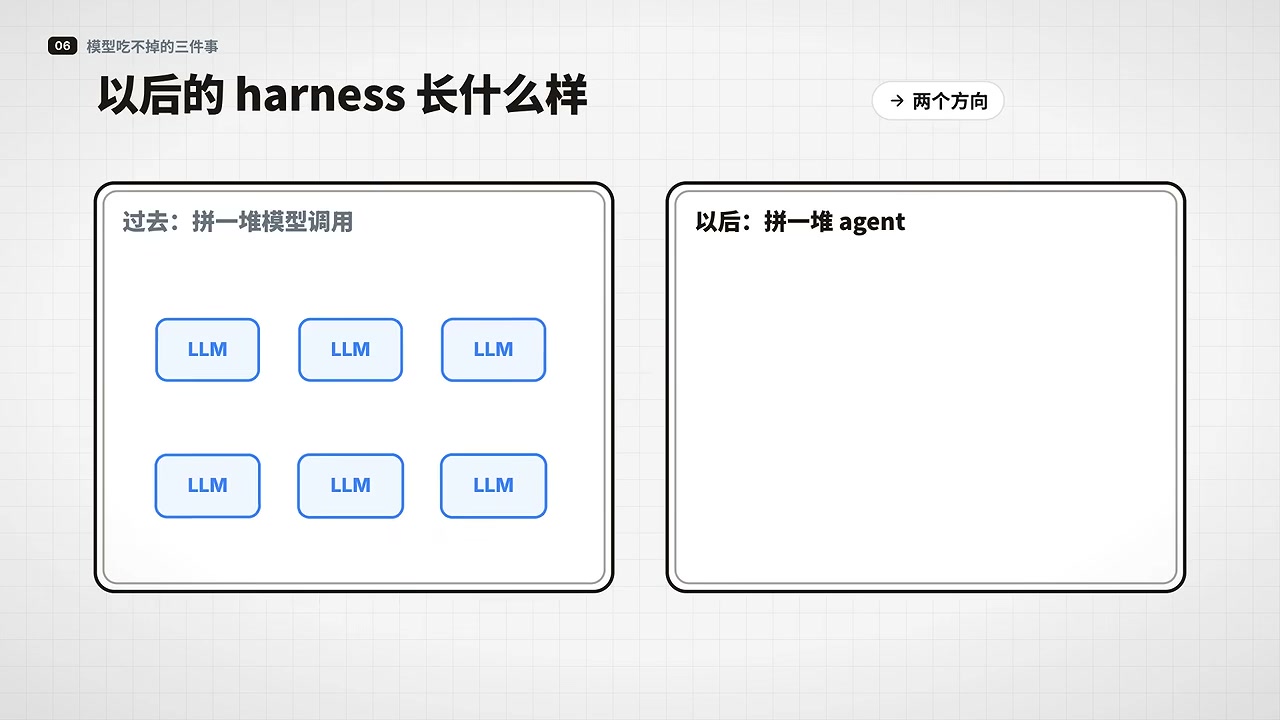
没有任何一次模型调用能独占整个生命周期。这种「由 Harness 组成的 Harness」被称为 meta-harness。
方向二:内部越来越复杂,给用户看到的越来越少。 暴露出去的每个细节都会有人依赖(Hyrum 定律),以后就改不动了。所以 Harness 要学会把内部机制藏起来,同时提供可组合的原语,比如统一的「订阅原语」:Agent 需要在有人发 Slack 消息、某个 PR 的 CI 挂了、或者到了某个时间点被唤醒时,不必为每种事件源写一套集成。
配套的还有「退役机制」:临时性的行为补丁被称为 shim,团队集中登记并记录每一次触发;再用一个盯着看板的 Bot,在某个 shim 不再触发时自动开 PR 提议删掉它。脚手架的退出也自动化了,模型进步之后可以直接删代码,而不是留下一堆化石化的护栏。
十、落到你自己身上:两条今天就能做的动作
前面这些如果只停留在概念层面就没意义了。真正能改变你账单和体验的,是两件小事。
第一,把你给 AI 写的规则、要求、踩过的坑,尽量写成普通文件,放在你自己的项目里,而不是只存在某一个工具的设置里。 这样明天换一个 Harness,这些东西跟着你走——这正是 Garry Tan 说的「胖技能、薄 Harness」。我自己在 Pi 还是 Oh My Pi:极简内核与开箱即用 fork 的取舍 里选工具时,唯一不带走的判断标准也是这条:你的规则文件能不能原样搬过去。
第二,看一眼你的账单。 按量付费的,挑一个你平时常做的任务,同一个模型在两个工具里各跑一遍,看 Token 用了多少;包月的,看额度用得快不快。差别可能比你想得大——上面那组数据里,同样的成绩一边贵一倍。自己跑一遍比任何榜单都准,因为公开数字测的是别人的任务。想看一个真实账单长什么样,可以参考 MiniMax M3.1 Flash 三周烧掉 70 亿 Token 的实测。
顺带一句:工具层同样要选可移植的格式。纯文本规则、Markdown 技能文件、REA 这类走开放协议的 MCP 工具,才是换 Harness 时能带走的东西。
总结
「Agent Harness 已死」是一句被简化过头的话。
在写代码这一格,它确实在退场。 HarnessTax 的 21 组对比里,做对题数几乎不动,成本却能差两倍;EPFL 那篇 MLE 实验同样没测出复杂编排的优势。原因不是 Harness 没用了,而是它扶起来的那部分能力,已经被数据飞轮烧进了模型权重——脚手架完成了历史使命,自然就该拆。
但有三件事它永远吃不掉: 在哪跑、能碰什么、花多少钱。这是基础设施、权限边界和运营经济学,不是智能问题。
而在模型还没拿下的新领域,Harness 还在往回加护栏。 Grok Bot 干的事和当年 Cursor 干的事正好相反,这不是矛盾,而是同一套逻辑的两个方向。
对你来说,结论可以压缩成一句:工具可以换,Harness 可以薄,但你自己的规则、记忆和技能文件才是资产。 把它们写成普通文件放进你自己的项目,然后花一个下午测一测——你到底在为哪一层付钱。
本文的数据来自三组公开研究与厂商一手资料:HarnessTax(UC Berkeley 与 Arena,2026-09-16)、EPFL 的 MLE harness 论文(arXiv:2609.40303,2026-09-30),以及 Cursor、SpaceXAI 的官方博客与公告;另外参考了 AQ 的 harness tax 综述 与 Agent Harness 公开演讲的文字整理。文中所有百分比与成本数字均取自上述来源,不同任务与模型上的结论会有差异,选购前请用自己的真实任务再测一遍。
如果你也踩过「同一个任务换个工具账单翻倍」的坑,欢迎在评论区贴出你的对比;觉得有用可以收藏,或者先看看 Pi 与 Oh My Pi 的工具取舍 和 MiniMax M3.1 Flash 的 Token 实测。